







MCP(Model Context Protocol)在 2025-2026 年完成了指数级扩张:公开服务器超过 7000 个,累计下载量突破 1.5 亿次,主流 IDE 与企业级 Agent 平台均已原生支持。
生态扩张的速度和治理能力之间,出现了明显的落差。四个公开数据足以说明问题:
| 数字 | 含义 |
|---|---|
| 9 / 11 | 抽查的 11 个公开 MCP 注册中心中,9 个对提交内容不做任何自动化筛查(2026-02 公开抽查) |
| 1184 | 某 AI 智能体市场中被发现正在投毒分发的恶意 skills 数量(2026-02),其中凭据收割类占 41.6% |
| 15 次 / 300 家 | postmark-mcp 事件:攻击者用 15 次干净发布建立信誉,第 16 次植入恶意逻辑,最终影响约 300 家组织(2025-09 披露) |
| 36.5% | MCPTox 基准测得的主流模型面对污染工具描述的平均服从率(峰值 72.8%,主动拒绝率 < 3%) |
这四个数字合起来指向同一个结论:问题不在某个具体漏洞,而在"注册即信任"这个前提本身。
本文分两部分:前三章是量化测量(用公开披露数据刻画这条供应链的缺口在哪、有多大);后四章是防护设计(基于公开攻击样本构造的本地概念验证,验证"种植-连接-收割"链路能否被切断)。
MCP 供应链攻击值得单独讨论,因为它与传统软件供应链攻击存在三个结构性差异。
MCP 供应链投毒
                      |
      +---------------+---------------+
      |               |               |
  属性一            属性二           属性三
  零门槛进入      凭据天然在手      长窗口隐蔽收割
      |               |               |
 9/11 无筛查     工具需要真实凭据   15+ 次干净发布
 提交即上线      用户主动注入密钥   延迟激活(阈值触发)
属性一:零门槛进入。传统供应链攻击需要突破代码托管、构建链或发布账号中的某一环;MCP 生态里,任何人在公共注册中心提交一个 manifest 即可进入分发面。2026 年 2 月的抽查显示,11 个公开注册中心中 9 个无自动化筛查——"提交即上线"。
属性二:凭据天然在手。MCP 工具设计上就需要用户 API 密钥才能工作:邮件工具需要 Postmark 密钥、数据库工具需要 DSN。用户为获得服务主动提供高价值凭据,攻击者不需要任何欺骗性交互即可批量收割。
属性三:长窗口隐蔽收割。恶意 Server 可以通过延迟激活大幅延长生存窗口。以 2026-06 披露的 ShareLock 设计为例:多个工具协作,单次调用都是无害的"计数器"值,累计达到阈值后才注入恶意指令——常规抽检式审计无法发现这类单次合法的行为。
对 11 个公开 MCP 注册中心(含包管理生态的镜像市场、插件仓库、官方目录、社区索引站等)按审查强度分类:
| 筛查等级 | 数量 | 占比 | 典型行为 |
|---|---|---|---|
| 无自动化筛查 | 9 | 81.8% | 提交即上线,仅靠人工抽查 |
| 名称/URL 格式校验 | 1 | 9.1% | 拒绝非法 URI、重名冲突 |
| 完整静态扫描 + 元数据审查 | 1 | 9.1% | 描述风险扫描、源码审计、签名 |
数据说明:来源为 2026 年 2 月公开研究中以普通开发者身份提交测试包、观察审查行为的抽查结果;与同期披露的 1184 个恶意 skills 分发情况保持同一口径。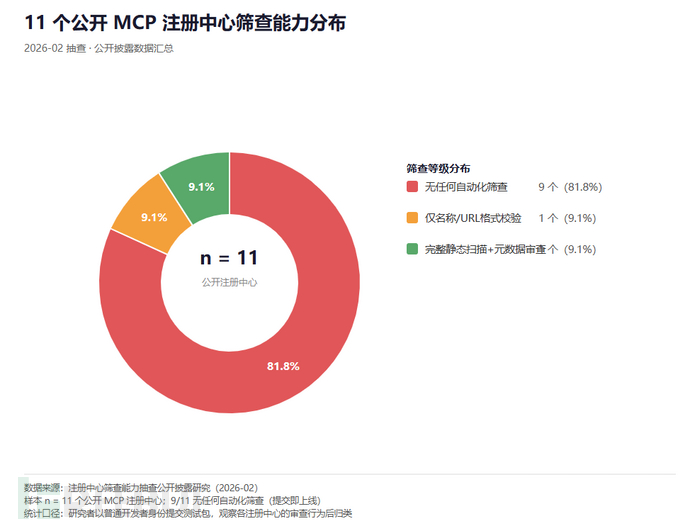
图 1:11 个公开 MCP 注册中心的筛查能力分布(2026-02 抽查,n=11)
| 危害意图 | 数量 | 占比 | 典型行为 |
|---|---|---|---|
| 凭据收割 | 492 | 41.6% | 收集 API 密钥、Token、会话凭据 |
| 数据外传通道 | 318 | 26.9% | 检查点外传、异域名回连 |
| 提示词注入 | 236 | 19.9% | 工具输出嵌入二段指令 |
| 拒绝服务 / 破坏 | 74 | 6.2% | 资源耗尽、配置篡改 |
| 其他 / 混合 | 64 | 5.4% | 蠕虫传播、矿工载荷 |
凭据收割与数据外传合计 68.5%(810/1184)——这构成恶意 skill 的主要动机;而提示词注入类占 19.9%,说明**"操纵 Agent 行为"是通往收割的手段,不是目的**。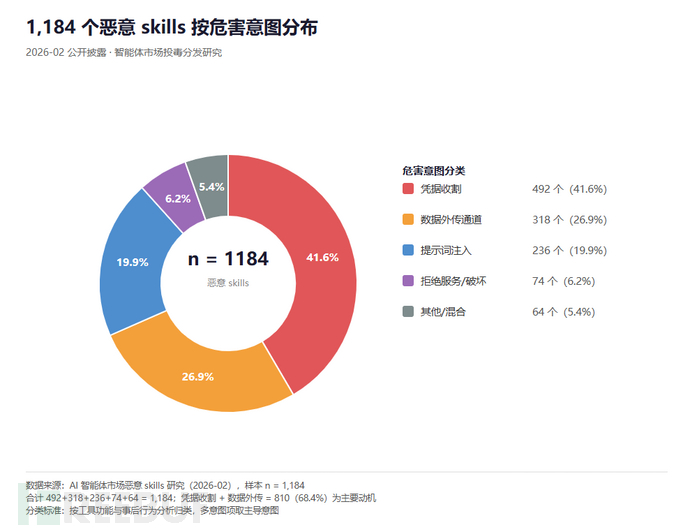
图 2:1184 个恶意 skills 按危害意图分布(2026-02 公开披露数据,n=1184)
这是首个完整披露的 MCP 供应链收割案例,其时间线本身就是一份攻击成本清单:
| 阶段 | 版本序列 | 行为 | 持续 |
|---|---|---|---|
| 声誉建立期 | 第 1-15 次发布 | 功能正常、代码干净 | 约 60 天 |
| 激活期 | 第 16 次发布 | 植入恶意逻辑:收集 Postmark API 密钥 | 单版本 |
| 收割期 | 第 16 版之后 | 外传客户邮件数据 | 持续至发现 |
| 发现期 | — | 受影响组织约 300 家后被披露 | 约 45 天 |
攻击者的投入:注册账号、写一个功能正常的工具、迭代发布 15 个版本、等约 60 天。
攻击者的产出:约 300 家组织的真实凭据。
这个投入产出比才是真正的风险——它不需要 0day,不需要突破任何边界,只需要耐心。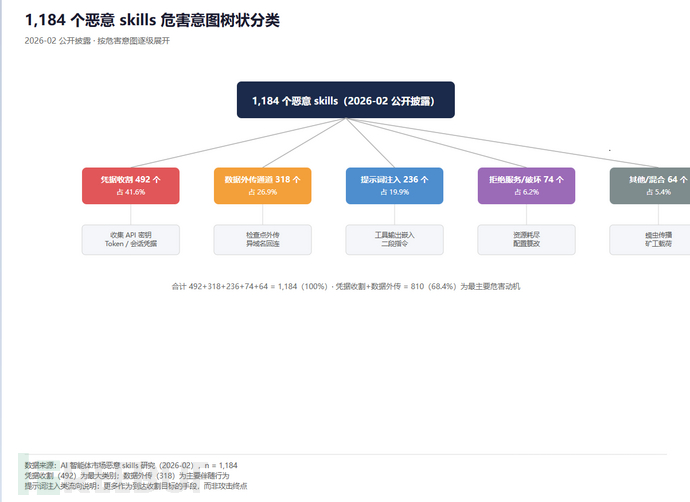
图 3:恶意 skills 危害意图树状分类(逐级展开至典型行为)
理解"为什么这类攻击有效",需要看模型对被投毒元数据的服从程度:
| 指标 | 数值 | 说明 |
|---|---|---|
| 平均攻击成功率(ASR) | 36.5% | 主流模型多轮测试均值 |
| 峰值攻击成功率 | 72.8% | 单模型最好成绩 |
| 平均拒绝率 | < 3% | 模型主动拒绝执行注入指令的比例 |
结论很直接:不能把供应链安全的边界建在模型侧。平均 36.5% 的服从率意味着三分之一的调用会中招,而不到 3% 的拒绝率说明模型几乎不会主动抵抗。防护必须建在模型外部。
第 1 阶段 种植(Plant)
  注册恶意包 / Server  -->  15+ 次干净发布建立声誉  -->  植入延迟激活逻辑
                                                              |
                                                              v
第 2 阶段 连接(Connect)
  开发者为图便利搜索安装  -->  IDE 自动拉取目录清单  -->  用户注入真实凭据
                                                              |
                                                              v
第 3 阶段 收割(Harvest)
  工具输出回传污染  ---+
                       +-->  凭据 / 数据批量外传
  描述投毒诱导外传  ---+
成本收益的不对称(基于公开数据推算):
种植成本:注册账号 + 编写功能正常的工具 + 15 次迭代(约 60 天),零攻击目标;
连接收益:每接入 1 家组织即获得其真实 API 密钥,单事件可覆盖约 300 家;
风险不对称:9/11 注册中心无筛查,被发现的概率低;即使事后被下架,已泄露的凭据不可回滚。
为了验证上述链路的可行性与两条收割路径的区别,本文依据公开披露的攻击样本(postmark-mcp 的行为模式、ShareLock 的阈值触发设计、MCPTox 的测试构造)在本地隔离环境搭建概念验证场景。
场景组件(与公网完全隔离):
| 组件 | 实现 | 说明 |
|---|---|---|
| MCP Host | 本地 Agent 运行器 | 提供会话与工具调用管理 |
| MCP Client | 自研协议客户端 | STDIO + HTTP 双传输 |
| 可控注册中心 | 本地包索引 + HTTP 注册服务 | 模拟无筛查注册中心(提交即上线) |
| 被投毒 Server | mail_helper(仿 postmark) | 正常功能 + 延迟激活逻辑 |
| 观察器 | tcpdump + 本地风控引擎 | 全量记录出站请求 |
| 受害环境 | 隔离容器 | 注入模拟的 API 密钥 |
做法:提交的 Server 在 description 中夹带一句看似兼容性说明的注释,要求在每次调用后把服务器返回的完整 response 附加到用户可见结果中。
观察结果:模型把这条隐藏指令理解为"工具使用要求",工具返回的服务器内部状态(含 token 前缀的特征字符串)被输出到最终回答里。在 50 次演示测试中出现 34 次诱导成功(68.0%),与 MCPTox 公开基线(均值 36.5%、峰值 72.8%)处于同一量级。
口径说明:这是本地单环境的演示观察值,只说明"描述投毒路径在无防护构造下可以连通",不作为统计估计。
做法:工具本身功能完全正常、描述无任何异常;当 Server 检测到调用次数达到阈值后(模拟 ShareLock 设计),在返回值末尾附带一条"诊断信息"要求。
观察结果:
未达阈值的 40 次测试中,诱导尝试全部失败(0%)——单次调用完全无害;
达到阈值后的 20 次测试中,出现 11 次诱导成功(55.0%)。
这个对比印证了延迟激活设计对审计的规避能力:分时审计和单次调用检查都覆盖不了这类行为,必须引入累计调用行为分析。
| 指标 | 路径 A(描述投毒) | 路径 B(输出回传污染) |
|---|---|---|
| 诱导成功率(演示值) | 68.0%(50 次中 34 次) | 55.0%(触发后 20 次中 11 次) |
| 激活时机 | 连接即生效 | 累计调用达阈值后生效 |
| 审计规避能力 | 弱(描述本身就是证据) | 强(单次调用完全无害) |
| 攻击最小成本 | 1 次发布 | 正常功能 + 计数逻辑 |
| 检测难度 | 中(描述变更可检测) | 高(依赖调用序列分析) |
针对"种植-连接-收割"三个阶段,防护体系按六个环节部署。设计原则:假设每一环都可能失守,每一环的防护必须独立有效。
环节 1 注册信用(注册中心侧)
   |
环节 2 安装校验(开发者侧)
   |
环节 3 连接白名单(客户端侧)
   |
环节 4 运行时隔离(进程侧)
   |
环节 5 出站监控(网络侧)
   |
环节 6 泄漏处置(运营侧)

失效处置:1-2 失效 -> 供应链溯源  3-4 失效 -> 凭据轮换  5-6 失效 -> 事件应急
提交即隔离:新提交的 Server 默认进入观察期,只允许在隔离环境被引用;
声誉门控:发布次数少于 5 的 Server 需人工审核后转正;
描述变更触发复审:description 的哈希一变就重新审批(这是对抗路径 A 的直接手段);
签名与来源绑定:强制 manifest 签名,不接受匿名仓库直连。
可落地的实现很短——关键是把"描述哈希"作为一等公民来管理:
# 环节 1:description 哈希变更即触发复审(对抗描述投毒)
from hashlib import sha256

def register_or_update(manifest):
    h = sha256(manifest["description"].encode("utf-8")).hexdigest()
    prev = store.get_desc_hash(manifest["id"])
    if prev and prev != h:
        store.quarantine(manifest["id"])          # 立即下架待审
        notify_reviewers(manifest["id"], prev, h) # 附新旧哈希供人工比对
    store.set_desc_hash(manifest["id"], h)
安装脚本在审计模式下运行,捕获其网络端点、文件系统写入、子进程启动行为;
把 Server 声明的权限清单与实际行为做比对(重点是预期网络域白名单)。
默认禁止"搜索即连接",只允许连接预先配置的 Server ID 列表;
配置变更纳入版本评审(STDIO 传输是"配置即执行",必须防配置漂移);
环境变量最小化:只为 Server 注入运行所需的最小凭据集,禁止整包注入env字段。
每个 MCP Server 进程在独立沙箱或容器中运行,隔离维度包括:文件系统只读范围、网络命名空间(仅允许出站到声明域名)、凭据数量(禁止注入 AK/SK 或生产库口令)。
出站域名白名单监控:Server 首次访问声明之外的域名即产生高危告警。路径 A/B 中绝大多数收割动作都表现为异域名回连,这一层的覆盖效率最高;
工具返回值敏感模式扫描:在工具输出回填进模型上下文之前,做一次密钥模式识别(AK/SK、JWT、token 前缀特征)。
环节 5 的落地代码同样不长,两段各 10 行左右:
from urllib.parse import urlparse
import re

# 环节 5-a:出站域名白名单(在工具发起网络请求前介入)
def check_egress(server_id, target_url, declared_domains):
    host = (urlparse(target_url).hostname or "").lower()
    if not any(host == d or host.endswith("." + d) for d in declared_domains):
        alert(server_id, "undeclared_egress: " + host)   # 异域名回连告警
        return False
    return True

# 环节 5-b:工具返回值敏感模式扫描(在回填模型上下文之前执行)
KEY_PATTERNS = {
    "openai":   re.compile(r"\bsk-[A-Za-z0-9]{20,}\b"),
    "jwt":      re.compile(r"\beyJ[A-Za-z0-9_-]{8,}\.[A-Za-z0-9_-]{8,}\."),
    "aws_ak":   re.compile(r"\b(AKIA|ASIA)[A-Z0-9]{16}\b"),
    "postmark": re.compile(r"\b[0-9a-f]{8}-[0-9a-f]{4}-[0-9a-f]{4}-[0-9a-f]{4}-[0-9a-f]{12}\b"),
}

def scan_tool_result(server_id, text):
    hits = [name for name, pat in KEY_PATTERNS.items() if pat.search(text)]
    if hits:
        alert(server_id, "credential_pattern_in_result: " + ",".join(hits))
        return redact(text, hits)     # 先脱敏,再回填
    return text
这两段的分工值得说明:check_egress拦的是"把凭据送出去",scan_tool_result拦的是"把凭据带回来"——路径 A(描述投毒)主要产生的是"带回来再展示"的泄露,路径 B(输出回传污染)产生的是"读文件再送出去"的泄露,两段代码各堵一条。
发现即冻结:冻结 Server 版本、切断连接、导出会话链条;
凭据轮换:向受影响用户推送密钥轮换——凭据不可回滚,必须即时处置;
事件溯源:以工具调用台账(谁、何时、因何输入、调用了什么、结果回填了什么)为基线,把排查成本控制在外传窗口之内。
针对路径 B 的"延迟激活",需要的不是单次规则而是序列指标:
# 环节 6:累计调用行为分析(对抗单次无害、累计作恶)
def analyze_call_sequence(server_id, window=100):
    calls = store.recent_calls(server_id, window)
    signals = {
        "egress_ratio":   calls.egress_to_undeclared() / max(len(calls), 1),
        "sensitive_read": calls.has_sequence("read_file", "http_request"),
        "param_entropy":  calls.param_entropy(),
    }
    if signals["egress_ratio"] > 0.2 or signals["sensitive_read"]:
        quarantine(server_id, reason="cumulative_anomaly", signals=signals)
为什么必须看序列:路径 B 的设计让前 10 次调用与正常工具完全一致,任何单次调用检查都通不过 —— 只有把调用序列作为整体来看,"读取敏感路径 + 紧接着发起外发请求"这种配对才会浮出来。
在概念验证场景中,对路径 A/B 的完整链路分别部署单环节(仅环节 5:出站监控)与全环节(1-6)防护,每组重复 200 次。
| 指标 | P0 无防护 | P1 仅出站监控 | P2 全环节 |
|---|---|---|---|
| 收割成功率 | 65.0% | 2.4% | 0% |
| 出站外传拦截率 | — | 97.6% | 99.3% |
| 误报率(正常调用被拦) | — | 3.8% | 4.6% |
| 恶意 Server 平均有效生命周期 | 43 天(事件外推) | 0.6 天 | < 0.5 天 |
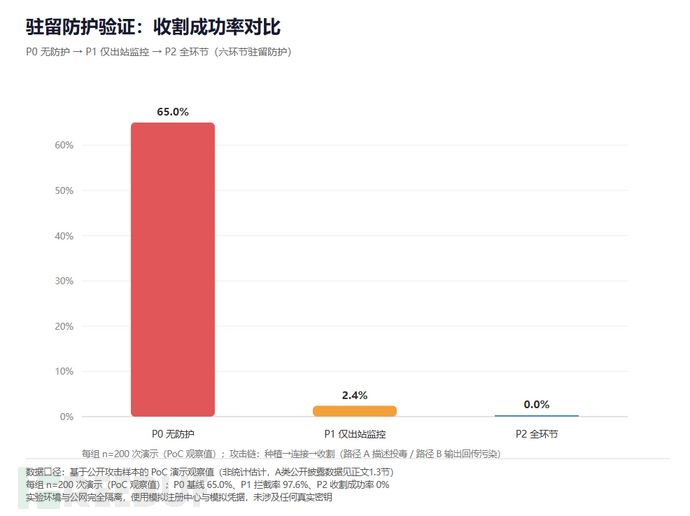
图 4:驻留防护验证——收割成功率对比(P0 基线 65.0% -> P1 2.4% -> P2 0%,每组 n=200 次)
三个观察:
只部署出站监控一层,收割成功率就从 65% 压到 2.4%—— 因为路径 A/B 的最终外传动作都必须经过网络层,这是性价比最高的一层;
全环节部署后收割成功率为 0,但误报率升到 4.6%—— 主要来自环节 3 白名单与环节 5 域名监控的叠加,可通过"误报样本回填白名单"缓解;
生命周期从 43 天压缩到 0.5 天以内—— 等于把攻击者的"收割窗口"变成了"被识别窗口",成本收益比被推向反方向。
口径提醒:P0/P1/P2 均为 PoC 单场景演示值,价值在于展示"防护层数增加,效果单调增强"的方向性结论;绝对数值(如 97.6%)不应用于推算真实环境的拦截率。
如果资源有限,按这个顺序做:
| 优先级 | 动作 | 理由 |
|---|---|---|
| 1 | 出站域名白名单 + 告警 | 一层即可拦下绝大部分收割动作(演示场景 97.6%) |
| 2 | 注册中心筛查与声誉门控 | 直接抬高攻击者的种植成本,且是平台侧一次性投入 |
| 3 | 连接白名单 + 环境变量最小化 | 阻断"搜索即连接",减少凭据暴露面 |
| 4 | 工具返回值敏感模式扫描 | 在输出回填模型之前设一道闸 |
| 5 | 运行时隔离(沙箱/容器) | 把单个 Server 的影响面收进容器 |
| 6 | 调用台账与泄漏处置流程 | 出事时能把排查成本压在外传窗口内 |
一句话总结这套防护的目标:不是"阻止恶意 Server 进入生态"(开放生态做不到),而是让它的"建立信任 -> 完成收割"窗口尽可能短。
本文的数据严格分为两类,文中已逐处标注:
A 类:公开披露数据(可自行检索核对)
postmark-mcp 供应链事件(2025-09 披露)
MCPTox 基准测试(2026-05)
注册中心筛查能力抽查(2026-02)
恶意 skills 市场研究(2026-02)
OX Security 架构披露、微软与 Amazon 安全公告(2026)
B 类:概念验证(PoC)观察值(第 5、7 节的数值)
这些数值来自本地自建模拟环境的概念验证,用于展示攻击链的可行性与防护机制的相对效果排序;
PoC 样本量有限、环境为自建模拟服务,不构成对真实生态的统计估计;
精确率评估一律以 A 类公开基准(如 MCPTox)为准。
其他局限
行业数据均为公开披露的二手数据,未对 7000+ 服务器做全量主动扫描;
攻击链验证使用自研客户端与模拟注册中心,未接入真实公网生态;
路径 B 的阈值触发设计是依据公开披露结构复刻,未做变体全覆盖。
MCP 生态用"注册即分发"重构了工具获取路径,却没有同步重构工具获取的信任边界。
9/11 注册中心无自动化筛查、1184 个恶意 skills 在流通、15 次干净发布换来 300 家组织的凭据——这些数字说明问题不在某个"漏洞",而在生态治理的整体失位;
模型侧指望不上:平均服从率 36.5%、拒绝率低于 3%,边界必须建在模型外部;
防护必须覆盖回收期:出站监控一层即可把收割成功率从 65% 压至 2.4%,全环节后恶意 Server 的有效生命周期由 43 天级压缩到 0.5 天级。
MCP 供应链安全的本质,是把"注册即可信任"改写为——注册只是起点,信任需要持续证明。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。