








本篇文章介绍 Halide 的 Vectorize, parallelize, unroll , tile 等优化策略。
本文来自于《Halide 官方教程》,读者可以去阅读原文。所以看本文的价值在于?呃…… 是中文的?(但原文肯定更准确)更简洁?(也许是缺点)画图更清楚?(假的,因为官网图更好,还是动图,我不想画了)。所以我也不知道为啥一定要看这篇文章而不是原文,唯一好处是我挑出了重点?官方教程文章太多,我只挑其中几篇重点,这是第一篇,全当自己记录了。
仍然建议看原文。
Halide 的 Vectorize, parallelize, unroll , tile 等优化策略与 TVM 的思路和写法基本相同,也是计算和调度分离的方式,是 AI 编译器中的重要内容。但是 TVM 的软件栈太大,学习较为困难,从 Halide 学习不失为一个好方法。
参考链接:《Halide 官方教程》
作为初学者,错误在所难免,还望不吝赐教。
Halide 是一种专门设计的领域特定语言(DSL),主要用于编写高性能的图像处理和数组计算程序。它由 MIT 和 Adobe Research 的研究人员于 2010 年左右开发,并因其在优化复杂图像处理流水线方面的卓越能力而受到广泛关注。Halide 的核心创新在于将算法(What to compute)与调度(How and when to compute it)明确分离。
Halide 通常作为 C++ 的嵌入式 DSL 使用。你用 C++ 编写程序,在其中定义 Halide 的函数和调度。
Halide 编译器会将 Halide 代码(算法 + 调度)编译成高效的 C++ 或 GPU 代码(如 CUDA, OpenCL, Metal),然后链接到你的主程序中。
它拥有一个强大的 JIT(即时编译)和 AOT(提前编译)编译系统。
Halide 的 Vectorize, parallelize, unroll , tile 等优化策略与 TVM 的思路和写法基本相同。这里依次展示不同优化策略对代码产生的影响。
Func gradient("gradient"); | |
gradient(x, y) = x + y; | |
gradient.trace_stores(); | |
printf("Evaluating gradient row-major\n"); | |
Buffer<int> output = gradient.realize({4, 4}); |
这是个简单的函数,将输入的 4*4 矩阵每个位置的行坐标和列坐标相加。输出 4*4 的结果。
默认的执行顺序:计算顺序是 x 为内层循环, y 为外层循环,行主序。
printf("Equivalent C:\n"); | |
for (int y = 0; y < 4; y++) { | |
for (int x = 0; x < 4; x++) { | |
printf("Evaluating at x = %d, y = %d: %d\n", x, y, x + y); | |
} | |
} |
追踪打印计算过程如下:
> Begin pipeline gradient.0() | |
> Tag gradient.0() tag = "func_type_and_dim: 1 0 32 1 2 0 4 0 4" | |
> Store gradient.0(0, 0) = 0 | |
> Store gradient.0(1, 0) = 1 | |
> Store gradient.0(2, 0) = 2 | |
> Store gradient.0(3, 0) = 3 | |
> Store gradient.0(0, 1) = 1 | |
> Store gradient.0(1, 1) = 2 | |
> Store gradient.0(2, 1) = 3 | |
> Store gradient.0(3, 1) = 4 | |
> Store gradient.0(0, 2) = 2 | |
> Store gradient.0(1, 2) = 3 | |
> Store gradient.0(2, 2) = 4 | |
> Store gradient.0(3, 2) = 5 | |
> Store gradient.0(0, 3) = 3 | |
> Store gradient.0(1, 3) = 4 | |
> Store gradient.0(2, 3) = 5 | |
> Store gradient.0(3, 3) = 6 | |
> End pipeline gradient.0() |
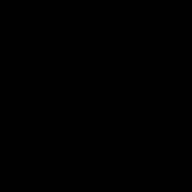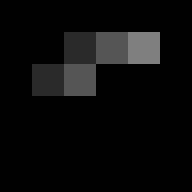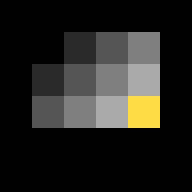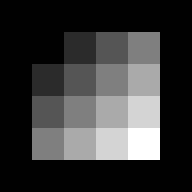
顺序重排,调整内外层循环的顺序,使用 gradient.reorder(y, x) 。
Func gradient("gradient_col_major"); | |
gradient(x, y) = x + y; | |
gradient.trace_stores(); | |
gradient.reorder(y, x); | |
printf("Evaluating gradient column-major\n"); | |
Buffer<int> output = gradient.realize({4, 4}); |
使用 C 表示为:其将 y 变成内层循环,x 变成外层循环。
printf("Equivalent C:\n"); | |
for (int x = 0; x < 4; x++) { | |
for (int y = 0; y < 4; y++) { | |
printf("Evaluating at x = %d, y = %d: %d\n", x, y, x + y); | |
} | |
} | |
printf("\n"); |
拆分,将一个变量拆分长两个。
Func gradient("gradient_split"); | |
gradient(x, y) = x + y; | |
gradient.trace_stores(); | |
Var x_outer, x_inner; | |
gradient.split(x, x_outer, x_inner, 2); | |
printf("Evaluating gradient with x split into x_outer and x_inner \n"); | |
Buffer<int> output = gradient.realize({4, 4}) |
gradient.split(x, x_outer, x_inner, 2) split 将 x 上的循环拆分成两个临近的循环 x_outer, x_inner ,最后一个参数 2 称为拆分因子(split factor),内循环 x_inner 会从 0 循环到拆分因子,外循环 x_outer 会从 0 循环到 x/split factor 。在循环内部,原来的变量 x 被定义为 x_outer * factor + x_inner 从而和原本的变量保持一致。假如旧的循环 x 并不是从 0 开始的,那么新的循环会将偏置单独加上。
对应的 C 代码如下所示:
printf("Equivalent C:\n"); | |
for (int y = 0; y < 4; y++) { | |
for (int x_outer = 0; x_outer < 2; x_outer++) { | |
for (int x_inner = 0; x_inner < 2; x_inner++) { | |
int x = x_outer * 2 + x_inner; | |
printf("Evaluating at x = %d, y = %d: %d\n", x, y, x + y); | |
} | |
} | |
} | |
printf("\n"); |
融合,将两个循环变量融合为一个。拆分的相反操作。它并不改变执行顺序
Func gradient("gradient_fused"); | |
gradient(x, y) = x + y; | |
Var fused; | |
gradient.fuse(x, y, fused); | |
printf("Evaluating gradient with x and y fused\n"); | |
Buffer<int> output = gradient.realize({4, 4}); |
上述代码将 x 和 y 循环融合为一个,用 C 可以表示为:
printf("Equivalent C:\n"); | |
for (int fused = 0; fused < 4 * 4; fused++) { | |
int y = fused / 4; | |
int x = fused % 4; | |
printf("Evaluating at x = %d, y = %d: %d\n", x, y, x + y); | |
} | |
printf("\n"); |
分块计算。有了 split 和 reorder 之后,就可以进行分块计算了。
Var x_outer, x_inner, y_outer, y_inner; | |
gradient.split(x, x_outer, x_inner, 4); | |
gradient.split(y, y_outer, y_inner, 4); | |
gradient.reorder(x_inner, y_inner, x_outer, y_outer); | |
printf("Evaluating gradient in 4x4 tiles\n"); | |
Buffer<int> output = gradient.realize({8, 8}); |
以上三步操作将 x 和 y 都拆分成连个循环,并通过 reorder 交换 y_inner, x_outer 的循环顺序,使内层循环为 x_inner, y_inner 。
当然,标准写法是:
gradient.tile(x, y, x_outer, y_outer, x_inner, y_inner, 4, 4); |
这一行操作等效于上述三步操作。
用 C 可以表示为:
printf("Equivalent C:\n"); | |
for (int y_outer = 0; y_outer < 2; y_outer++) { | |
for (int x_outer = 0; x_outer < 2; x_outer++) { | |
for (int y_inner = 0; y_inner < 4; y_inner++) { | |
for (int x_inner = 0; x_inner < 4; x_inner++) { | |
int x = x_outer * 4 + x_inner; | |
int y = y_outer * 4 + y_inner; | |
printf("Evaluating at x = %d, y = %d: %d\n", x, y, x + y); | |
} | |
} | |
} | |
} | |
printf("\n"); |
向量化。
拆分可以使得最内层循环 变成从 0 循环到固定的拆分因子。因此适合进行向量化加速。比如 X86 架构拥有 SIMD 指令,支持一次性计算 4 个数据宽的向量计算,此时就可以将最内层循环拆分成 4 个。
Func gradient("gradient_in_vectors"); | |
gradient(x, y) = x + y; | |
gradient.trace_stores(); | |
Var x_outer, x_inner; | |
gradient.split(x, x_outer, x_inner, 4); | |
gradient.vectorize(x_inner); | |
printf("Evaluating gradient with x_inner vectorized \n"); | |
Buffer<int> output = gradient.realize({8, 4}); |
上述操作将内层的拆分因子设置为 4,并进行向量化。
拆分 + 向量化足够常用,所以可以用以下一条指令代替上述两步操作:
gradient.vectorize(x, 4); |
对应的 C 代码表示 :
printf("Equivalent C:\n"); | |
for (int y = 0; y < 4; y++) { | |
for (int x_outer = 0; x_outer < 2; x_outer++) { | |
int x_vec[] = {x_outer * 4 + 0, | |
x_outer * 4 + 1, | |
x_outer * 4 + 2, | |
x_outer * 4 + 3}; | |
int val[] = {x_vec[0] + y, | |
x_vec[1] + y, | |
x_vec[2] + y, | |
x_vec[3] + y}; | |
printf("Evaluating at <%d, %d, %d, %d>, <%d, %d, %d, %d>:" | |
" <%d, %d, %d, %d>\n", | |
x_vec[0], x_vec[1], x_vec[2], x_vec[3], | |
y, y, y, y, | |
val[0], val[1], val[2], val[3]); | |
} | |
} | |
printf("\n"); |
循环展开。
如果多个像素共享重叠的数据,那么展开计算使共享值只计算或加载一次是有意义的。该做法类似于向量化。拆分一个维度,然后完全展开内部变量的循环。展开不会改变求值的顺序。
Func gradient("gradient_unroll"); | |
gradient(x, y) = x + y; | |
gradient.trace_stores(); | |
Var x_outer, x_inner; | |
gradient.split(x, x_outer, x_inner, 2); | |
gradient.unroll(x_inner); | |
printf("Evaluating gradient unrolled by a factor of two\n"); | |
Buffer<int> result = gradient.realize({4, 4}); |
上述内容将 x 拆分,最内层循环为 2,然后将最内层 完全展开。
更标准的写法:
gradient.unroll(x, 2); |
用 C 来表示:
printf("Equivalent C:\n"); | |
for (int y = 0; y < 4; y++) { | |
for (int x_outer = 0; x_outer < 2; x_outer++) { | |
{ | |
int x_inner = 0; | |
int x = x_outer * 2 + x_inner; | |
printf("Evaluating at x = %d, y = %d: %d\n", x, y, x + y); | |
} | |
{ | |
int x_inner = 1; | |
int x = x_outer * 2 + x_inner; | |
printf("Evaluating at x = %d, y = %d: %d\n", x, y, x + y); | |
} | |
} | |
} | |
printf("\n"); |
拆分时因子不能除尽的情况。
假如想要进行 split ,而总循环 x 不能被因子除尽时,会发生什么?
Var x_outer, x_inner; | |
gradient.split(x, x_outer, x_inner, 3); | |
printf("Evaluating gradient over a 7x2 box with x split by three \n"); | |
Buffer<int> output = gradient.realize({7, 2}); |
上述例子使用 3 作为拆分因子来拆 x ,显然 7 不能被除尽。
仔细阅读下述 C 语言表示:
printf("Equivalent C:\n"); | |
for (int y = 0; y < 2; y++) { | |
for (int x_outer = 0; x_outer < 3; x_outer++) { | |
for (int x_inner = 0; x_inner < 3; x_inner++) { | |
int x = x_outer * 3; | |
if (x > 4) x = 4; | |
x += x_inner; | |
printf("Evaluating at x = %d, y = %d: %d\n", x, y, x + y); | |
} | |
} | |
} | |
printf("\n"); |
从 C 代码中可以发现,有部分数据进行了重复计算。一些坐标计算了两次。这通常是可以的,因为纯 Halide 函数没有副作用,所以对同一个点求多次是安全的。
基本的规则是:
如果 x 的循环范围 是 [x_min, x_min+x_extent] 的话,则:
然而,如果编写的是具有更新定义的 Halide 函数,那么这种方式就是不安全的。
融合、切块和并行化。
处理 tile 并行,当你想要跨多个维度并行而不引入嵌套并行时,融合是有帮助的。
Func gradient("gradient_fused_tiles"); | |
gradient(x, y) = x + y; | |
gradient.trace_stores(); | |
Var x_outer, y_outer, x_inner, y_inner, tile_index; | |
gradient.tile(x, y, x_outer, y_outer, x_inner, y_inner, 4, 4); | |
gradient.fuse(x_outer, y_outer, tile_index); | |
gradient.parallel(tile_index); | |
printf("Evaluating gradient tiles in parallel\n"); | |
Buffer<int> output = gradient.realize({8, 8}); |
以上代码实现了 x 和 y 两个维度的拆分,得到最内层 4*4 的 tile 块。然后将最外层 x_outer, y_outer 进行融合,在融合后的维度上执行并行。
以下是 C 表示:
for (int tile_index = 0; tile_index < 4; tile_index++) { | |
int y_outer = tile_index / 2; | |
int x_outer = tile_index % 2; | |
for (int y_inner = 0; y_inner < 4; y_inner++) { | |
for (int x_inner = 0; x_inner < 4; x_inner++) { | |
int y = y_outer * 4 + y_inner; | |
int x = x_outer * 4 + x_inner; | |
printf("Evaluating at x = %d, y = %d: %d\n", x, y, x + y); | |
} | |
} | |
} | |
printf("\n"); |
本博客目前以及可预期的将来都不会支持评论功能。各位大侠如若有指教和问题,可以在我的 github 项目 或随便一个项目下提出 issue,并指明哪一篇博客,我看到一定及时回复!
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。