


ELK似乎是当前最为流行的日志收集-存储-分析的全套解决方案.
去年年初, 公司里已经在用, 当时自己还山寨了一个统计系统(postgresql-echarts, 日志无结构化, json形式存储到postgresql, 构建统一前端配置生成, 调用统一查询接口, 具体细节), 已经过了一年有余.
一年刚好, 发生了很多事, 那套系统不知现在如何了.
在新的公司, 一切都得从0到1, 近期开始关注日志/数据上报/统计, 以及后续的数据挖掘等.
搭建, 测试并上线了一套简单的系统, 初期将所有服务器的nginx日志, 以及搜索日志进行处理.
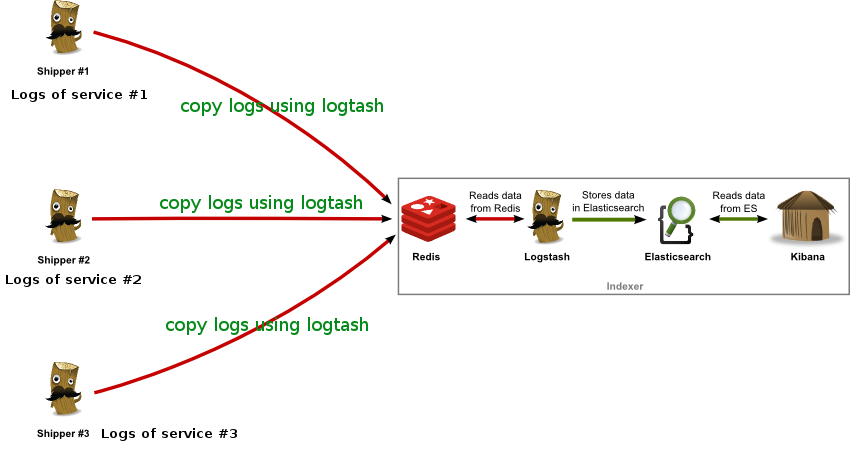
下面主要介绍对nginx日志进行处理的过程, 不是针对elk的介绍, 所有涉及ip的地方都改成127.0.0.1了, 根据自己环境进行修改
在centos使用yum安装nginx后, 默认/etc/nginx/nginx.conf中的日志格式定义为:
log_format  main  '$remote_addr - $remote_user [$time_local] "$request" '
                  '$status $body_bytes_sent "$http_referer" '
                  '"$http_user_agent" "$http_x_forwarded_for"';
然后在具体server配置中使用
access_log /data/logs/nginx/{PROJECT_NAME}_access.log main;
此时, 我们需要做的是, 将access log通过logstash shipper读取, 转json, 发送到redis, 由后续的logstash indexer进行处理
步骤
1.在日志所在机器部署logstash
2.在logstash安装目录下的patterns中加入一个文件nginx
内容(与上面的log_format相对应)
NGUSERNAME [a-zA-Z\.\@\-\+_%]+
NGUSER %{NGUSERNAME}
NGINXACCESS %{IPORHOST:clientip} - %{NOTSPACE:remote_user} \[%{HTTPDATE:timestamp}\] \"(?:%{WORD:verb} %{NOTSPACE:request}(?: HTTP/%{NUMBER:httpversion})?|%{DATA:rawrequest})\" %{NUMBER:response} (?:%{NUMBER:bytes}|-) %{QS:referrer} %{QS:agent} %{NOTSPACE:http_x_forwarded_for}
3.增加一个logstash配置文件: logstash-project-access-log.conf
注意, input的file, filter的grok, output的redis-key
    input {
    file {
        path => [ "/data/logs/nginx/xxxx_access.log" ]
        start_position => "beginning"
    }
    }

    filter {
    mutate { replace => { "type" => "nginx_access" } }
    grok {
        match => { "message" => "%{NGINXACCESS}" }
    }
    date {
        match => [ "timestamp" , "dd/MMM/YYYY:HH:mm:ss Z" ]
    }
    geoip {
        source => "clientip"
    }
    }


    output {
    redis { host => "127.0.0.1" data_type => "list" key => "logstash:xxxx:access_log" }
    }
4.使用supervisor启动shipper.
    [program:logstash_xxxx_shipper]
    command=/var/shell/logstash/bin/logstash -f /var/shell/logstash/configs/nginx-xxxx-shipper.conf
    numprocs=1
    autostart=true
    autorestart=true
    log_stdout=true
    log_stderr=true
    logfile=/data/logs/logstash/logstash_xxxx_access.log
注意, input的redis为上一步redis配置, key要对应, output的elasticsearch配置, index指定了最终es中存储对应的index, 加日期, 方便对日志进行定期删除
input {
redis {
    host => "127.0.0.1"
    port => "6379"
    key => "logstash:xxxx:access_log"
    data_type => "list"
    codec  => "json"
    type => "logstash-arthas-access"
    tags => ["arthas"]
}
}

output {
elasticsearch {
    host => "127.0.0.1"
    index => "logstash-arthas-access-%{+YYYY.MM.dd}"
}
}
剩下的其实没什么了, 启动kibana后, 配置好指向的es, 就可以在kibana中查看到实时的日志数据
demo环境截图
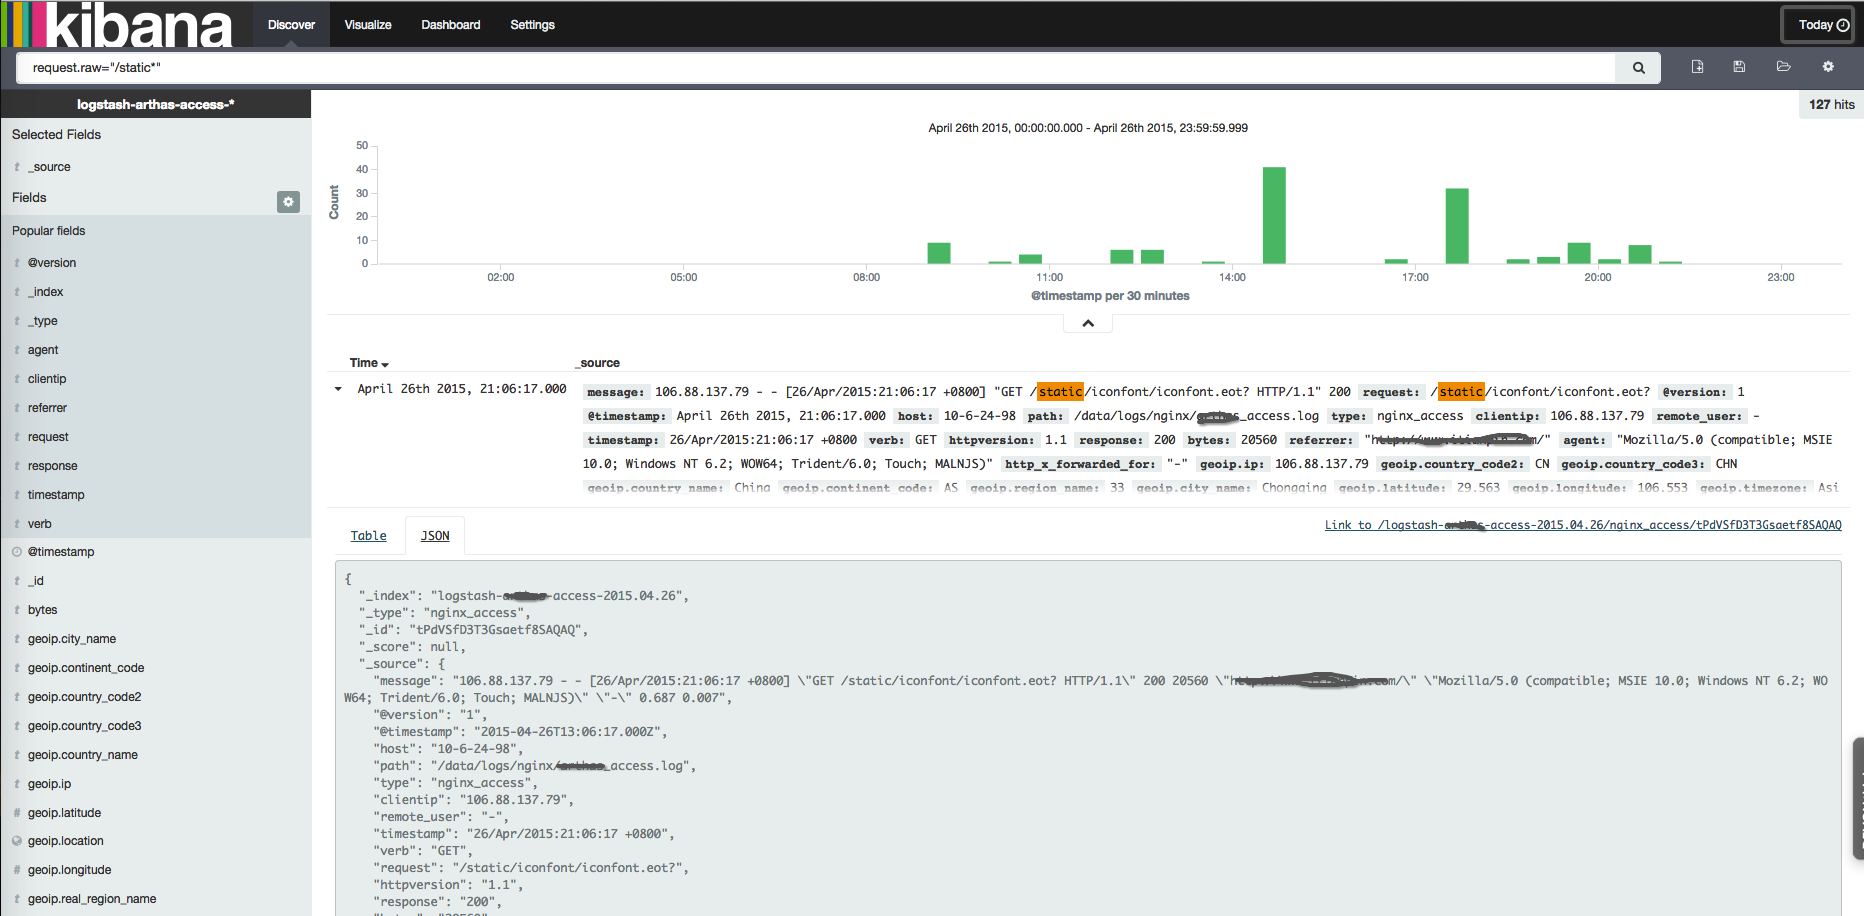
kibana中, 支持各种统计, 着实让人惊艳了一把.
除了基本的nginx日志, 还需要在各类url入口, 加入平台, 渠道等信息, 这样通过nginx访问日志, 可以统计到更多的信息
当然, 如果需要一些更为精确/特殊的统计, 需要自行进行数据上报的工作.
logstash forwarder, 因为目前日志组成等较为简单, 简单处理 , 后续需要用到时再考虑logformat和对应grok的配置grok是logstash的一个插件, 文档
Grok is currently the best way in logstash to parse crappy unstructured log data into something structured and queryable
所以, 我们在处理nginx日志时, 需要根据具体logformat定义对应的grok表达式
除了上面例子中用的那套, 另一份
logformat
  log_format logstash '$http_host '
                      '$remote_addr [$time_local] '
                      '"$request" $status $body_bytes_sent '
                      '"$http_referer" "$http_user_agent" '
                      '$request_time '
                      '$upstream_response_time';
patterns/nginx
NGUSERNAME [a-zA-Z\.\@\-\+_%]+
NGUSER %{NGUSERNAME}
NGINXACCESS %{IPORHOST:http_host} %{IPORHOST:clientip} \[%{HTTPDATE:timestamp}\] \"(?:%{WORD:verb} %{NOTSPACE:request}(?: HTTP/%{NUMBER:httpversion})?|%{DATA:rawrequest})\" %{NUMBER:response} (?:%{NUMBER:bytes}|-) %{QS:referrer} %{QS:agent} %{NUMBER:request_time:float} %{NUMBER:upstream_time:float}
如果想自行定义, 可以使用 grokdebug, 将要解析的日志和配置的正则放入, 可以查看最终得到的结构化数据
初期只安装了一个 kopf, web界面查看
建议使用supervisor对elk进行管理,(ps. 不要用yum自带的, 版本太旧好多坑, 浪费1小时……使用pip install安装最新版本即可)
配置示例elk.conf
[program:elasticsearch]
command=/var/shell/elk/elasticsearch/bin/elasticsearch
numprocs=1
autostart=true
autorestart=true

[program:kibana]
command=/var/shell/elk/kibana/bin/kibana
numprocs=1
autostart=true
autorestart=true

[program:logstash_arthas]
command=/var/shell/elk/logstash/bin/logstash -f /var/shell/elk/logstash/config/xxxx_access.conf
numprocs=1
autostart=true
autorestart=true
log_stdout=true
log_stderr=true
logfile=/data/logs/elk/logstash/logstash_arthas_access.log
start_position => "beginning"
logstash, 会记录一份文件读到的位置, 在$HOME/.sincedb_xxxxx 如果要让logstash重新读取文件, 删除之即可, 重启shipper.
但是你可能发现es中重复记录了, 这是因为, 在output中, 没有定义存储到es时使用的document_id, es全部当成新纪录存入, 导致数据重复
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。