惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

钛媒体:引领未来商业与生活新知
钛媒体:引领未来商业与生活新知
酷 壳 – CoolShell
酷 壳 – CoolShell
博客园 - 司徒正美
让小产品的独立变现更简单 - ezindie.com
Last Week in AI
Last Week in AI
大猫的无限游戏
大猫的无限游戏
博客园 - Franky
奇客Solidot–传递最新科技情报
奇客Solidot–传递最新科技情报
爱范儿
爱范儿
The Cloudflare Blog
阮一峰的网络日志
阮一峰的网络日志
博客园 - 叶小钗
博客园_首页
有赞技术团队
有赞技术团队
WordPress大学
WordPress大学
宝玉的分享
宝玉的分享
V
V2EX
V
Visual Studio Blog
博客园 - 三生石上(FineUI控件)
S
SegmentFault 最新的问题
量子位
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
Apple Machine Learning Research
美团技术团队

お前はどこまで見えている

基于成交量预测市场走势 深入理解BashShell重定向 PowerShell常见问题 低延迟趋势线择时策略 波动率与换手率中的牛熊密码 通道突破择时策略 均线择时策略 Partial Plots 因子投资基础 Permutation Importance Use Cases for Model Insights 天文相关资源汇总 被讨厌的勇气 量化笔试数理知识复习 你当像鸟飞往你的山 Python模块logging 失去的二十年:日本经济长期停滞的真正原因 PyTorch的hook机制 A股交易规则
强化学习概述
hotarugali · 2023-08-07 · via お前はどこまで見えている

1. 定义

通过从交互中学习来实现目标的计算方法:
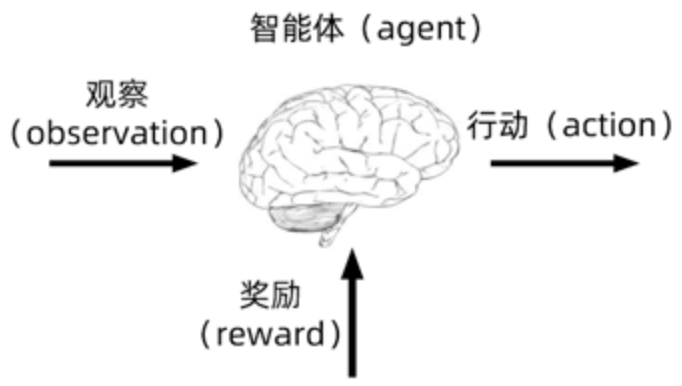
强化学习主要包括三个方面:

  • 感知:在某种程度上感知环境的状态
  • 行动:可以采取行动来影响状态或者达到目标
  • 目标:随着时间的推移最大化累积奖励

2. 交互

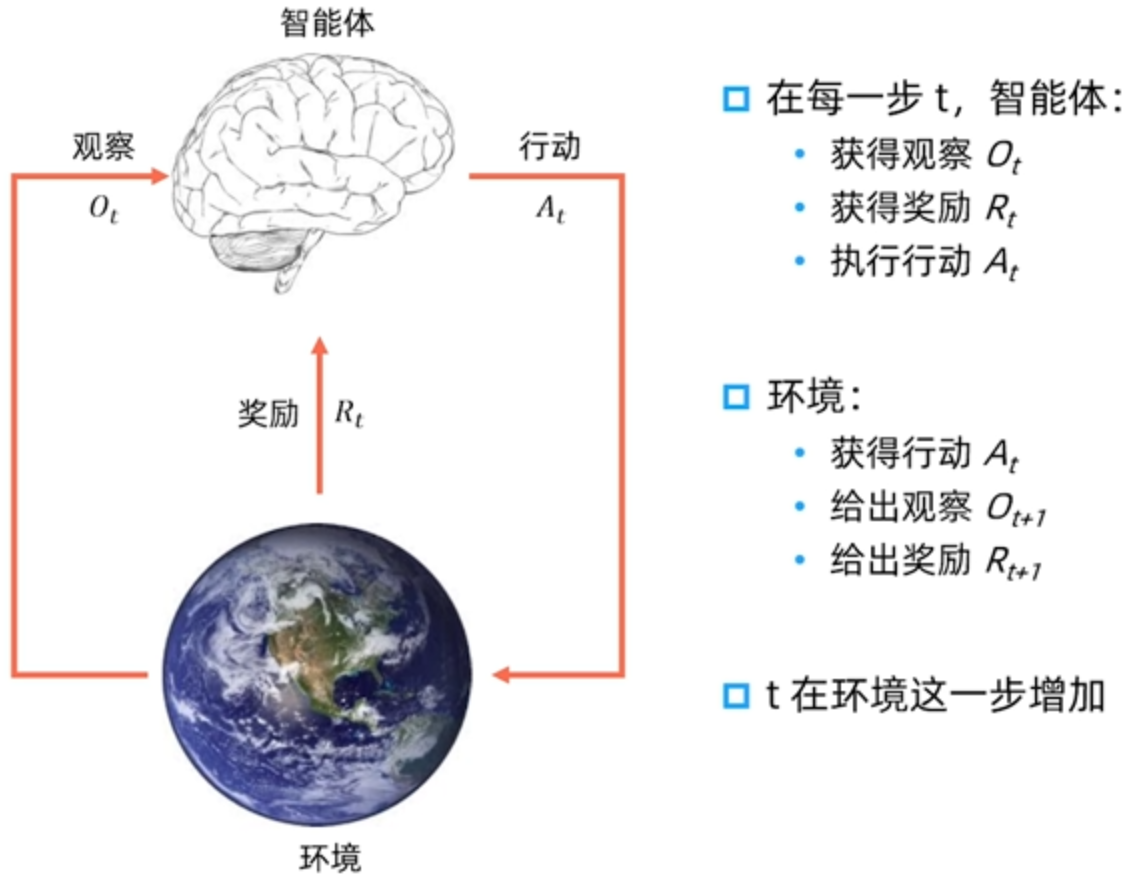
强化学习与环境交互过程如下图:
3. 系统要素

  • 历史(History):是观察、行动和奖励的序列。即一直到时间 tt 为止的所有可观测变量:

    Ht=O1,R1,A1,O2,R2,A2,⋯ ,Ot−1,Rt−1,At−1,Ot,RtH_t = O_1,R_1,A_1,O_2,R_2,A_2,\cdots,O_{t-1},R_{t-1},A_{t-1},O_t,R_t

  • 状态(State):一种用于确定接下来会发生的事情的信息。状态是关于历史的函数:

    St=f(Ht)S_t = f(H_t)

  • 策略(Policy):是学习智能体在特定时间的行为方式,是从状态到行动的映射。

    • 确实性策略:

      a=π(s)a = \pi(s)

    • 随机策略:

      π(a∣s)=P(At=a∣St=s)\pi(a | s) = P(A_t = a | S_t = s)

  • 奖励(Reward):定义强化学习目标的标量,能立即感知到什么是「好」的。

  • 价值函数(Value Function):状态价值是一个标量,用于定义对于长期来说,什么是「好」的。价值函数是对于未来累积奖励的预测:

    vπ(s)=Eπ[Rt+1+γRt+2+γ2Rt+3+⋯∣St=s]v_{\pi}(s) = \mathbb{E}_{\pi} \left[ R_{t+1} + \gamma R_{t+2} + \gamma^2 R_{t+3} + \cdots | S_t = s \right]

  • 环境模型(Model):用于模拟环境的行为。

    • 预测下一个状态:

      Pss′a=P[St+1=s′∣St=s,At=a]\mathcal{P}_{ss^{'}}^a = \mathbb{P}[S_{t+1} = s^{'} | S_t = s, A_t = a]

    • 预测下一个奖励:

      Rsa=E[Rt+1∣St=s,At=a]\mathcal{R}_{s}^a = \mathbb{E}[R_{t+1} | S_t = s, A_t = a]

版权声明: 本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来自 お前はどこまで見えている

打赏

  • 微信

    微信

  • 支付宝

    支付宝