
惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

博客园_首页
C
Check Point Blog
B
Blog RSS Feed
G
Google Developers Blog
H
Help Net Security
博客园 - Franky
Blog — PlanetScale
Blog — PlanetScale
H
Hackread – Cybersecurity News, Data Breaches, AI and More
量子位
Recent Announcements
B
Blog
Cyber Security Advisories - MS-ISAC
D
DataBreaches.Net
小众软件
小众软件
T
The Blog of Author Tim Ferriss
freeCodeCamp Programming Tutorials: Python, JavaScript, Git & More
MongoDB | Blog
MongoDB | Blog
Y
Y Combinator Blog
T
Tailwind CSS Blog
J
Java Code Geeks
MyScale Blog
MyScale Blog
雷峰网
雷峰网
有赞技术团队
有赞技术团队
博客园 - 聂微东

Benson's blog

Enjoy life Internship AI on academic research How AI Will Change the Mobile Ecosystem Look ahead Goodbye 2025 Hacker News to Kindle Another project How to imporve english Introduction of Fraud detection PopTranslate Last day in netease Better idea between Copilot-typed and CLI-typed assistant Gemini-cli LLM Post-Training experience Papers I readed recently about LLM application Difference between LLMs and traditional computer technology GRPO Weekly-#26 AI Application Weekly-#25 AI infra and application Weekly-#24 First week as LLM inference engineer Weekly-#23 seeking job Weekly-#22 2025 New Year AutoSwitch Translate Goodbye 2024 Weekly-#20 Breaking of glass Cross Entropy Loss of Triton Weekly-#18 Cross Entropy Loss of Triton Weekly-#17 Triton Puzzles Weekly-#16 AutoBuilder
读论文
Benson · 2022-04-03 · via Benson's blog

1、Sentence Representations from Natural Language Inference Data

大意:利用有监督的自然语言推断数据训练句向量,利用句向量的拼接、求差做分类进行训练。求得的句子向量在情感分析等12项任务上进行测试,句向量+dense进行分类。对比了RNN、LSTM、GRU、CNN、self-attention等句向量表征结构,BiLSTM + max pooling 效果最好。相比之前最好的无监督 SkipThought 方法有明显提升。

有意思的点

  1. BiLSTM-max pooling 相比 mean pooling 在训练任务上提升6个点,迁移任务上提升2个点。隐层应该是在学习不同的信号,通过max 来传递到下一层。
  2. 动态调整学习率,当验证集 acc 下降时,降低学习率。attention 的论文中也有动态调学习率的做法。
  3. Adam 相比 SGD 速度更快,但效果更差,因为Adam能更好的捕捉训练任务细节,在迁移任务上表现的不好。存疑。
  4. 训练任务上表现得好,不一定在迁移任务上表现就好。比如attention 比 BiLSTM 在训练任务上更好,但迁移任务上更差。猜测是attention 更关注具体的训练任务,而不是学习到一个更通用的句向量。

参考资料

  1. SkipThought vector 训练方法
  2. FastSent 无监督句向量训练
  3. layer-norm

2022-01-16

2、SkipThought vector

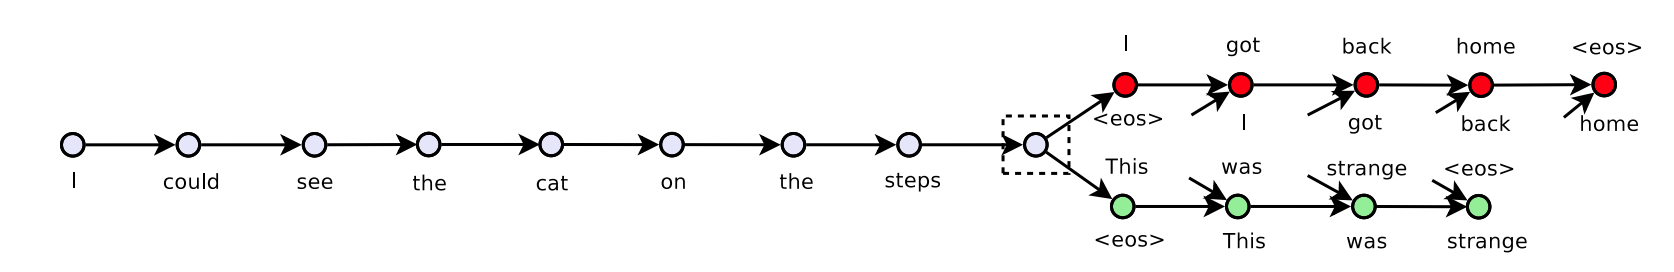
提出了无监督训练句向量的一种方法,bow+seq2seq 的训练方法,利用中间的 sentence 来预测周围的 sentence。 78944-hjmbg9o5ed9.png seq 模型文中使用的是 GRU 2022-01-23
3、FastSent

对比了几种训练句向量方法的效果。但具体方法还要看对应论文。 结论:句向量的评估和使用主要有两种,加入下游有监督任务 和 距离度量求相似度。更深更复杂的模型在有监督的任务中往往效果更好;shallow log-linear model 在空间距离度量中效果最好。 2022-02-23

4、layer normalization

对比之前提出的 batch normalizaiton ,提出了 layer norm。 batch norm:1)相比全量 norm,资源消耗少,速度更快。2)随机性相当于给训练过程添加了正则,提升鲁棒性。 layer norm:1)解决 batch norm 应用到 RNN 上时,测试样本长度比训练样本长度更长,无法获取 norm 参数的问题。2)没有 batch 的限制,能用于 online learning task 和 batch 较小的场景。3)试验验证 laryer norm 在 RNN 结构的模型中效果较好,提升时效和效果。 2022-03-05

5、softmax 变种

主要增加了当前类别的识别,提升难度。(提高梯度?) https://www.jianshu.com/p/06cc3f84aa85 2022-04-03

Trending Tags