









参考书目:《数据库系统概念》第7版,机械工程出版社
Reference: Database System Concepts, 7th Edition
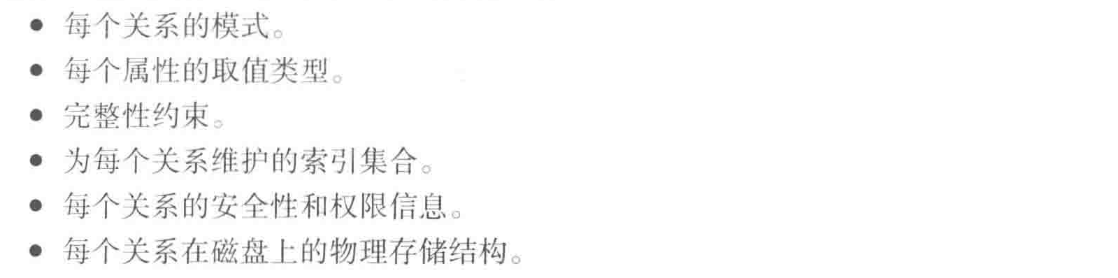

create table department
  (dept_name  varchar(20),
   building   varchar(20),
   budget     numeric(12,2),
   primary key(dept_name));
create table r
  (
    A1  D1,
    A2  D2,
    ...,
    An  Dn,
    <完整性约束1>,
    ...,
    <完整性约束n>
  );
分号可有可无。鉴于C/C++习惯,我将持续沿用;。
SQL支持许多完整性约束。
SQL禁止任何破坏完整性约束的更新。进行这样的操作将会返回一个错误并且阻止。
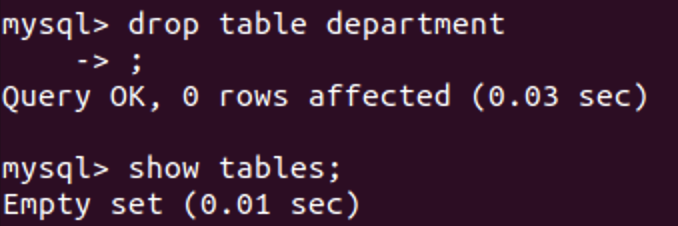
更新:insert,update,删除delete。去除关系drop table。
delete from用于删除关系内的所有元组但是保留关系,而drop table将关系也进行删除处理。
alter table为已有关系增加属性。新属性的取值被赋为null。
我们采用mysql进行上述实验。鉴于其他原因,我们将不会进行非常精细化的权限管理。
首先我们安装数据库:sudo apt install mysql-server -y
执行mysql --version检查我们的版本。

登陆sql: sudo mysql -u root -p,没有设置密码前直接回车就可以登陆。
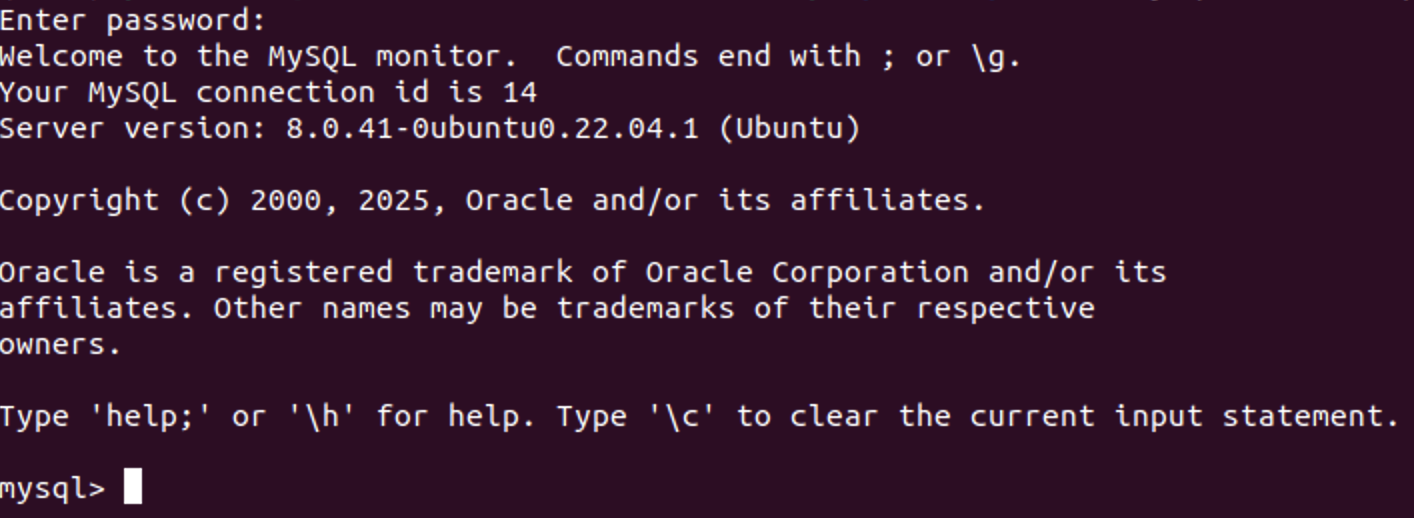
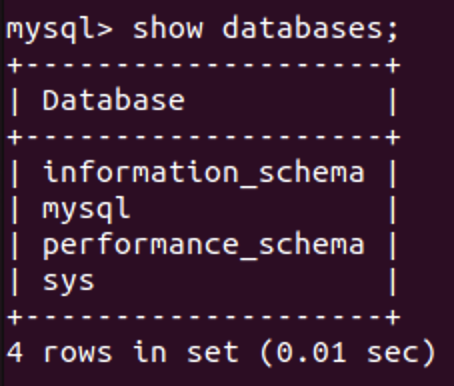
查看我们已经存在的数据库(不是关系!)
show databases;注意分号。
创建我们的实验性数据库create database experiment;
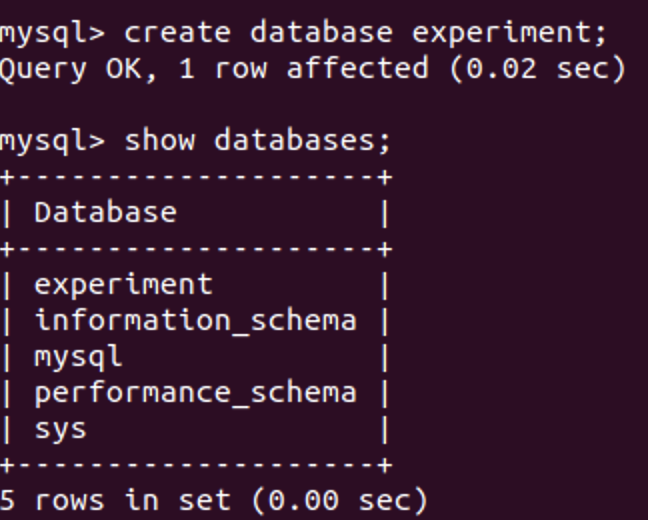
可以发现多了一个数据库。我们通过use experiment来使用它。
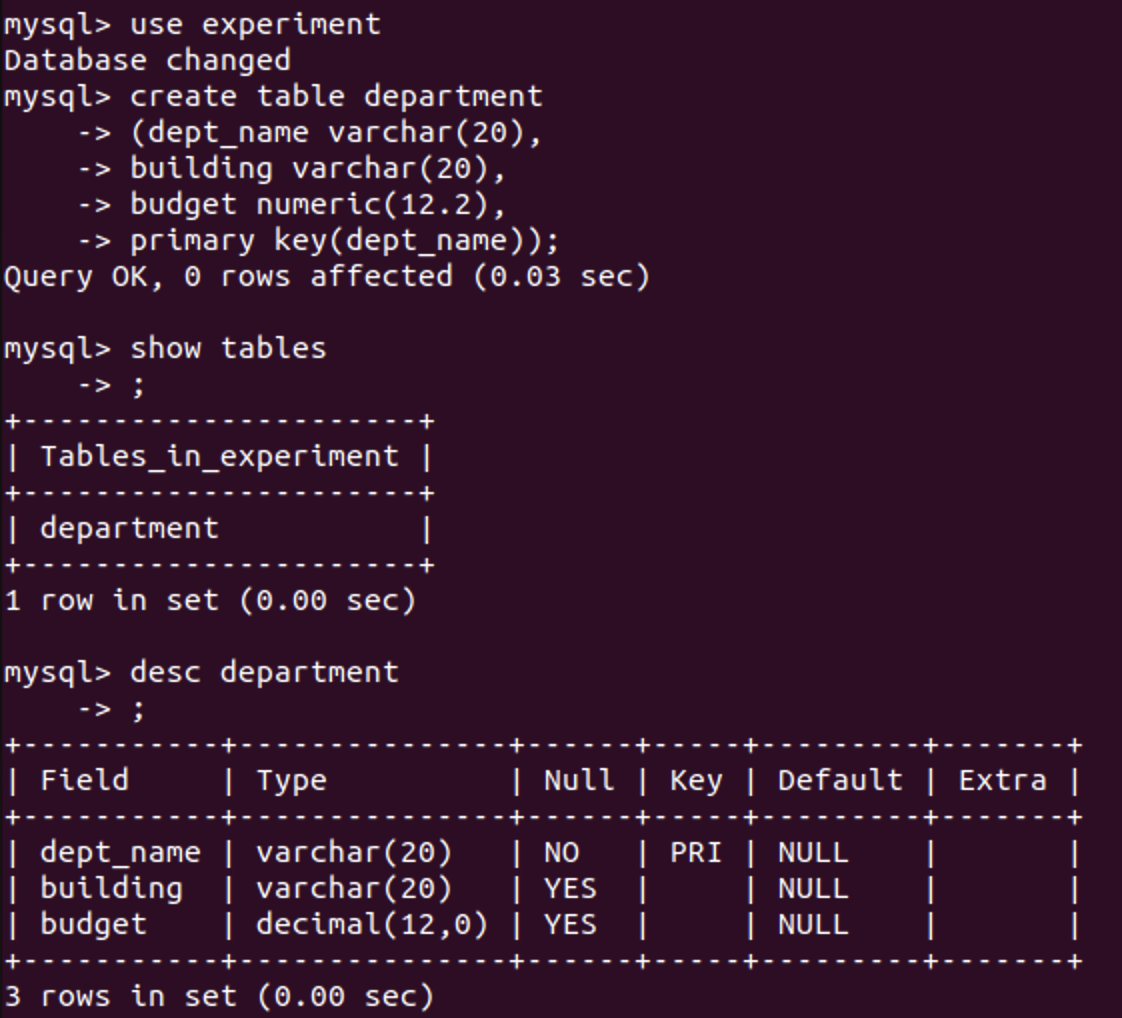
根据上文我们的department表格,我们可以进行如下操作:
select name
from help_topic;
select distinct name
from help_topic;
select all name
from help_topic;
select ID,salary*1.1
from instructor
这样显示出来的关系就是instructor中的ID属性和salary属性中的元组。不同的是所有的salary的值将是原来的1.1倍。
select name
from instructor
where dept_name='CS' and salary > 70000;
select name,instructor.dept_name, building
from instructor,department
where instructor.dept_name=department.dept_name
小结
- SQL查询语句包括三种类型的子句:select,from,where.
- select子句用于列出查询结果中需要的属性。
- from子句用于查询求值中需要访问的关系列表。
- where子句是作用在from子句中的关系属性上的谓词。
select A1,A2,...,A_n
from r1,r2,...,rn
where P;
多重集关系代数Pt.I
对SQL的行为进行建模,我们定义了一个叫做 多重集关系代数(multiset relational algebra) 来进行处理。
- 对于关系 \(r_1\),其中的元组 \(t_1\) 有 \(c_1\) 份的拷贝并且 \(t_1\) 满足条件 \(\sigma_\theta\), 则在 \(\sigma_\theta(r_1)\) 中有 \(c_1\) 份其拷贝。
- 对于关系 \(r_1\),其中的元组 \(t_1\) 有 \(c_1\) 份的拷贝, 对于其中每一份拷贝, \(\prod_A(t_1)\) 都有 \(t_1\) 的拷贝。\(\prod_A(t_1)\) 称为 \(t_1\) 的投影。
- \(r_1\times r_2\) 有元组 \((t1,t2)\) 的 \(c_1c_2\) 份拷贝。
太复杂了我们举例说明一下。注意 \(\sigma\) 即按照条件选择, \(\prod\) 即根据模式筛选出元素中的那一个对应成份。\(\times\) 即经典笛卡尔积。我们有:
\(r_1=\{(1,a),(2,a)\}\),模式为 \((A,B)\)
\(r_2=\{2,3,3\}\),模式为 \(C\).
- \(\sigma_{A > 1}(r_1)=\{(2,a)\}\)
- \(\prod_B(r_1) = \{a,a\}\)
- \(\prod_B(r_1) \times r_2 = \{(a,2),(a,2),(a,3),(a,3),(a,3),(a,3)\}\)
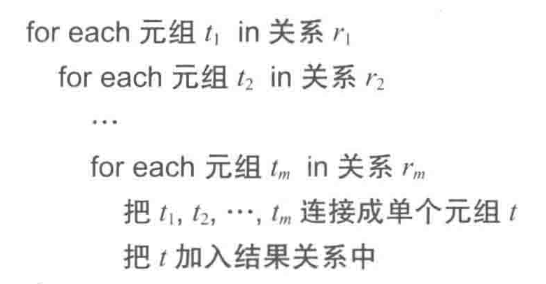
因此,对于我们的SQL查询,可以写成:
\(\prod_{A_1,\ldots,A_n}(\sigma_p(r_1\times r_2\times \cdots r_m))\)
as为更名运算。
old-name as new-name
我们可以在select中使用as进行属性名的更换,例如:
select a as b
from relation1, relation2
where relation1.ID = relation2.ID
'表示。like 'ab\%cd%' escape '\'匹配以"ab%cd"开头的所有字符串。select course_id
from section
where semester='fall' and year=2017
union
select course_id
from section
where semester='spring' and year=2018;
select name
from instructor
where salary > 10000 is unknown;
select avg(salary)
from instructor
where dept_name='CS';
select avg(salary) as avg_salary
from instructor
where dept_name='CS';
select count(distinct ID)
from teachers
where semester='spring' and year=2018
这样即使有教师任课数量大于1,也只会被计数一次。
*来计算一个关系中元组的数量。select count(*)
from instructors
select dept_name, avg(salary) as avg_salary
from instructors
group by dept_name
/* */或者--的方式来撰写注释。select dept_name, avg(salary) as avg_salary
from instructor
group by dept_name
having avg(salary)>42000;
找出平均工资超过42000的教师和他们所处的系。
同样的,包含在having子句中,但是没有被聚集的属性必须出现在group by子句中。否则查询错误。
对于有having,group by和聚集的查询含义一般定义如下:
多重集关系代数Pt.II
- 同样的,关系代数也有并,交和差。
- 我们可以用关系代数聚集运算 \(\gamma\) 来允许在关系属性上使用聚集函数。(或者使用 \(\mathcal{G}\))。
- 对于复杂的sql可以进行改写。
select A1,A2,sum(A3)
from r1,r2,...,rm
where P
group by A1, A2, having count(A4)>2
可以写成:
\(t_1\leftarrow \sigma_p(r_1\times r_2\cdots r_m)\)
\(\prod_{A_1,A_2,\text{sum}(A_3)}(\sigma_{count(A_4)>2}(_{A_1,A_2}\gamma_{sum(A_3)~ as ~sum(A_3),~count(A_4)}(t_1)))\)
(select course_id
from section
where semester = 'spring' and year = 2018
);
select distinct course_id
from selection
where semester = 'autumn'
and year=2017
and course_id in
(select course_id
from selection
where semester = 'spring'
and year=2018
);
select distinct T.name
from instructor as T
where salary > some(
  select salary
  from instructor
  where dept_name = 'Biology'
);
select T.course_id
from course as T
where unique(select R.course_id
from section as R
where T.course_id = R.course_id and R.year = 2017)
任何select-from-where表达式返回的结果都是关系。因此可以被插入到其他关系可以出现的位置。
select dept_bame,avg_salary
from(
  select dept_name,
    avg(salary) as avg_salary
  from instructor
  group by dept_name
) as dept_avg(dept_name, avg_salary)
where avg_salary > 42000
select a, (
  select count(*)
  from b
  where c.a = b.a
)as d
from R
select(select count(*) from teachers) / (select count(*) from instructor) from dual
delete from Relation
where P;
insert into R (A1, A2, A3)
  values ('AAA', 12,4),
  ('111',12,3);
insert into student
  select ID, name
  from R
  where P;
update relation
set A = A1
where P;
update instructor
set salary = case
  when P1 then res1
  when P2 then res2
  else res3
end
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。