(Sigcomm'25) Alibaba Stellar: A New Generation RDMA Network for Cloud AI
针对云AI的新一代RDMA网络,sigcomm'25
个人阅读笔记,因知识点欠缺+内容繁多,行文不畅之处敬请见谅。本blog仅为参考。(读了两个周多才读完,要反思...)
背景
虚拟化与高性能网络协议栈
- 安全容器RunD:轻量级,隔离性强。
- 内存映射层级。主要关注两处加速:
- EPT:拓展页表直接映射guest物理地址到host物理地址提供加速。
- IOMMU:将设备地址直接映射到主机物理地址。实现RDMA操作。
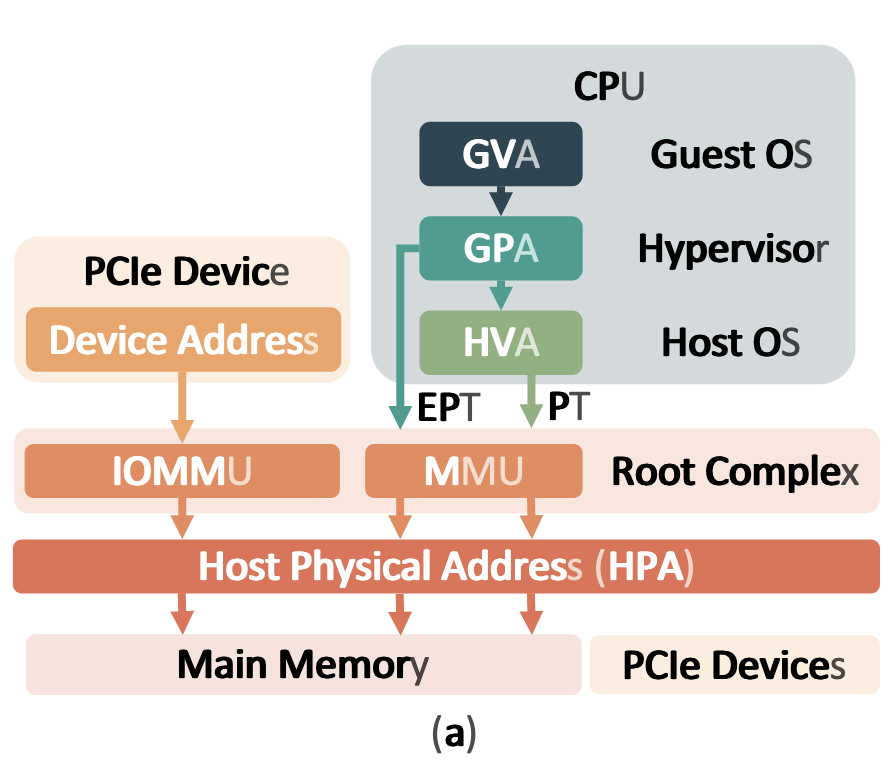
- PCIe子系统:主要关注的是:CPU对于设备地址的分配以及设备之间的通信。
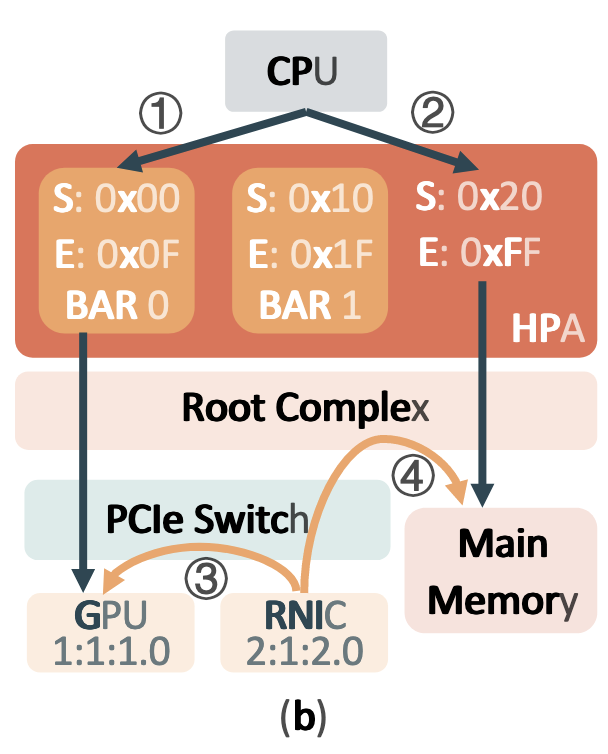
- CPU通过PCIe Base Address寄存器来实现与PCIe设备通信。
- 每个设备具有自己的Bus-Device-Function标识符。
- 在BAR中定义了CPU能够直接访问的设备地址——主机物理地址的映射。
- CPU执行写任务时,先查找内存区域。如果在BAR中存在,则通过RC和PCIe路由直接写入对应设备。否则写入主内存中。
- PCIe设备之间也可以通过P2P事务通信。根据已经注册好的BAR,通过PCIe路由直接进行通信。如果与主内存进行通信,则通过PCIe路由和RC。如图所示。
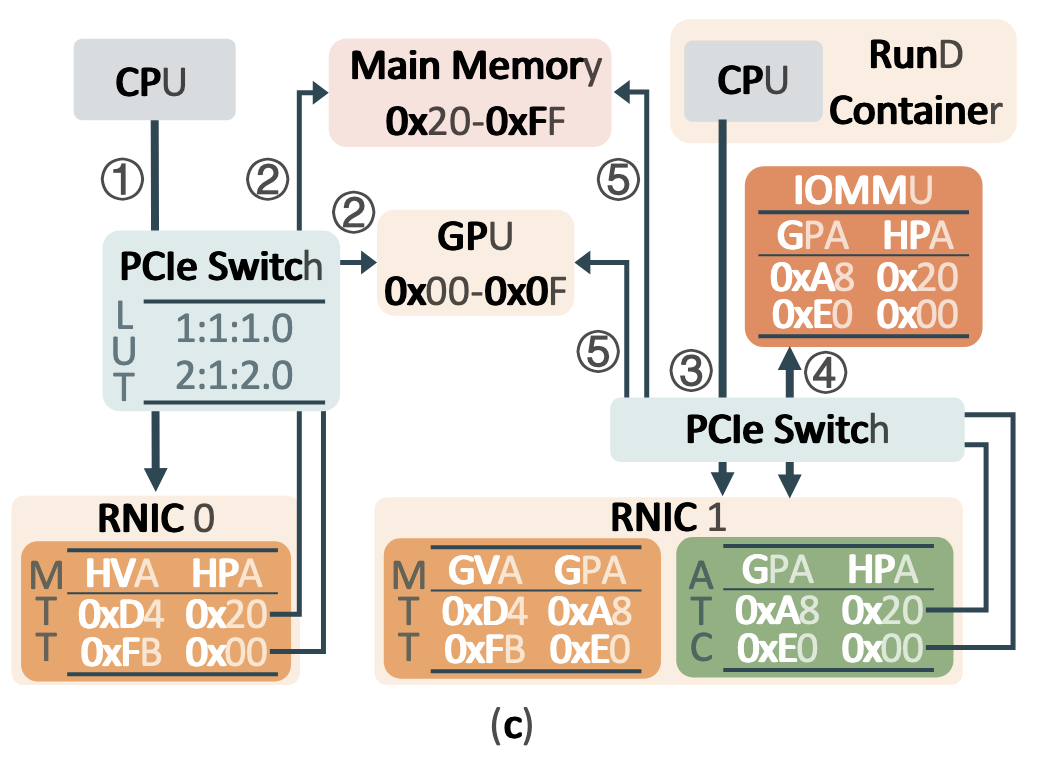
- RDMA与GPU direct RDMA(GDR)。
- 首先,应用将通过CPU将注册一个MR(内存区域)在host虚拟地址中,这个区域允许NIC读取,指向主内存或者设备内存。
- 其次,设备将读取HVA到HPA的映射并写入自己的内部数据中,成为自己的MTT。
- 然后,在RunD虚拟机环境中,容器驱动不会关心GVA到GPA的映射,它将会把这个映射写入到设备的MTT中,并且依赖IOMMU实现GPA到HPA的转换。
- 当一个RDMA/GDR带着GVA地址的请求到来时:
- 首先从设备中的MTT得到GPA;
- 然后从IOMMU中根据GPA获取HPA,这样就绕过了GPA->HVA->HPA的中间转换。将HPA返回给设备。
- 设备自己也会再维护一个cache成为ATC(Address Translation Cache),记录GPA到HPA的映射,来实现缓存命中减少查询翻译开销。
什么是 SR-IOV(Single Root Input Output Virtualization)
- SRIOV是对PCIe总线的拓展。
- 允许一个设备,例如一个网络适配器,将其资源准入分隔给多个PCIe硬件函数。这些方程包括:
- PCIe物理函数PF。这些函数是设备的最基础函数,将会广播设备的SRIOV能力。PF将会在一个虚拟环境中与Hyper-V父分区相关联。
- 一个或多个PCIe虚拟函数VF。虚拟函数将会与设备的物理函数相关联。一个虚拟函数VF将会共享设备的一个或者多个物理资源,例如内存和一个网络端口。设备上也会有PF和其他的VF共享。
- 每个PF和VF都会具有一个唯一的PCIe需求ID(RID),允许IO资源管理和IOMMU,来将不同的流量进行区分,并且在PF和VF之间实现终端和内存翻译。
- 这样就允许流量直接送达Hyper-V对应的父分区或孩子分区,并且不会相互干扰,绕开了软件层面的路由层控制和Hyper-V虚拟化协议栈。
个人理解:本质上就是对PCIe总线物理资源的虚拟化使用,增加PCIe的使用效率,使得一个物理资源的利用效率提高(或者可以被多个资源共同利用)。
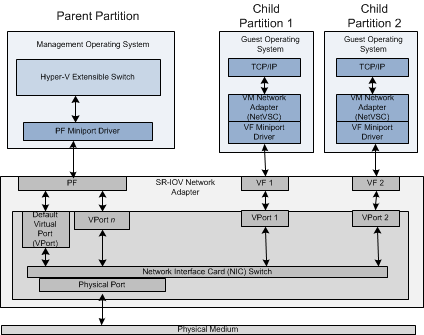
参考来源: Microsoft
关注的主要问题
- LLM的发展对高性能AI训练和推理要求不断提高,RDMA在其中具有非常重要的作用。
- 现有的RDMA虚拟化方案,例如单根节点IO虚拟化(Single-Root Input/Output Virtualization, SR-IOV)在可扩展性,表现性和稳定性存在严重的限制。这样就导致了容器初始化时间较长,硬件资源受限,以及不高效的流量引导。
现有的虚拟化方案的相关介绍
为了更好对比,左图是已有的架构。右图是本文提出的架构。
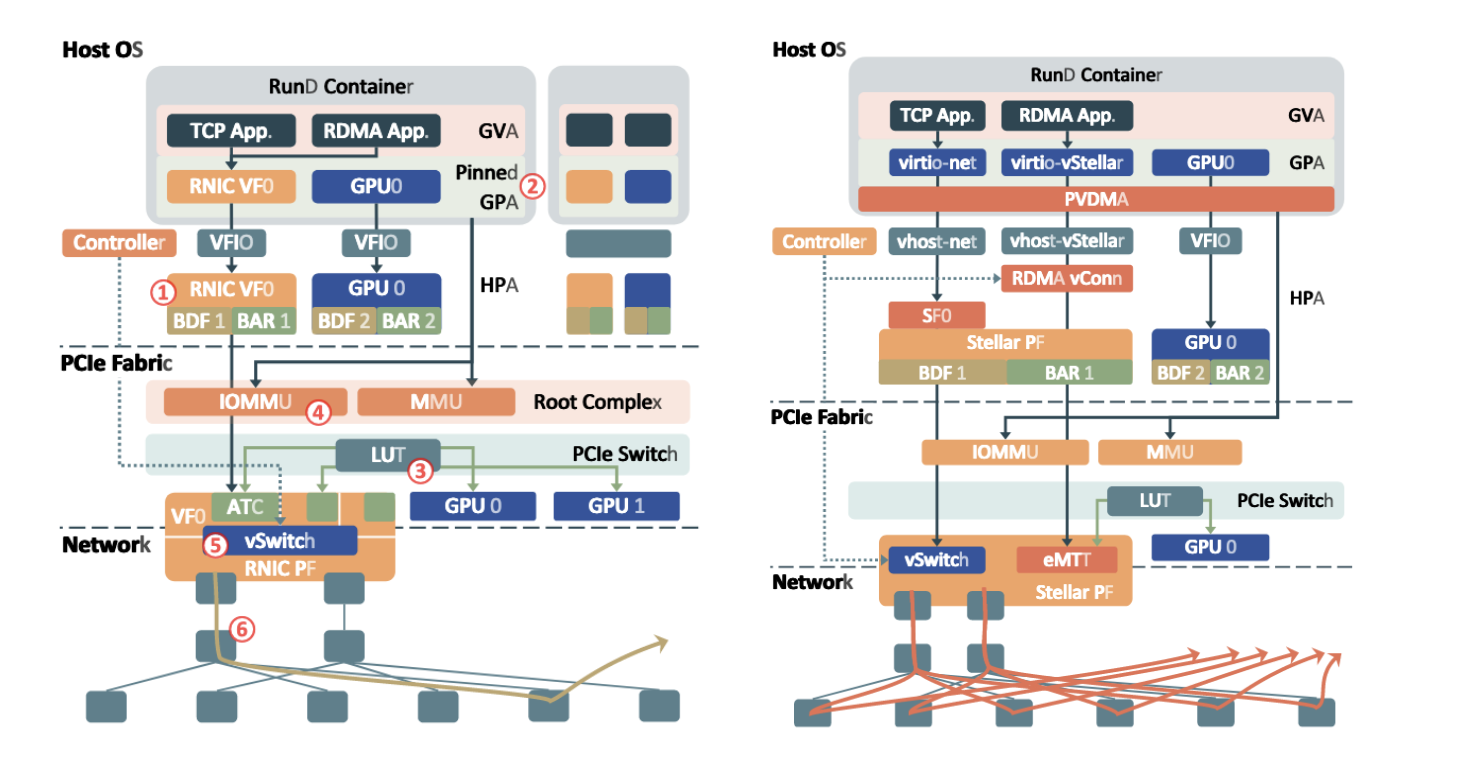
- 一个或者多个RunD容器将会在主机OS上运行,每个将会具有至少一个NIC以及一个GPU。其中,位于容器内的NIC是通过SRIOV技术从PF中虚拟化得到的VF,将会具有一个专用的总线设备函数(BDF)标识和BAR空间(记录在HPA内允许CPU直接访问的对应设备地址空间)。
- PCIe设备(RNIC,GPU)将会通过VFIO(虚拟函数IO),通过Root Complex的IOMMU配置,来将硬件资源(BAR)映射到runD容器的GPA上。
- 这样,运行在容器中的应用可以像访问裸金属服务器一样进入容器,达到最优的RDMA/GDR表现。
- 在PCIe总线上,IOMMU,ATC,PCIe交换机查找表(LUT)将被配置,以允许RDMA和GDR在runD容器上运行。
- RNIC使用了其内建的vSwitch来允许在PF和VF之间的直接流量通信。这个vSwitch通过控制器程序在宿主机中进行控制。控制器维护了一个复杂的,基于VXLAN的虚拟到物理网络的映射。由于这样的映射超过了vswitch的容量,控制器将会跟踪每个容器的活跃的网络连接并且动态负载对应的规则。
- 对于每个活跃的连接,RNIC将会随机选择两个端口中的一个来将流量转发给网络。具有相同连接的所有报文都会拥有相同的头,走相同的通路。
旧有网络架构所具有的问题
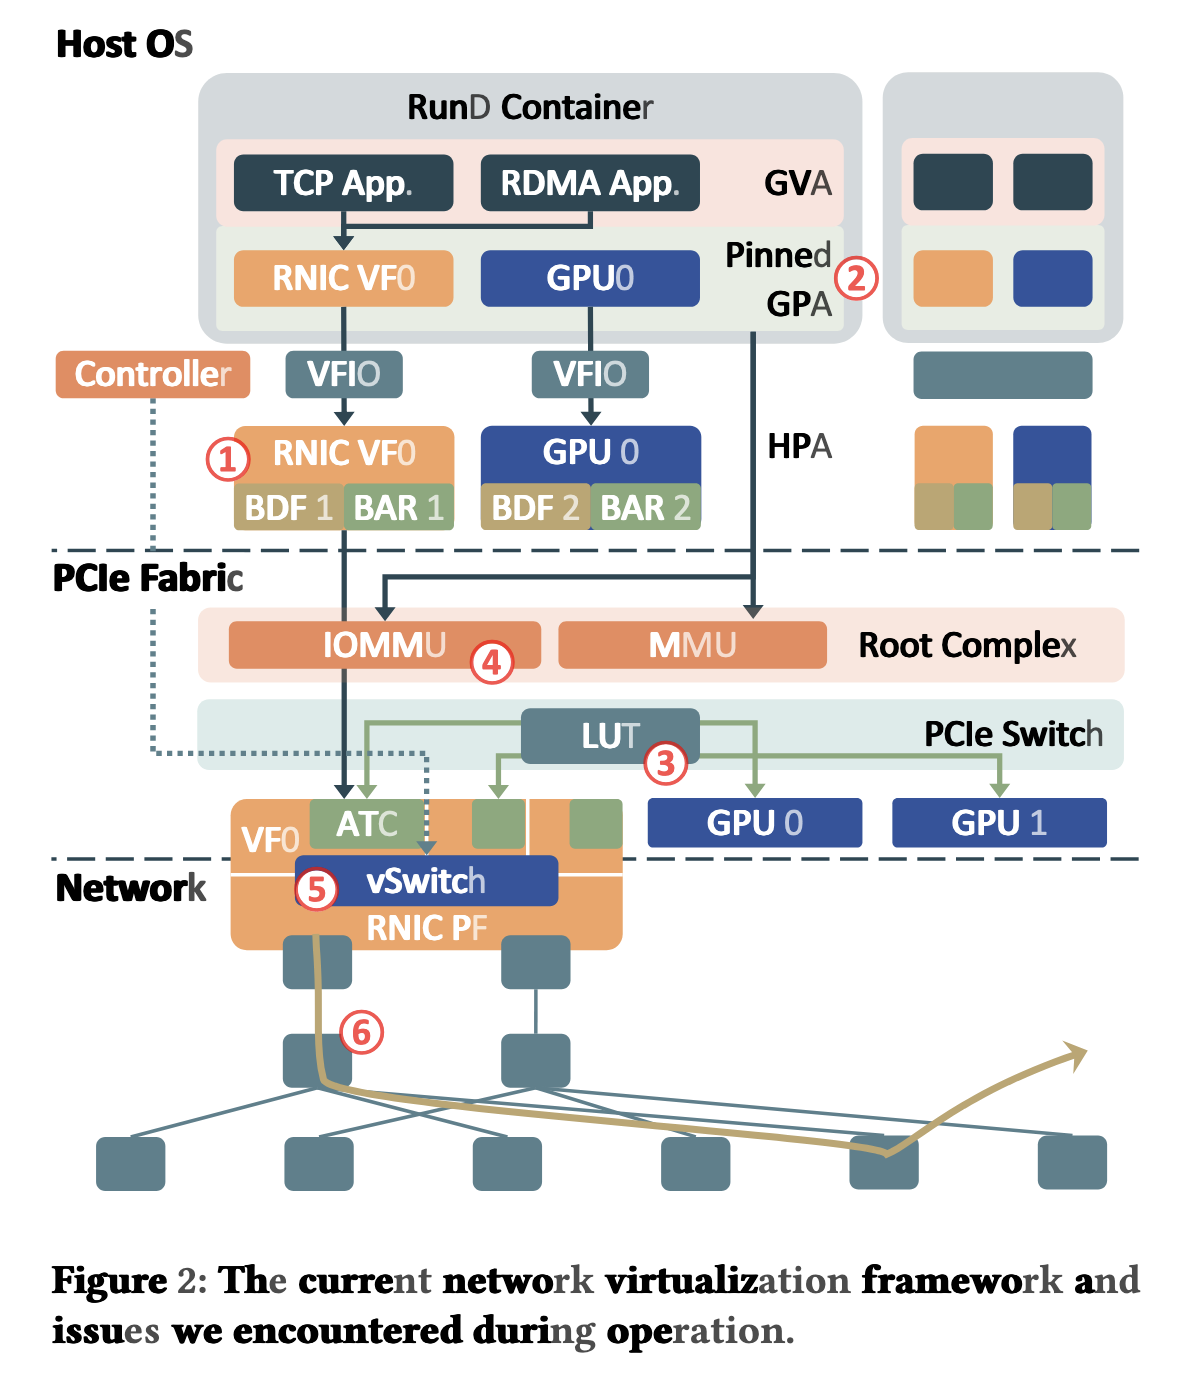
host层级
图中1、2表示了host层级因SRIOV和VFIO驱动遇到的问题。
PCIe层级
图中3、4表示了PCIe层级中存在的硬件资源和功能限制。
RNIC层级
图中5,6显示了由于RDMA和TCP耦合的问题。
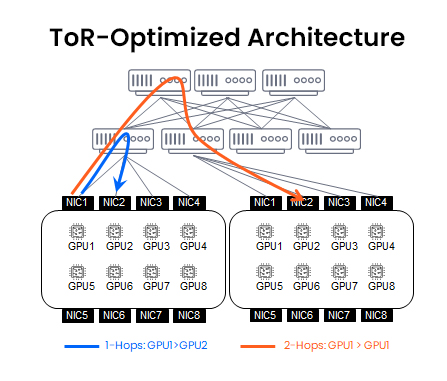
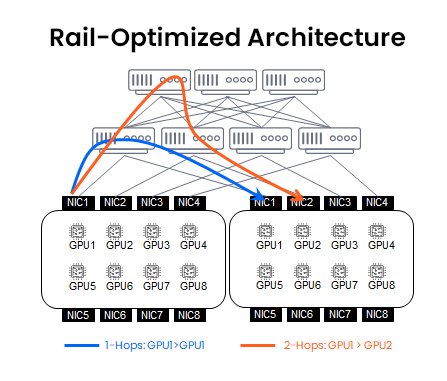
ToR优化架构和Rail优化架构
source
ToR优化架构:
Rail优化架构:
Insights:洞察
- 灵活的虚拟化。RNIC可以动态创建,销毁多个虚拟设备并且这些设备应该有快速的启动时间。
- 稳定的表现。RDMA和GDR表现应该稳定,无论多少虚拟化设备或者管理事件与非RDMA流量有关。
- 多路支持。RNIC网卡需要完全利用剩余的等价路径,来获取更多更稳定的RDMA/GDR表现。
提出的解决方案
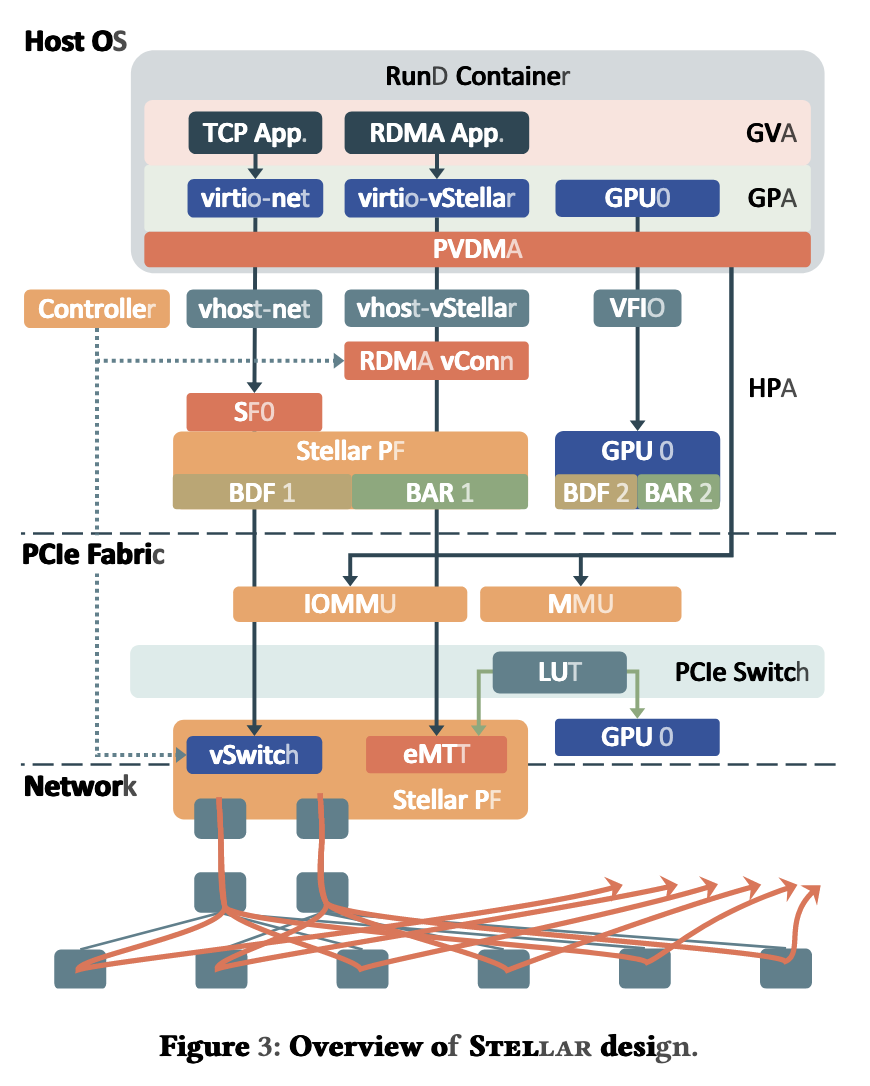
- Stellar,新一代的针对云AI的RDMA网络。
- 具有以下三个创新:
- 参数虚拟化DMA(para-Virtualized Direct Memory Access),针对内存固定请求。
- 拓展内存翻译表(eMTT),优化GPU Direct RDMA(GDR)的表现。
- RDMA Packet Spray,有效的多路利用优化。
- 在我们的大规模AI集群中,Stellar 提升了虚拟设备数秒,减少了容器初始化时间至原先的1/15,提升了14%的LLM训练时间。表现了我们的方案具有可扩展,稳定和高性能。
为了解决主要的问题,提出了stellar,融合了HyV和MasQ的设计,避开了SRIOV,提出了新的在Host,PCIe,NIC层级的方案。
- 在一个安全的容器中,stellar提供了两个虚拟的I/O设备分别处理RDMA与其他流量。图中virtio-vstellar处理RDMA流量,virtio-net处理非RDMA流量。
- 对于TCP流量,stellar采用了所有主流的技术,包括virtio-net, vDPA(虚拟化数据通路加速), SF(扩展性功能),以及vxlan隧道功能。
- 选择SF是因为他们比VF更加灵活,允许动态创建和删除,因此解决了VF灵活性问题。
- 尽管virtio-net/SF/VxLan相较于vfio/VF/VxLan方式有5%的性能损失,其影响很小。这是因为TCP流量在分布式AI/LLM工作负载上一般作为控制信息,因此几乎可以忽略其对端到端工作表现的影响。
- 对于RDMA流量,我们采取了混合虚拟化方案,成为vstellar。
- 控制通路我们采用virtio。控制信息(例如创建QP,查询,更改,MR注册)首先到达容器的virtio驱动。随后host的virtio驱动拦截这些请求,并执行安全/虚拟化相关函数。
- 数据通路通过直接内存映射,遵从HyV和MasQ的方式。特别地,安全的容器可以直接读取RNIC的DB寄存器(用于管理CQ和SQ的header),并且RNIC可以直接读写注册在容器内的MR。这样的设计维护了RDMA的表现,并且没有影响安全性。
- 对于SF的使用和vStellar设计,并不需要在PCIe子系统中提供额外的BDF。因此我们所有的虚拟设备都支持GDR通信,解决VF可扩展性与LUT的容量限制。
- vStellar设备可以在数秒内创建和销毁,消耗少量的硬件资源。
具体细节
然而,仍然存在三个关键性的问题。
- 安全容器仍然固定住所有的内存来保证所有的应用能够正确地与GPU和NIC进行通信,导致很长时间的启动。 -> GDR可用的参数虚拟化内存直接读取技术(PVDMA).
- 不断增加的虚拟设备数量减少了每个虚拟设备地址翻译缓存ATC的分配,从而缓存缺失上升,削弱GDR表现。 -> 扩展MTT成为eMTT来允许直接读取GPU内存。
- 主机端侧的RDMA虚拟化(HyV,MasQ)无法解决单路RDMA传输的表现问题。 -> packet spray,采用OPS算法。
PVDMA:参数虚拟化DMA
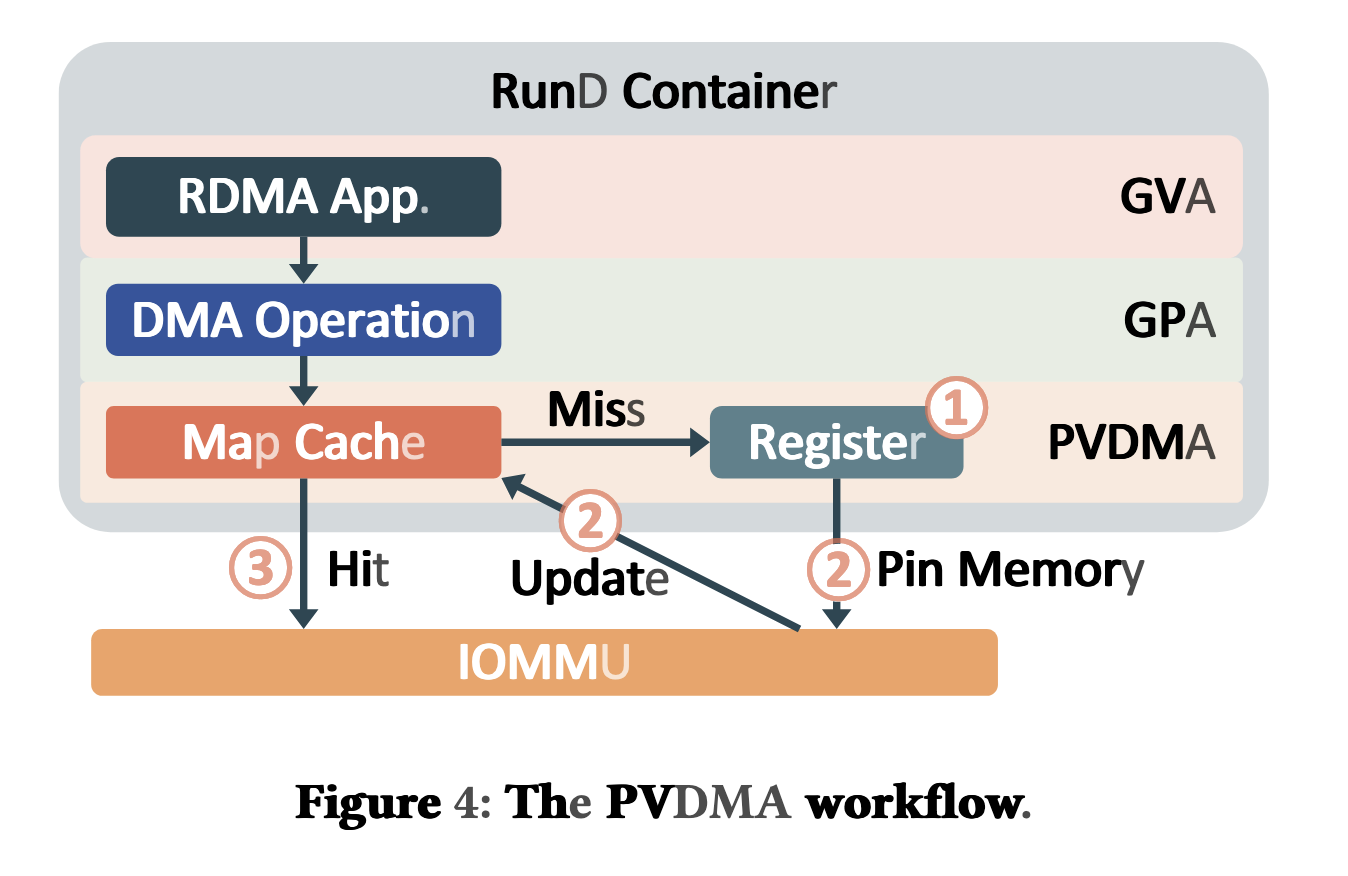
为了能够根据请求实现内存固定,PVDMA大量减少了主机内存开销,减少了安全容器的启动时延。
上图即为PVDMA的执行流程。
- 没有内存固定。当在runD中的virtio-stellar驱动初始化DMA操作时,PVDMA监测并且拦截请求。
- 在hypervisor中注册请求的GPA-MR后,与IOMMU进行通信,在HPA中固定相关联的内存,并且更新缓存。
- 在随后的DMA操作中,对于相同的MR,将直接从缓存中取出映射关系并执行操作,也可以防止内存因换页导致缺页失败。
由于RDMA应用经常重用一块固定的MR,PVDMA的应需求进行内存固定的操作将不会带来非常明显的开销,并且映射缓存查找也是轻量级的,不会引发非常长的延时。这样的设计灵感来源于vIOMMU和coIOMMU,但提供了更加轻量级的解决方案。
带来的问题:PVDMA的动态映射与MMU中存在的映射具有冲突
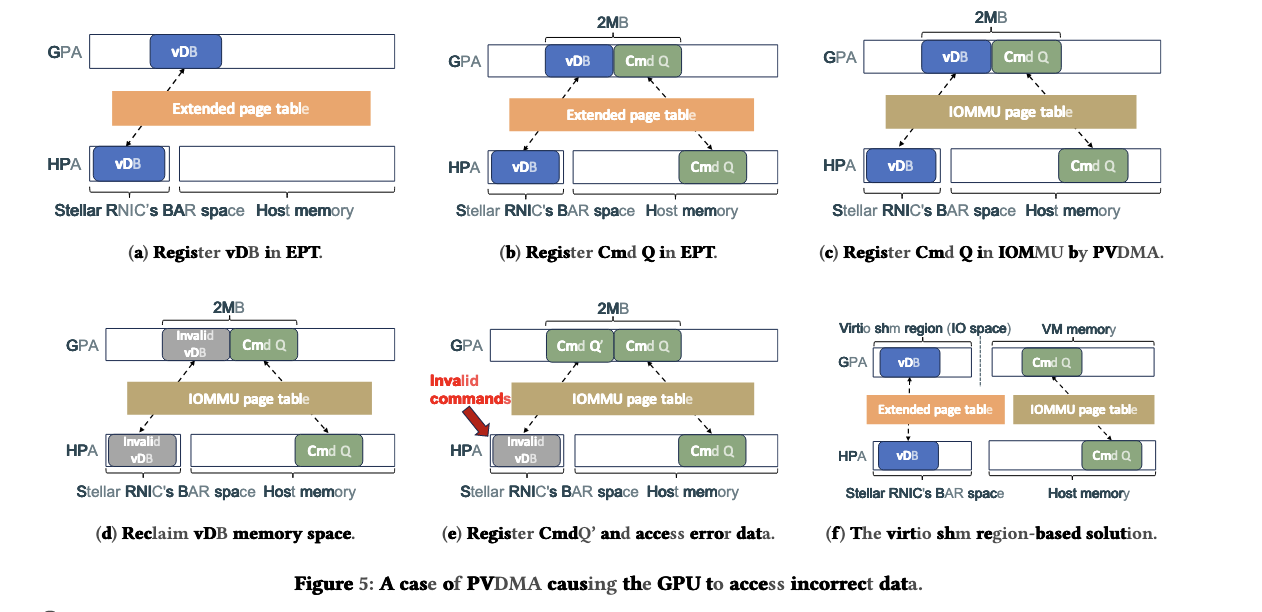
这样的动态配置在避免了全量内存固定的同时也带来了GPU不正常访问NIC内存的风险。这是因为PVDMA的动态映射与MMU中存在的映射具有冲突。主要具有上图的五步,位于图(a,b,c,d,e)。主要的矛盾是由于GPU的DMA操作可能会错误访问RNIC的已经执行结束DMA操作后释放的对应的内存区域。
- 注册虚拟DoorBell映射关系(HPA-GPA)到扩展页表中。当RDMA程序启动的时候,virtio-stellar驱动将执行直接内存映射,记录vDB在HPA——GPA中的映射关系。
- 注册命令队列映射关系(HPA-GPA)到扩展页表中。为了允许CPU直接发布命令给GPU,GPU驱动分配内存给一个命令队列。在该例子中,我们认为这两个内存区域是相邻的。
- 将命令队列注册到IOMMU中。当GPU将要通过DMA读取命令队列的时候,GPU发出一个DMA请求,PVDMA监测并拦截到该请求,在缓存缺失的状态下,在hypervisor注册GPA内存区域后,与IOMMU进行通信,在HPA中固定相互关联的内存,并且更新缓存。但是因为固定内存区域的粒度为2MiB,因此这块区域也包括了先前的虚拟doorbell内存区域。
- 不正确的vDB映射冲突。在RDMA程序结束后,虚拟doorbell的EPT映射将会释放。然而,如果GPU程序仍然在运行,PVDMA将不会释放先前固定住的2MiB内存区域,这样RNIC的虚拟DB和物理DB的映射关系实际上仍然存在于IOMMU的页表中被固定住。
- 错误的数据读取。OS有时候会复用这一块原先是vDB的内存区域,用来创建一个新的命令队列。但这时候通过IOMMU发现,原先我仍然有固定住的储存在IOMMU页表中的映射,这样当执行新的命令队列的DMA操作时,DMA将会访问RNIC的物理doorbell寄存器,导致错误。
解决上述问题需要通过避免内存地址交叠的方式,区分开基于MMU对设备寄存器与PVDMA基于IOMMU映射。
- 前者的映射粒度一般为4KiB(通过slab进行管理)。该系统的映射粒度是2MiB。(用于权衡映射缓存和IOMMU固定开销)。这样就要求我们对齐两者的粒度。
- 但是无论是增加MMU粒度或是减少PVDMA粒度都会导致损害。前者将降低虚拟设备的可扩展性,增加开销,后者将会增加IOMMU配置的开销。
解决方案:采用virtio框架的共享内存区域特性
- 这个特性提供了virtio设备的IO空间,与主物理内存空间有所区别。可以详见上图的(f)。
- 我们可以看到,vDB被映射到这一块共享内存空间中。这一块空间并没有与PVDMA所使用的物理内存空间相互重叠,因此消除了冲突。
- 但是这一个IO空间并没有在IOMMU注册,因此GPU无法直接通过DMA访问。这样GDR的一个关键功能:GPUDirect Async将无法使用。
什么是GPUDirectAsync?参考
GDR(GPU Direct RDMA)中,使用InfiniBand协议的RDMA采用GPUDirect Async(GPU直接异步)的方式来直接和网卡进行互动。我们可以看下图来了解其工作流程。
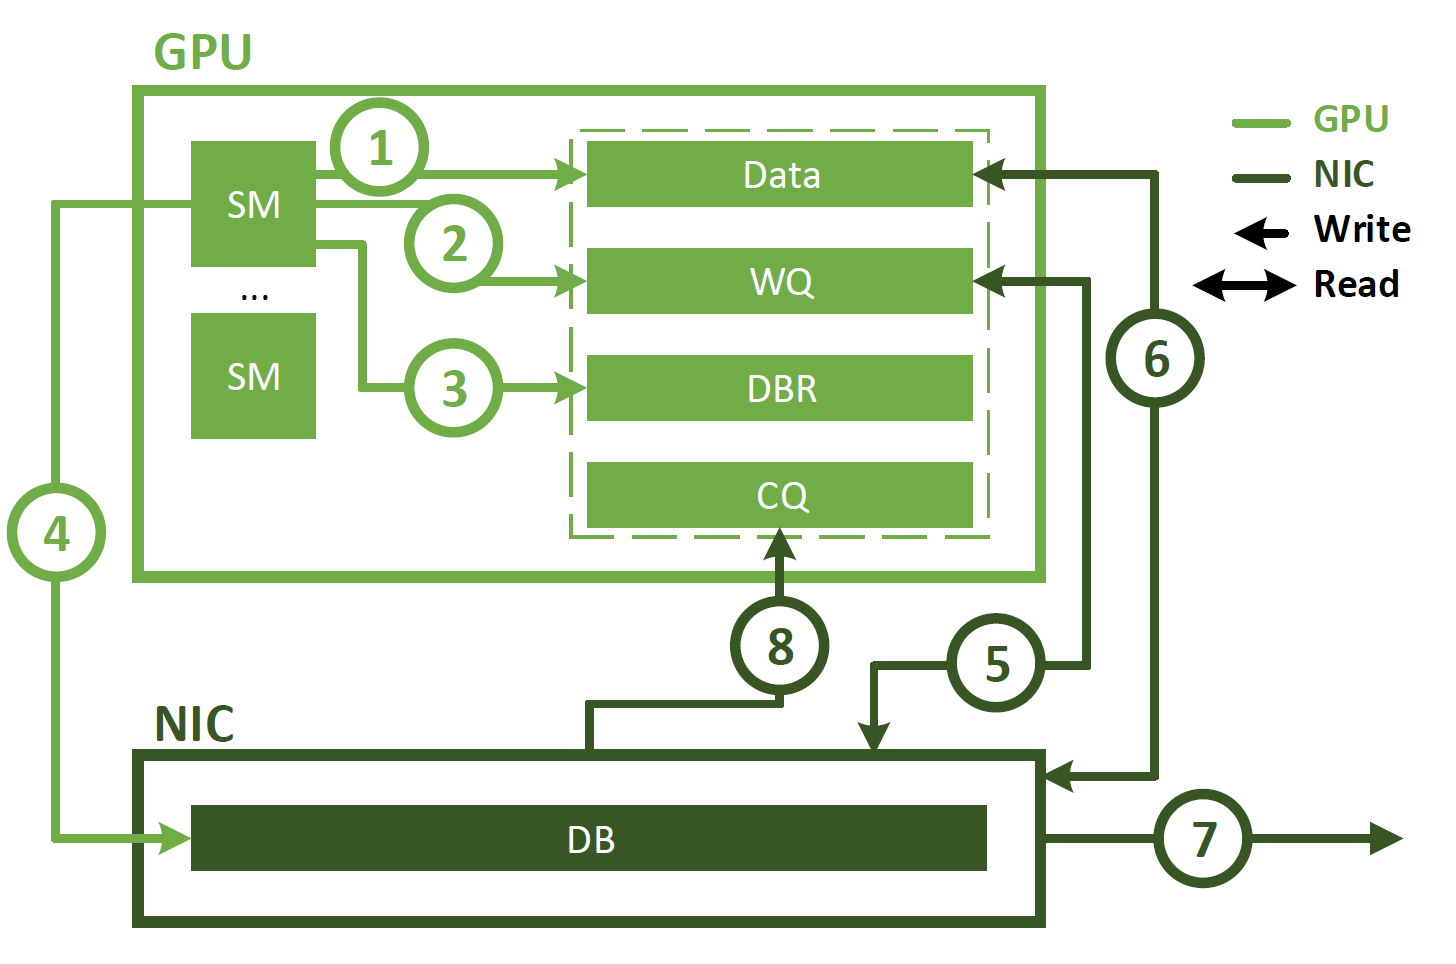
- 应用唤起一个cuda核,生产数据到GPU内存中。
- 应用调用NVSHMEM操作,与其他处理单元进行通信。NVSHMEM操作将使用一个SM(流式多处理器, streaming multiprocessor),创建一个NIC工作描述符,直接写入到WQ缓冲区中。与CPU代理方式不同,WQ缓冲区位于GPU内存中。
- SM更新DBR缓冲区,位于GPU内存中。
- SM通过写入NIC的DB寄存器来通知NIC传输信息。
- NIC读取工作标识符,获得WQ缓冲中的操作,来进行GDR。
- NIC读取数据。进行GDR。
- NIC直接传输数据并写入远程节点。
- NIC通过写入CQ来通知GPU已经完成操作。
- 这样,我们通过更改RunD hypervisor, 通过类似的方式注册DB的IO内存到IOMMU的页表中。这样不仅实现了隔离性,也能通过PVDMA动态按需求固定内存,加速启动时间。
eMTT: 拓展内存转换表
将RDMA网卡内的内存转换表进行拓展,记录一段内存地址的设备类型。这样允许RNIC绕过PCIe总线不必要的内存地址映射查询,以及持续提供良好的GDR表现。
- 受限于PCIe地址翻译缓存,RNIC的针对IOMMU的多余的请求需要重新取回地址,造成较高的缺失率,从而导致性能波动。
- 并且,MTT-ATC两层的非间接翻译是没有必要的(回顾上面的图,我们运行在rund容器里的cpu需要通过PCIe switch,在RNIC中进行GVA-GPA(MTT),GPA-HPA(ATC)的两次映射翻译)。我们可以直接缓存最终的翻译结果来绕过ATC缺失问题。
- MTT位于RNIC中,相对于PCIe的ATC的容量更大,因此我们拓展了MTT来实现这样的缓存。eMTT不仅仅存储内存映射,也存储内存的所有者(主存或者GPU)。
stellar将会管理两种不同的DMA操作,例如下图所示。其具体的写操作流程如下。
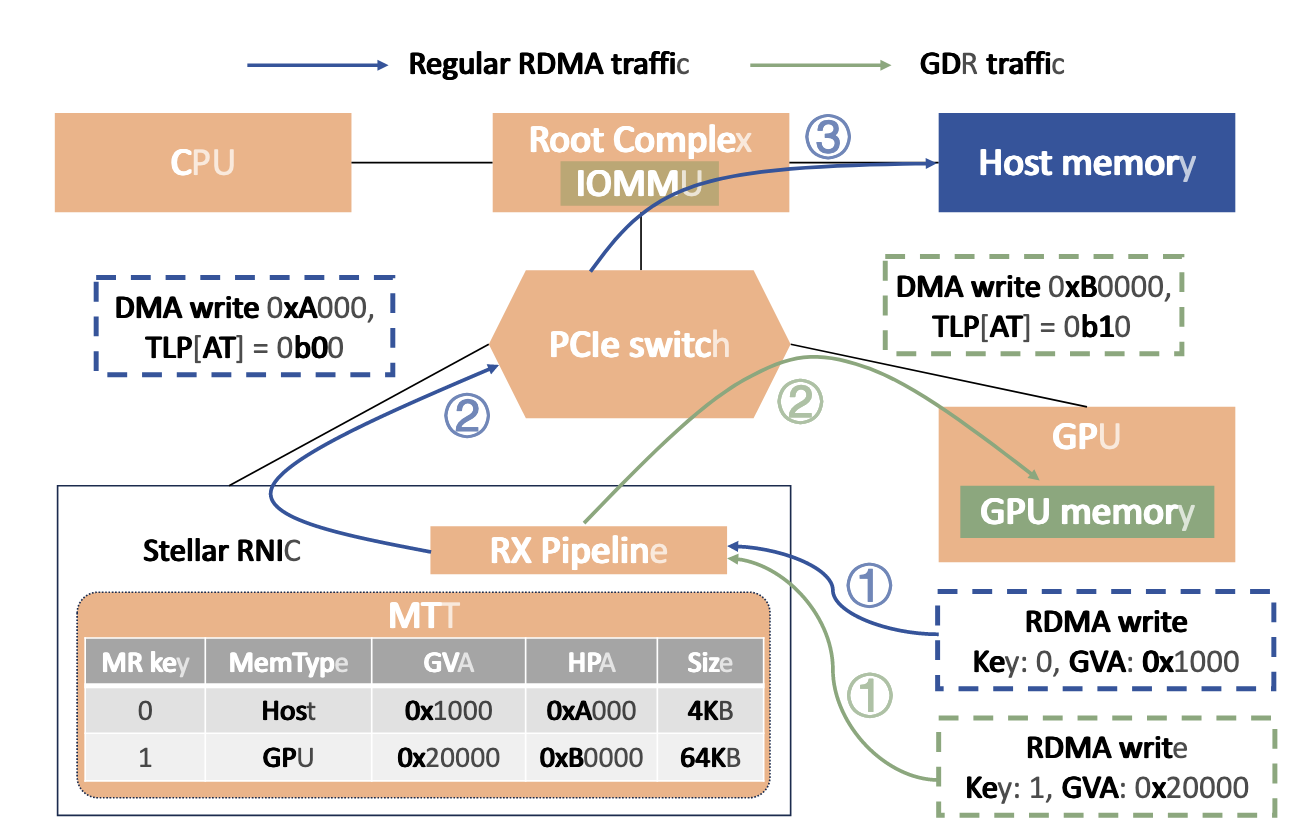
对于一个GDR写操作,我们有以下的步骤:
- 报文到达RNIC的RX流水线。从eMTT中找到GVA到HPA的映射和内存类型,目标内存类型是GPU。因此将PCIe中的传输层报文中的地址翻译段记做0b10。
- 当报文到达PCIe交换机时,发现地址翻译字段为0b10,因此直接通过RC转发给目标GPU。
对于一个RDMA写操作,目标是主机内存。
- 报文到达RNIC RX流水线。基于eMTT中的映射和内存类型,我们将PCIe传输层报文的地址翻译段记做0b00。
- 报文到达PCIe交换机,发现地址翻译段为0b00,立刻转发给RC。
- IOMMU在RC中进行最终地址转换后转发报文到主机内存中。
eMTT的表现
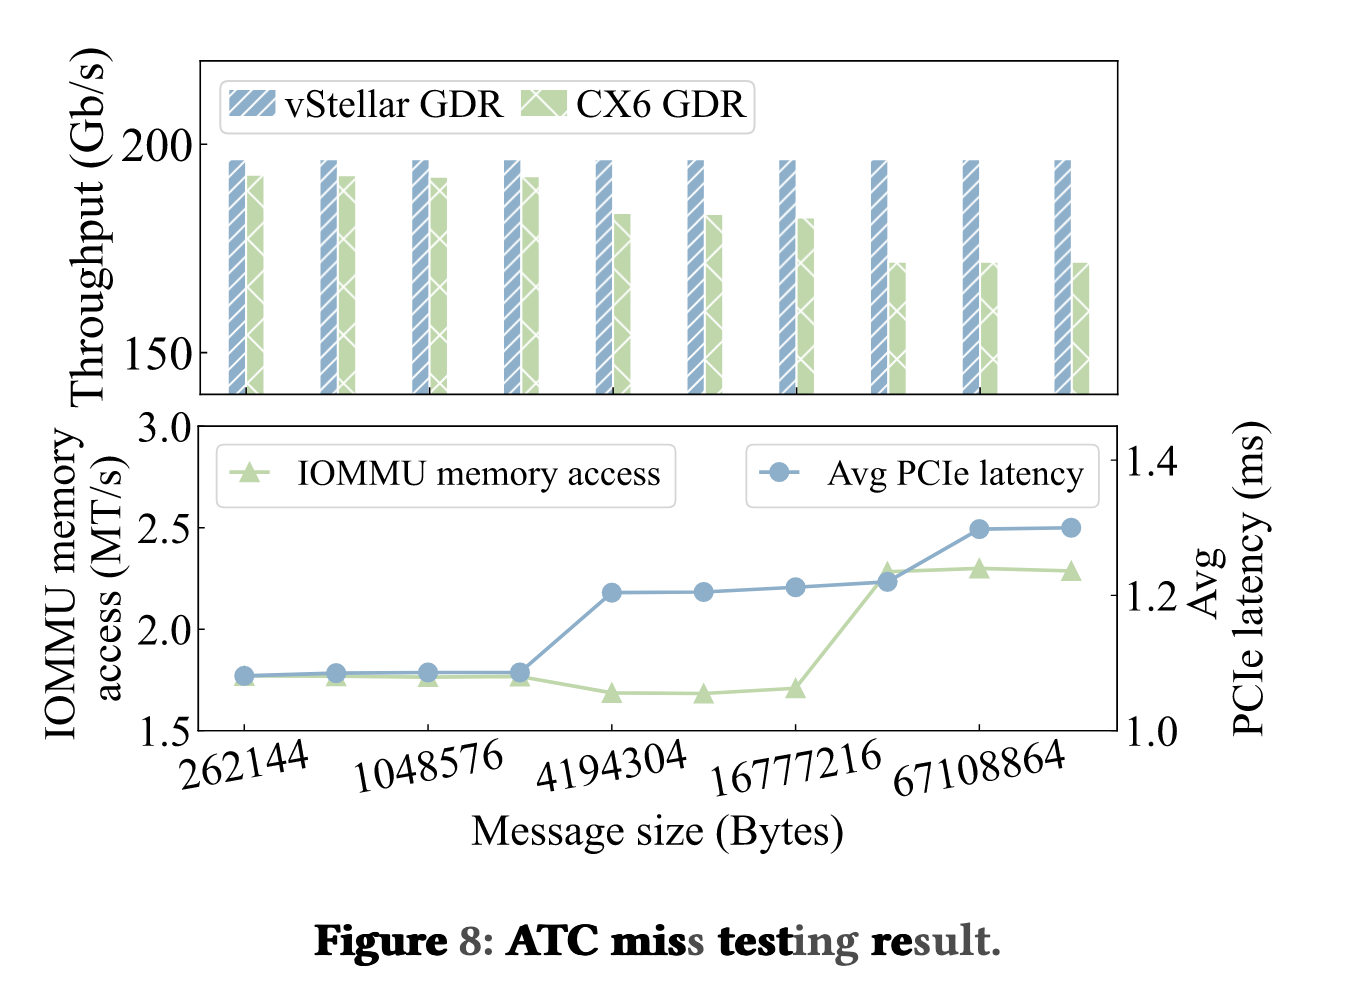
作者对比了stellar和标准PCIe地址翻译服务/缓存的性能,通过不同的消息大小衡量了GDR吞吐率与IOMMU内存读取-PCIe延迟的对比。
RDMA Packet Spray
提供了原生的多路RDMA解决方案,来尽可能利用可用的等价网络通路。可以智能地将RDMA报文散布到这些通路上,并且更好地处理乱序报文。
工业界与学术界都提出了很多方法进行负载均衡来减轻网络内的哈希冲突/网络拥塞问题。这些解决方式可以分类成以下四种方式:(更加细节的分析可以参考这篇文章,来自公众号“网络虚拟化技术”:文章接下来论文简要介绍了以下负载均衡的方式。
- 流量工程TE(traffic engineering)。
- 一般采用了中心化的控制器,动态地基于实时工作负载和网络拓扑进行优化。这种方式利用了LLM训练任务的持续性和重复性,将比静态ECMP/路径固定解决方案更好。
- 然而,依赖于固定的流量/拓扑模式,TE是针对单租户问题的好方案。但其在遭遇链路故障,多租户或动态工作负载时应对不佳。TE只能重新分布流,不能克服其根本性的限制。
- 小流交换FS(Flowlet Switching)
- 动态路由解决方案,通过监测一条流内的包和包之间的时间间隔,将一条流分成多个小流,并且将各个小流路由到不同的下一跳上。
- 但是,基于小流的方案很难解决RDMA的负载均衡问题,因为RDMA的流量模式与TCP不同,并没有足够大的不活跃间隔时间。
- 尽管如此,该方法仍然具有简洁性和兼容性,在老一代的GPU集群上也可以如此部署。
- 自适应路由(Adaptive Routing)
- 自适应路由也称为包散列(Packet Spraying),是交换机策的动态多路算法。
- 启动了AR的交换机将基于链路的状态会动态选择一个端口输出传入它的报文。来自相同RDMA连接的报文可以跨过多条路径,到达目标RNIC。
- 目标RNIC必须进行乱序报文的处理,因为报文从不同的路径到来,将出现乱序问题(每条链路的延时将有所不同)。
- AR可以实现粗粒度的负载均衡,细粒度的拥塞避免。然而,基于交换机的解决方案在作者的案例中仍然不优于网卡侧的多路方案,因为AR带来了网络监控/诊断方面的巨大挑战,因为相同头部的报文(相同五元组)将会在很短时间内经过不同的多条路径。
多路算法的选择
大规模LLM训练任务具有均衡,规则,高通量,规整的流量模式。作者沿用sigcomm'24提出的HPN(双平面轨优化)网络拓扑,在ToR和汇聚层提供隔离的,丰富的多路模式。
然而面对大规模,高度耦合,长时间运行的LLM任务,对性能波动非常敏感,并且GPU集群极易趋向于失败。
因此,多路算法必须在保证性能平稳,不易故障的同时降低通信时间。因此主要设计的多路算法应该满足以下三个目标:
- 将大型流均衡地分布到所有可用的等价道路上;
- 保证集群对链路翻转(link up <-> down)与故障具有弹性解决能力。
- 容易在硬件上部署。
接下来主要就是对多种主流方法的测试。采用的方法有:BestRTT/RR/DWRR/MPRDMA/OPS(原文这里是笔误吗我不太清楚。。。)(OPS 就是采用Packet Spray但是不感知链路状态或拥塞延迟)。经过测试发现128路的OPS算法相较于其他的算法在静态/动态网络环境中表现更好,并且有对于链路故障的弹性。
测试方法
- HPN7.0网络拓扑,每个服务器具有8GPU,4RNIC。每个RNIC具有两个200Gbps的端口。
- RNIC执行内部的,基于窗口的拥塞控制算法,基于ECN和RTT调整。
- RTO设置为 \(250\mu s\) 来监测丢包。
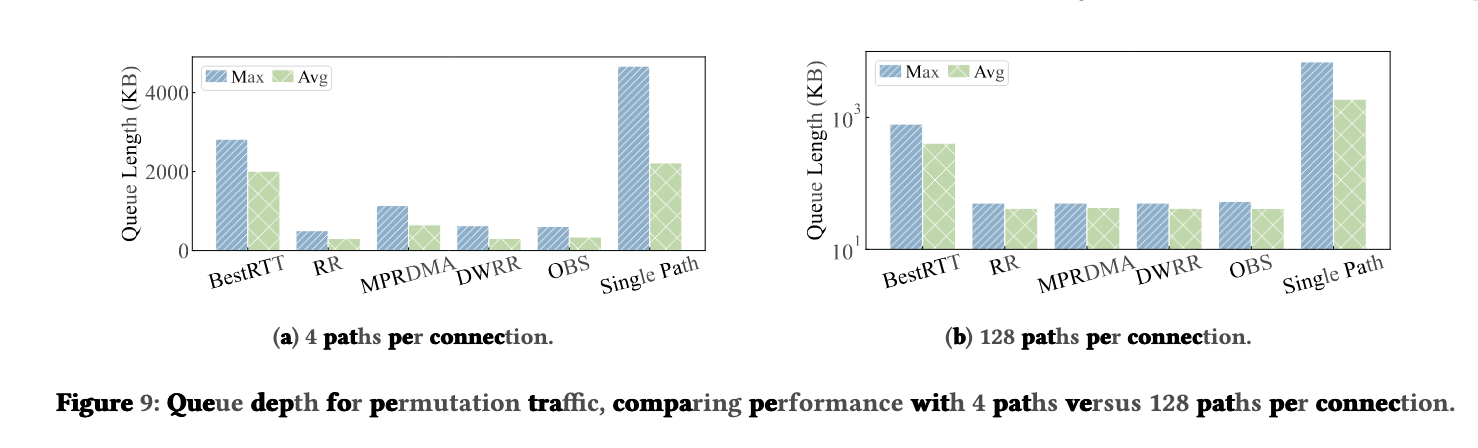
- 排列流量。表现如上图所示。30GPU服务器来自于两个网络段,注入排列RDMA写流量,创建120条流量。每个RNIC向随机的目的地发送流量,测试了4-路和128-路配置(是不是太少了)。在4路中,RR和OBS队列长度最小。128路下除了BestRTT外其他多路算法表现相近。
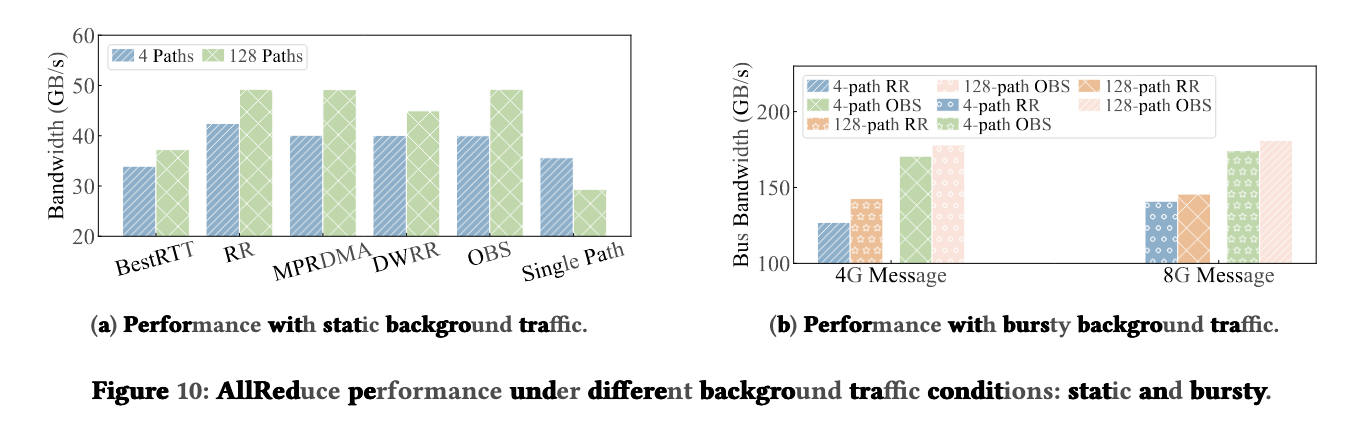
- 静态流量。512-GPU all-reduce流量中表现如上图所示。RR和PS都可以完全利用50GB/s的带宽,然而BestRTT和DWRR只能激活一小部分路径,导致拥塞和表现较差。
- 爆发式流量。循环跑5s all-reduce,然后暂停5s。OPS表现较RR更嗨,是因为OPS的伪随机选路与作者的CC算法更加易于交互。
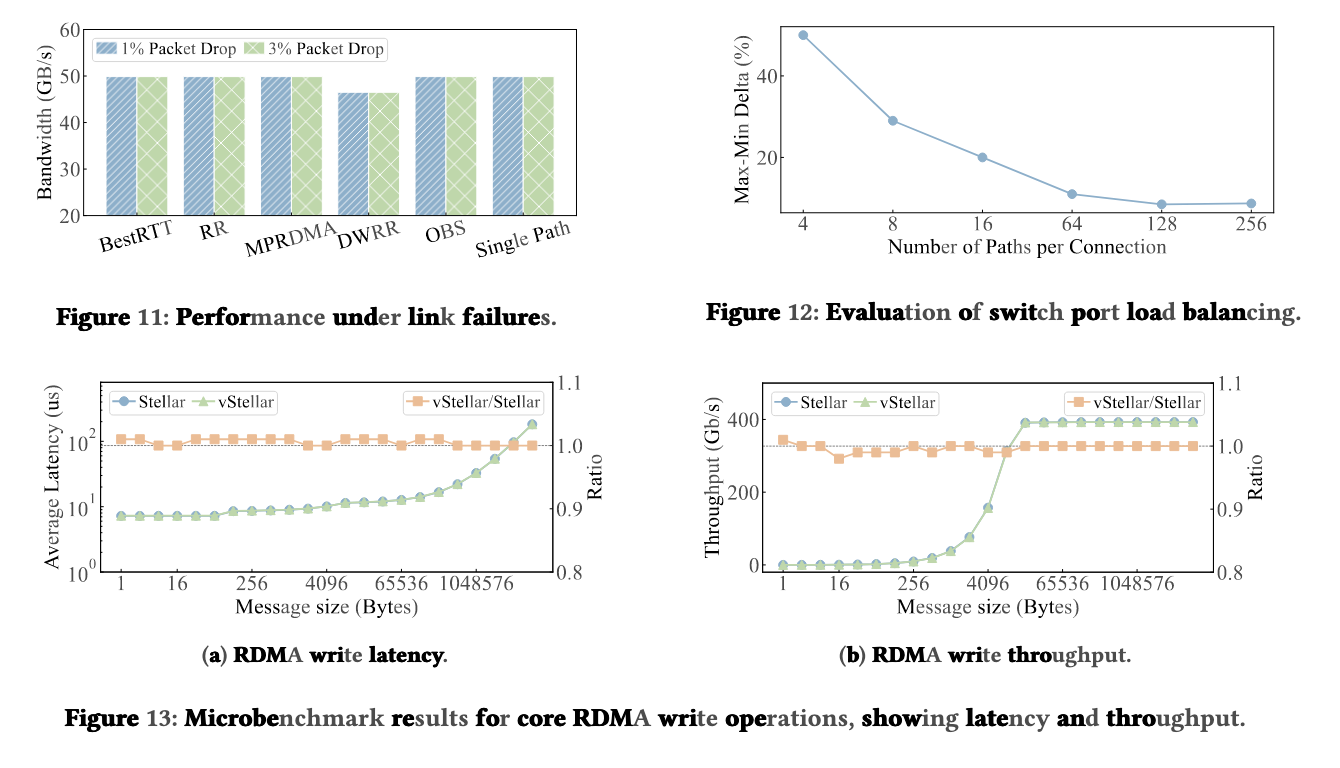
剩下就是链路故障,路径等价性的相关评估。
评估
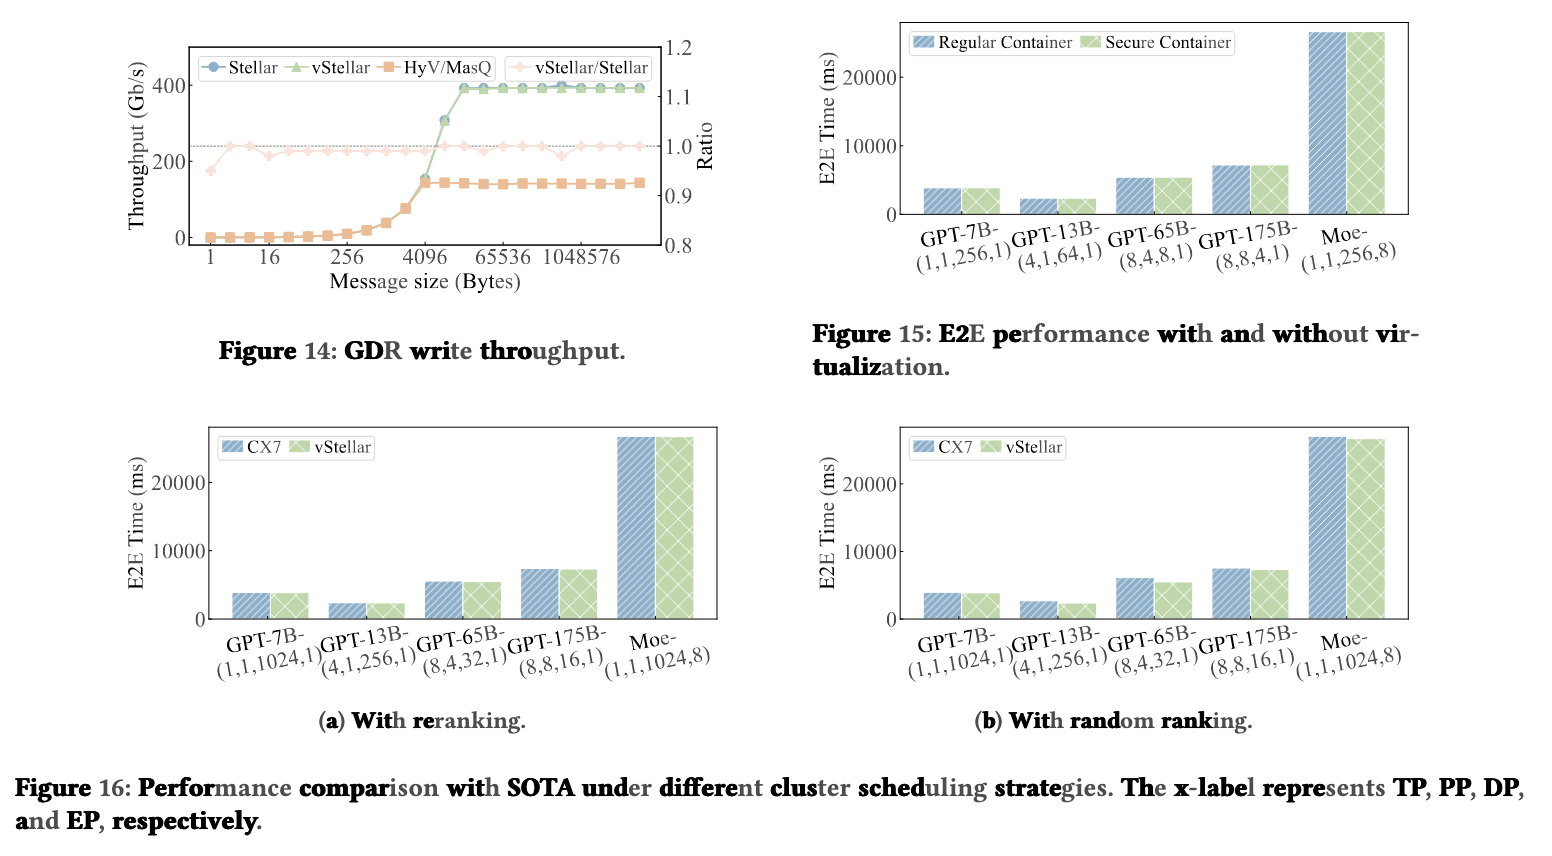
其实想看源码,但是好像没找到仓库~就放张图好了。
技术杂谈
Discussion部分还是很有意思的,因此我也看了看~



