





加班快乐...
与Deepseek-V3.1相比,新一般的架构更改仅仅在后续训练中引入了新的稀疏注意力机制DSA。
主要包括两个部分:一个ligtning indexer(索引器)和一个细粒度的token选择机制。
Step 1: 计算索引分数。
计算了 当前询问 Q token \(h_t\in \mathbb{R}^d\) 与一个 前序token \(h_s\in\mathbb{R}^d\) 的索引分数,决定了Qtoken将会选择哪一个token。
\[I_{t,s}=\sum\limits_{j=1}^{H^I}w_{t,j}^I\cdot\text{ReLU}\left(q_{t,j}^I\cdot k_s^I\right) \]
其中我们有:
作者选择了ReLU来提升吞吐率。即使lightning indexer仅有很少数量的头并且可以在FP8上部署,其计算效率也是非常显著的。
Step 2: 选择前k个索引分数最高的 \(c_s\), 计算注意力输出。
给定了索引分数 \(I_{t,s}\),我们的细粒度token索引机制将会仅仅取出那些具有前k个索引分数的token。随后,注意力输出 \(o_t\) 将会在当前Q token \(h_t\) 和稀疏化选出的 \(c_s\) 中进行。
\(c_s\) 其实是MLA中低秩投影计算出来的向量,用于减少KVCache的存储开销,提高推理效率。
\[u_t = \text{Attn}(h_t,\{c_s\,|\, I_{t,s}\in\text{Top-k}(I_{t,:})\}) \]
下面是新旧结构的对比。上图为新的结构。下图为曾经的旧结构。
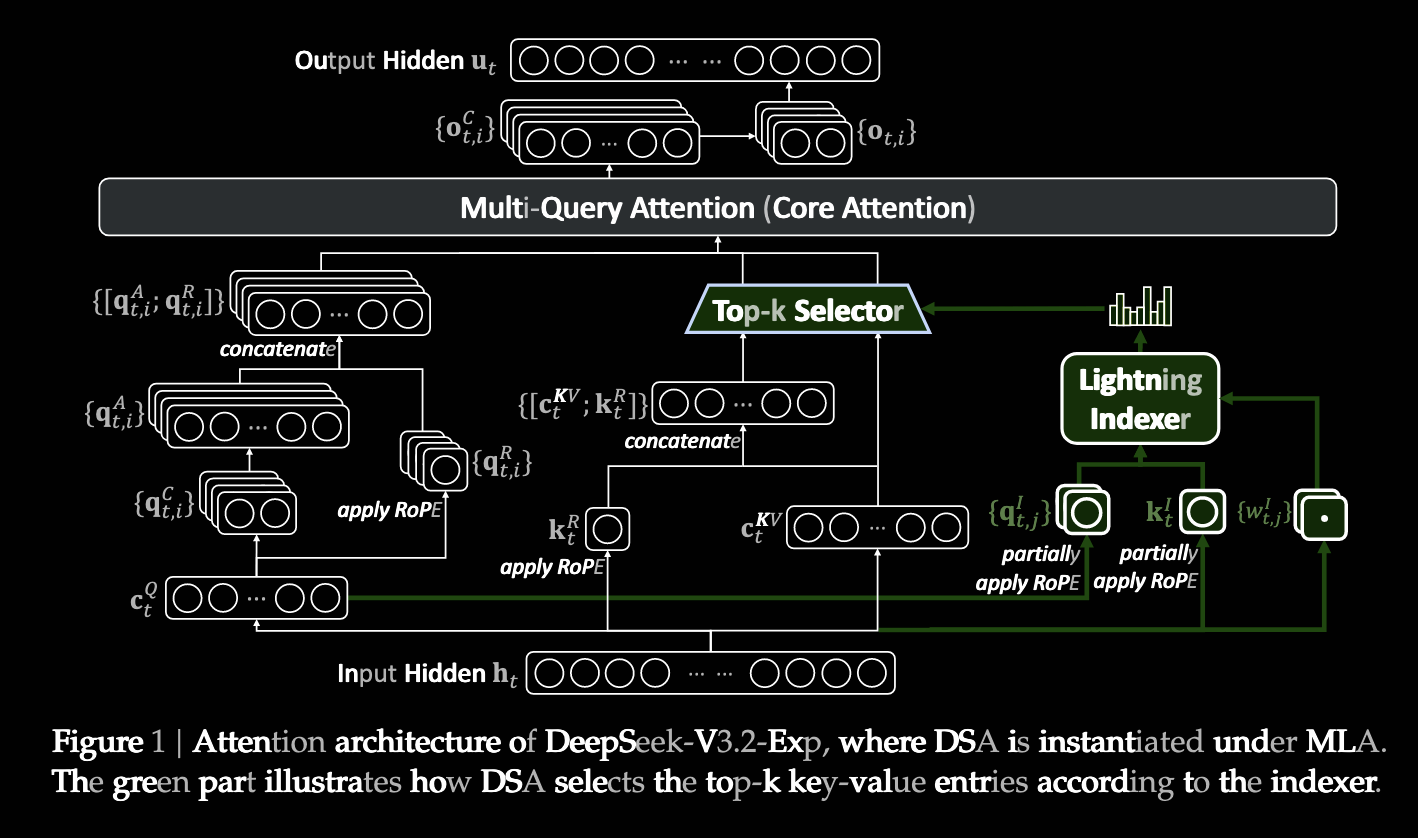
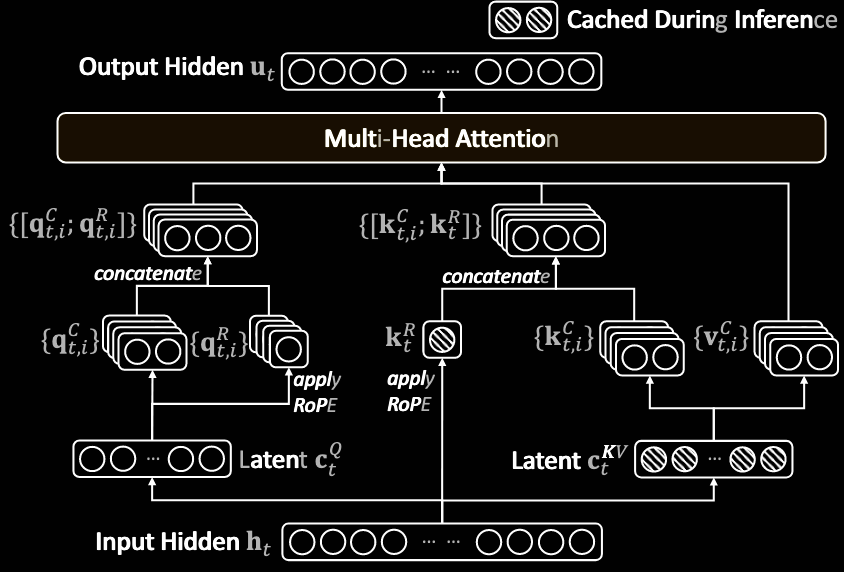
为了考虑从v3.1继续训练,需要基于MLA上实例化DSA。在kernel层面,每一个KV项都需要在多个查询之间共享,提升计算效率。因此,我们在MLA的MQA模式上部署了DSA。这样每一个潜在层(latent vector)将会在每个头之间共享(多个头共用一个潜在向量 \(c_i\), 也就是多个头——多个Query, 共用一个KV)。

从v3.1-Terminus 后继续训练,上下文长度扩展到128K。
用于初始化lightning indexer。继续保持稠密注意力机制,其余参数全部冻结,仅剩下lightning indexer进行训练。
为了保持indexer输出与原先的主要注意力分布对齐,对于第t个查询token,我们首先将多个头的主要注意力分数进行相加,然后在序列维度上进行 L1-正则化,生成目标分布 \(p_{t,:}\in\mathbb{R}^t\). 基于 \(p_{t,:}\), 我们设置一个 KL-散度 loss作为我们训练indexer的优化目标。
\[\mathcal{L}^I = \sum\limits_{t}\mathbb{D}_{KL}\left(p_{t,:}||\text{Softmax}(I_{t,:})\right) \]
作者声称采用了 \(10^{-3}\) 的学习率训练了1000步。每一步具有128K长度的16个序列,总共2.1B个token。
在进行稠密训练之后,进入到了细粒度的token选择,并以此来优化整体模型的参数,来获得DSA的稀疏模式。在这一阶段,我们不在选择所有的token,而是通过上文的方式选择通过indexer判断出来的,索引分数最大的K个token:
\(\mathcal{S}_t=\{s\,|\,I_{t,s}\in\text{Top-k}(I_{t,:})\}\)
\[\mathcal{L}^I = \sum\limits_{t}\mathbb{D}_{KL}\left(p_{t,S_t}||\text{Softmax}(I_{t,S_t})\right) \]
需要值得注意的是我们将indexer的输入从计算图中分离,也就是分开indexer和DSA的其他部份,分别进行优化。
稀疏训练采用学习率 \(7.3\times 10^{-6}\),每个query选择2048个KV token。训练15000步,具有480个长度为128K的token,总共是943.7B token数量。
后训练与先前deepseek-v3的后训练类似,主要有两步:

此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。