惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

H
Help Net Security
腾讯CDC
爱范儿
爱范儿
Google DeepMind News
V
V2EX
Blog — PlanetScale
Blog — PlanetScale
Engineering at Meta
Engineering at Meta
GbyAI
GbyAI
量子位
F
Fortinet All Blogs
G
Google Developers Blog
T
The Blog of Author Tim Ferriss
Cyber Security Advisories - MS-ISAC
Hugging Face - Blog
Hugging Face - Blog
Last Week in AI
Last Week in AI
T
Tailwind CSS Blog
J
Java Code Geeks
S
SegmentFault 最新的问题
D
Docker
博客园 - 司徒正美
The GitHub Blog
The GitHub Blog
Jina AI
Jina AI
M
MIT News - Artificial intelligence
博客园 - 【当耐特】

郑文峰的博客

使用dify对接飞书多维表格 使用n8n对接飞书多维表格 服务启动时出现 OOM 一次服务升级时pg表DDL执行超时失败 Go语言高效IO缓冲技术详解 Go语言延迟初始化(Lazy Initialization)最佳实践 Go语言字符串拼接性能对比与优化指南 Go语言结构体内存对齐完全指南 Go语言空结构体:零内存消耗的高效编程 Go语言堆栈分配与逃逸分析深度解析 Go语言原子操作完全指南 Go语言内存预分配完全指南 Go语言不可变数据共享:无锁并发编程实践 Go语言零拷贝技术完全指南 Go语言遍历性能深度解析:从原理到优化实践 Go语言Interface Boxing原理与性能优化指南 Go协程池深度解析:原理、实现与最佳实践 使用etcd分布式锁导致的协程泄露与死锁问题 基于pre-commit的Python代码规范落地实践 初识 MCP Server pulsar阻塞导致logstash无法接入日志 django-prometheus使用及源码分析 kube-proxy源码分析 kubernetes service如何通过iptables转发 tcp缓存引起的日志丢失 django-apschedule定时任务异常停止 理解calico容器网络通信方案原理 理解flannel的三种容器网络方案原理 理解Linux IPIP隧道 理解VXLAN网络
redis之主从库同步
zhengwenfeng · 2022-12-01 · via 郑文峰的博客

# 0. 前言

在单点故障后,我们需要保证服务不间断,所以需要使用冗余的副本提供集群服务,从而达到服务的高可用。redis 提供了主从库数据同步机制,从而保证数据副本的一致性,而主从库使用的是读写分离的机制。

# 1. 读写分离模式

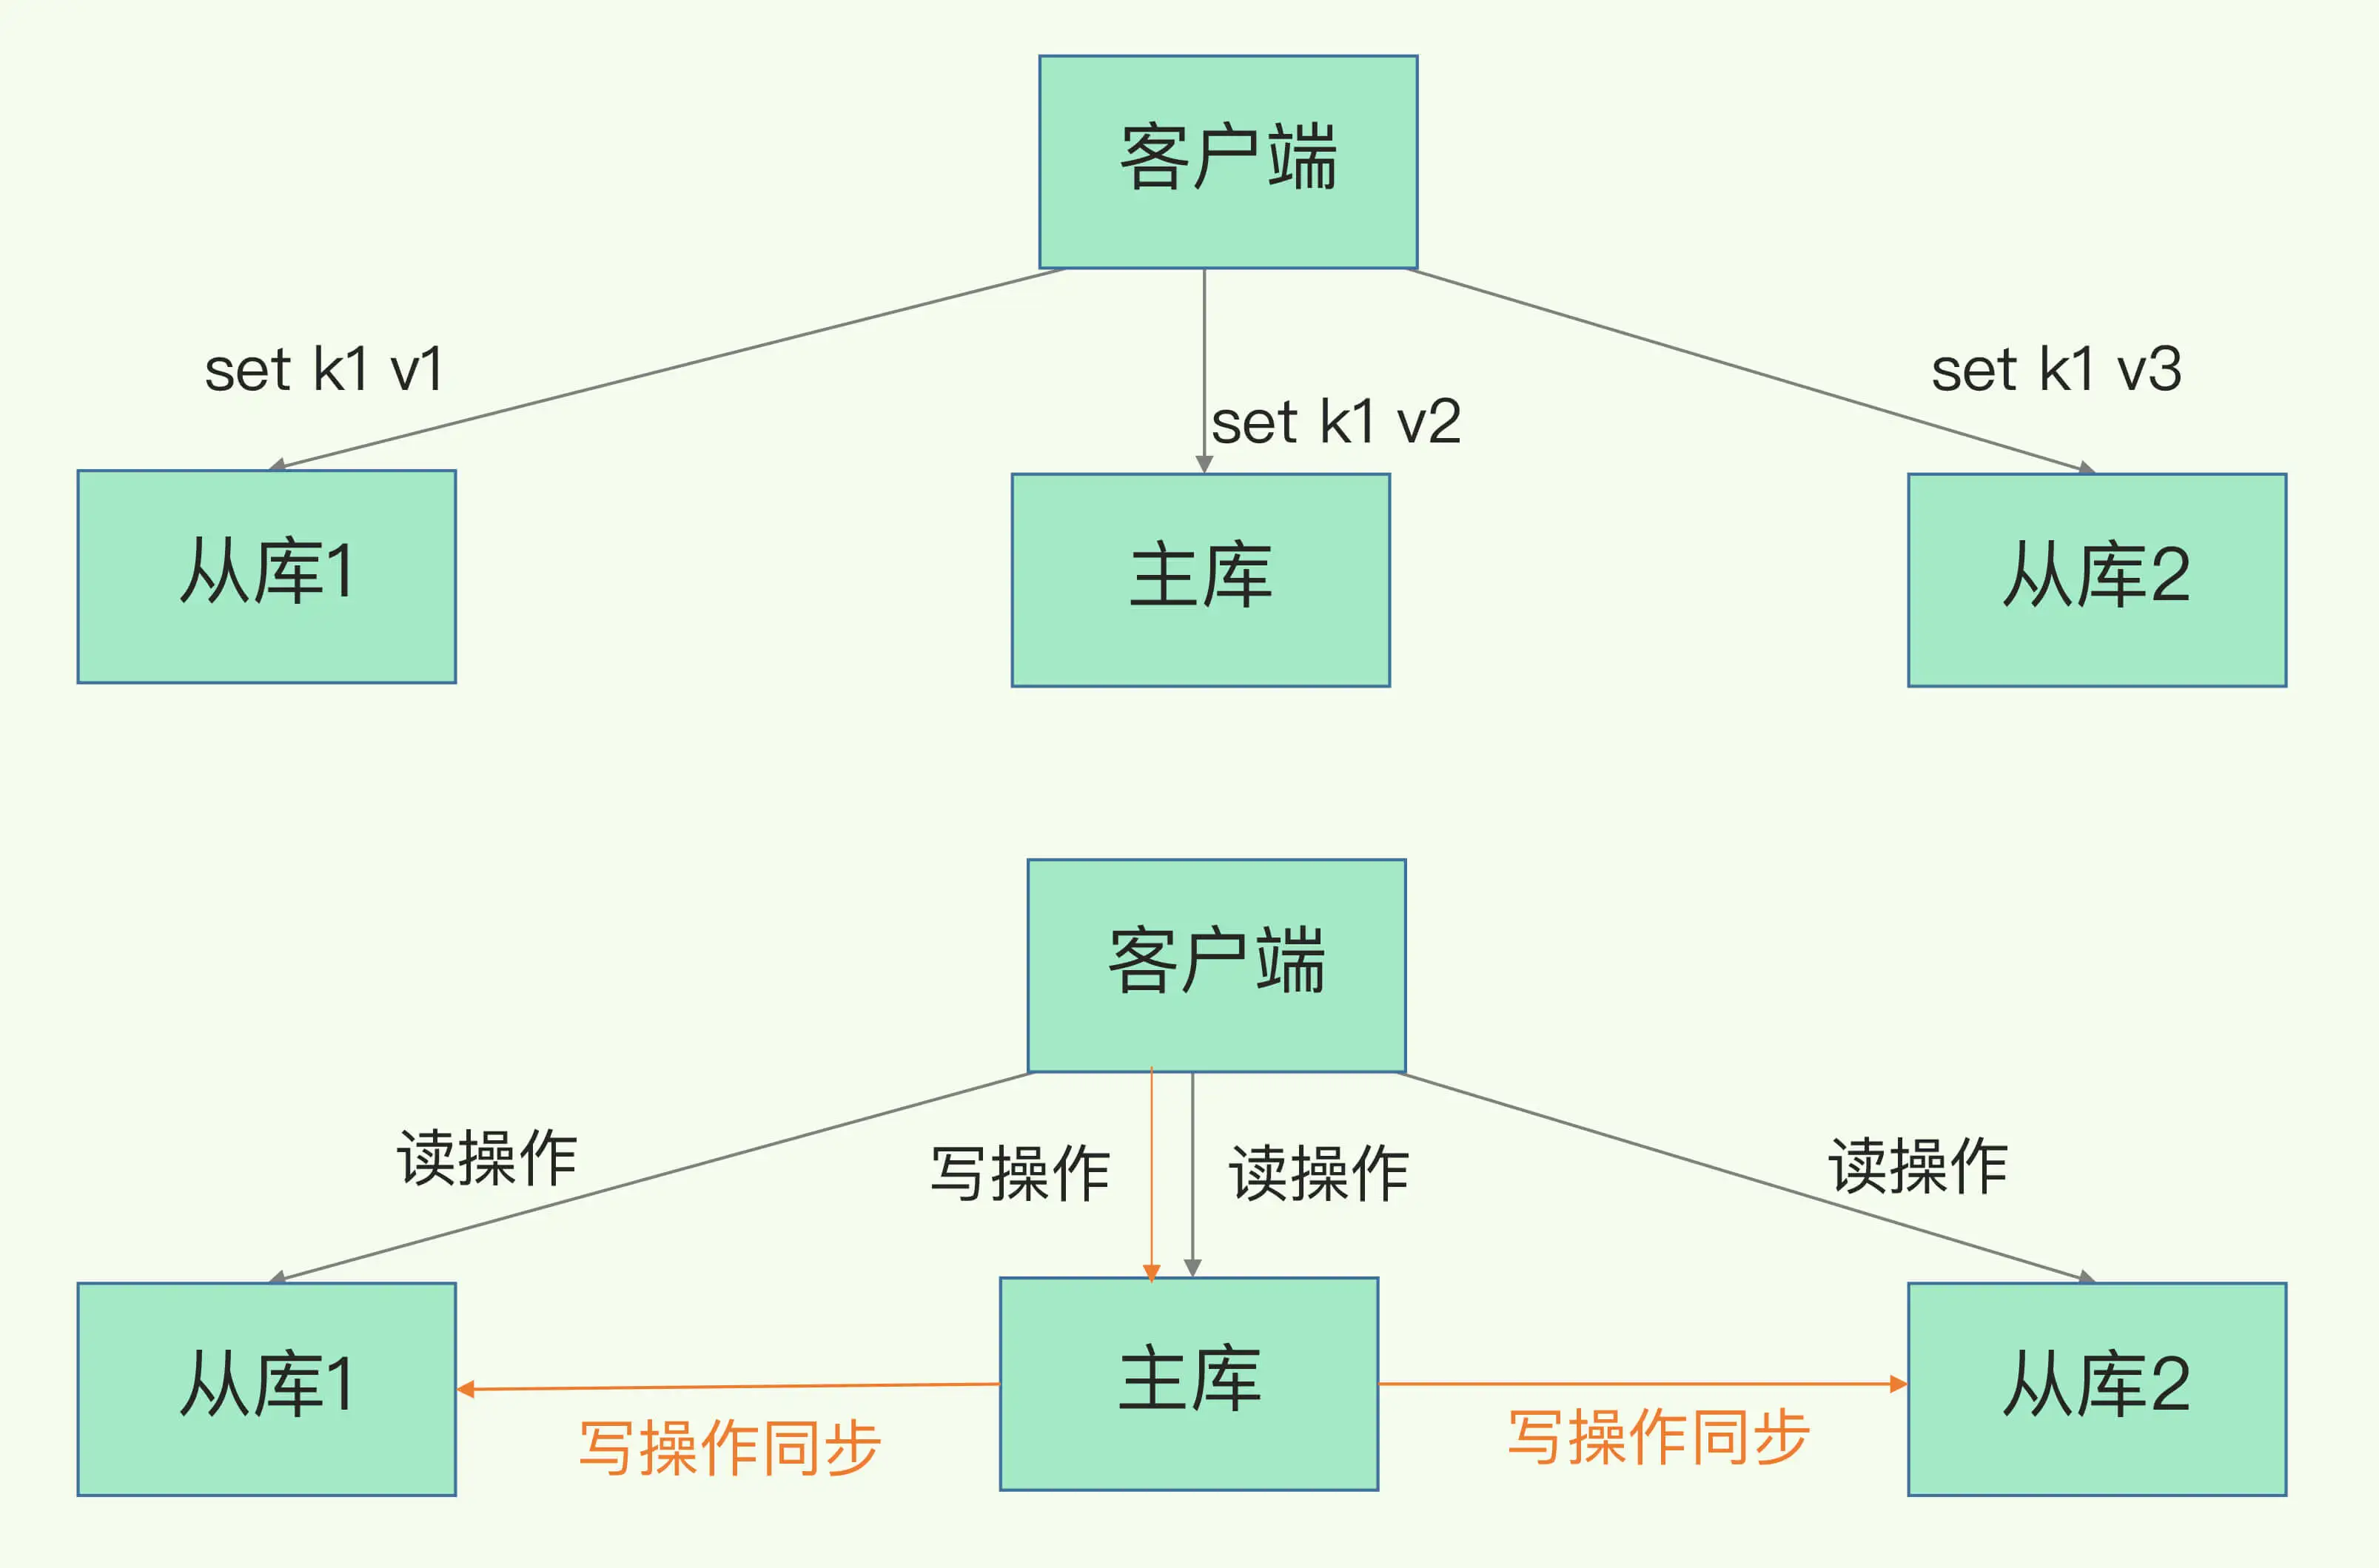
通过该模式构建多个数据副本,使用读写分离的方式

  • 读操作: 主从库都可以进行读取。
  • 写操作: 先写入到主库,在同步到从库。

为什么要读写分离呢?

如果从库也可以进行写操作,那么主从库在同一个 key 中存储的值可能会不一致,如果要保证一致性,需要通过加锁来解决,但这样会造成性能的损耗。

但如果只有主库写入,在同步给从库,则能保证所有实例中数据的一致性。

# 2. 全量复制

# 2.1 主从库同步的过程

第一阶段

从库向主库发送psync命令进行数据同步,该命令包含主库的runID和复制进度offset

  • runID,每个实例自动生成的随机 ID,第一次从库不知道主库 runID,设置为?
  • offset,记录复制的进度,第一次进度设置为-1

主库会回复 runID 和 offset 给从库

第二阶段

主从第一次同步是采用全量复制的方式,主库生成 RDB 文件,然后发送给从库,从库清空当前数据再读入 RDB 文件完成第一次同步。

在生成 RDB 文件时,还是会有新的操作的会进行,为了保持数据的一致性,会将新的操作记录到 replication buffer 中。

第三阶段

RDB 文件发送到从库后,再 replication buffer 中的操作再发送给从库。

# 2.2 如何减少主从同步时,对主库的压力?

主从同步有哪些压力?

  • 生成 RDB,这个操作会 fork 子进程,会阻塞主线程的正常请求。
  • 传输 RDB,会占用主库的网络带宽

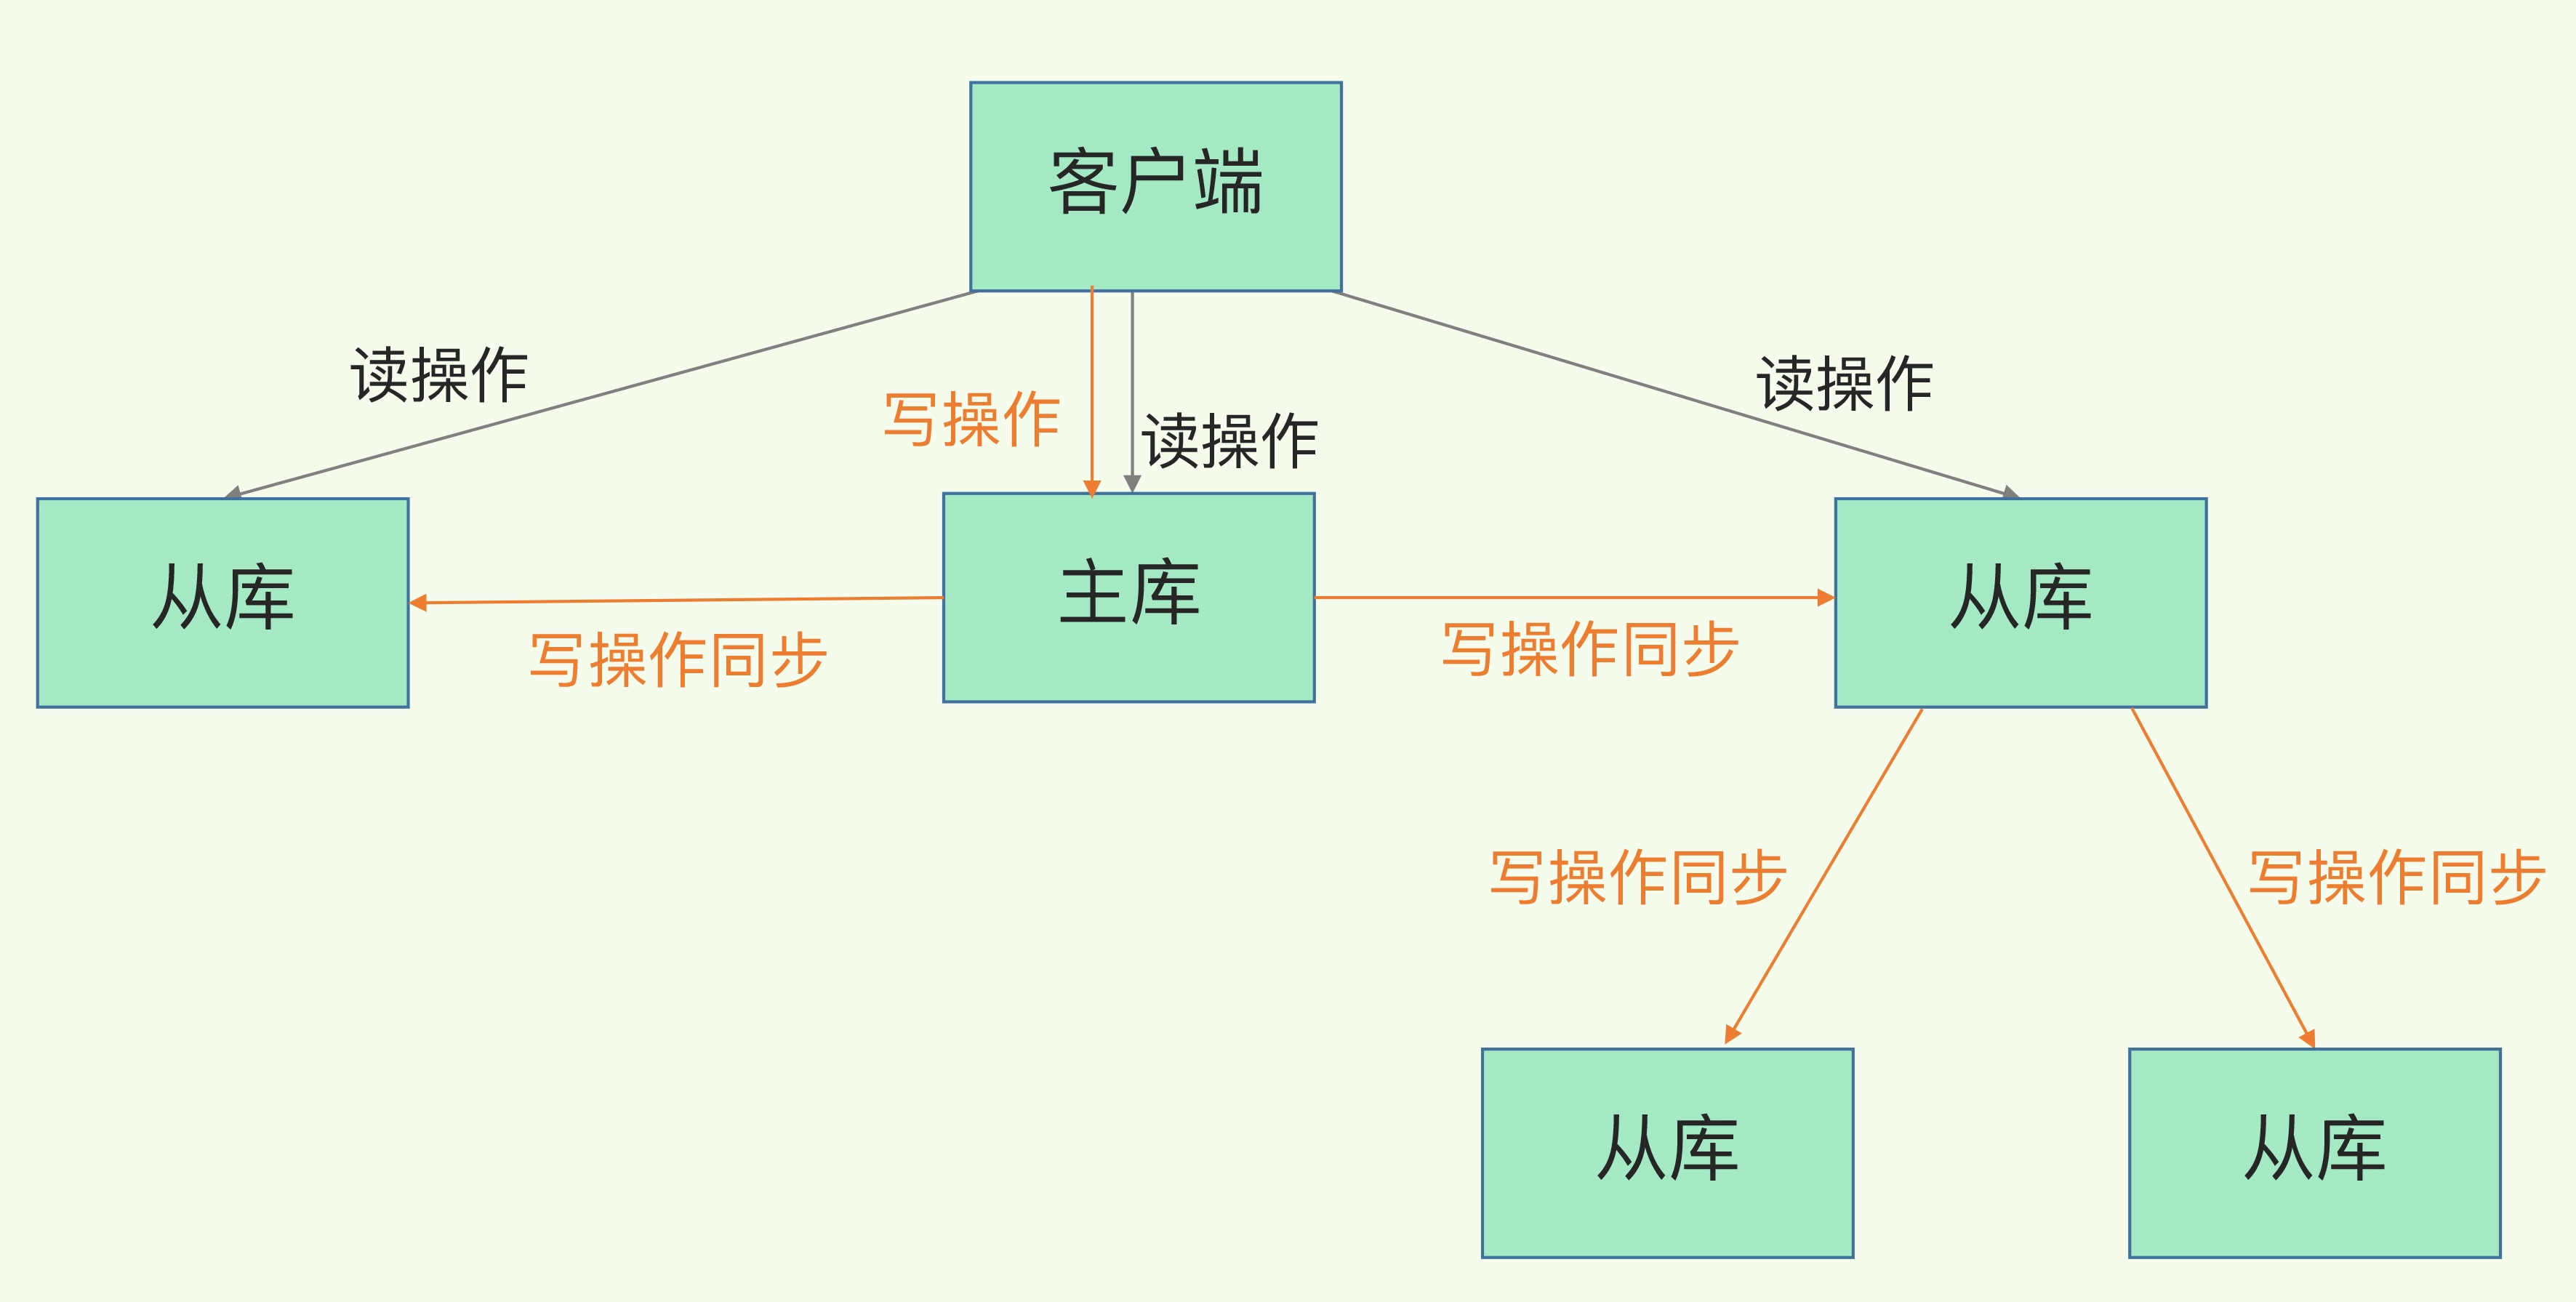
主-从-从模式

可以手动选择一个从库(比如选择内存资源配置较高的从库),用于级联其他的从库。由从库生成 RDB 再传输给从库,减少了主库的压力。

在主库全量复制之后,会维护一个长连接,后需的操作命令通过该连接同步给从库
# 3. 增量复制

全量复制是通过生成 RDB 发送到从库然后进行读取后进行同步。我们知道生成 RDB 本身就是一个消耗 CPU 的操作,并且存在阻塞主线程的风险,所以我们需要尽量少的执行全量复制的操作。

所以在第一次使用 RDB 全量复制后,主从库会建立一个长连接,主库收到的新命令会再同步到从库,这样就避免频繁全量复制。

但是有一个风险点是,如果过程发生了网络中断或者阻塞,该如何解决?

# 3.1 增量复制的过程

当主从连接时,会将新的操作的命令写入 replication bufferrepl_backlog_buffer 缓冲区中

repl_backlog_buffer 是一个环形缓冲区,主库会记录当前的偏移量 master_repl_offset,记录自己写到的位置,而从库在上面也有对应的偏移量 slave_repl_offset,记录自己正在读到的偏移量。

在恢复连接时,从库会通过 psync 命令将自己的偏移量 slave_repl_offset 发送给主库,主库会将 slave_repl_offsetmaster_repl_offset 之间的命令同步给从库即可。

举了例子: 主库和从库之间相差了 put d e 和 put d f 两个操作,在增量复制时,主库只需要把它们同步给从库,就行了。
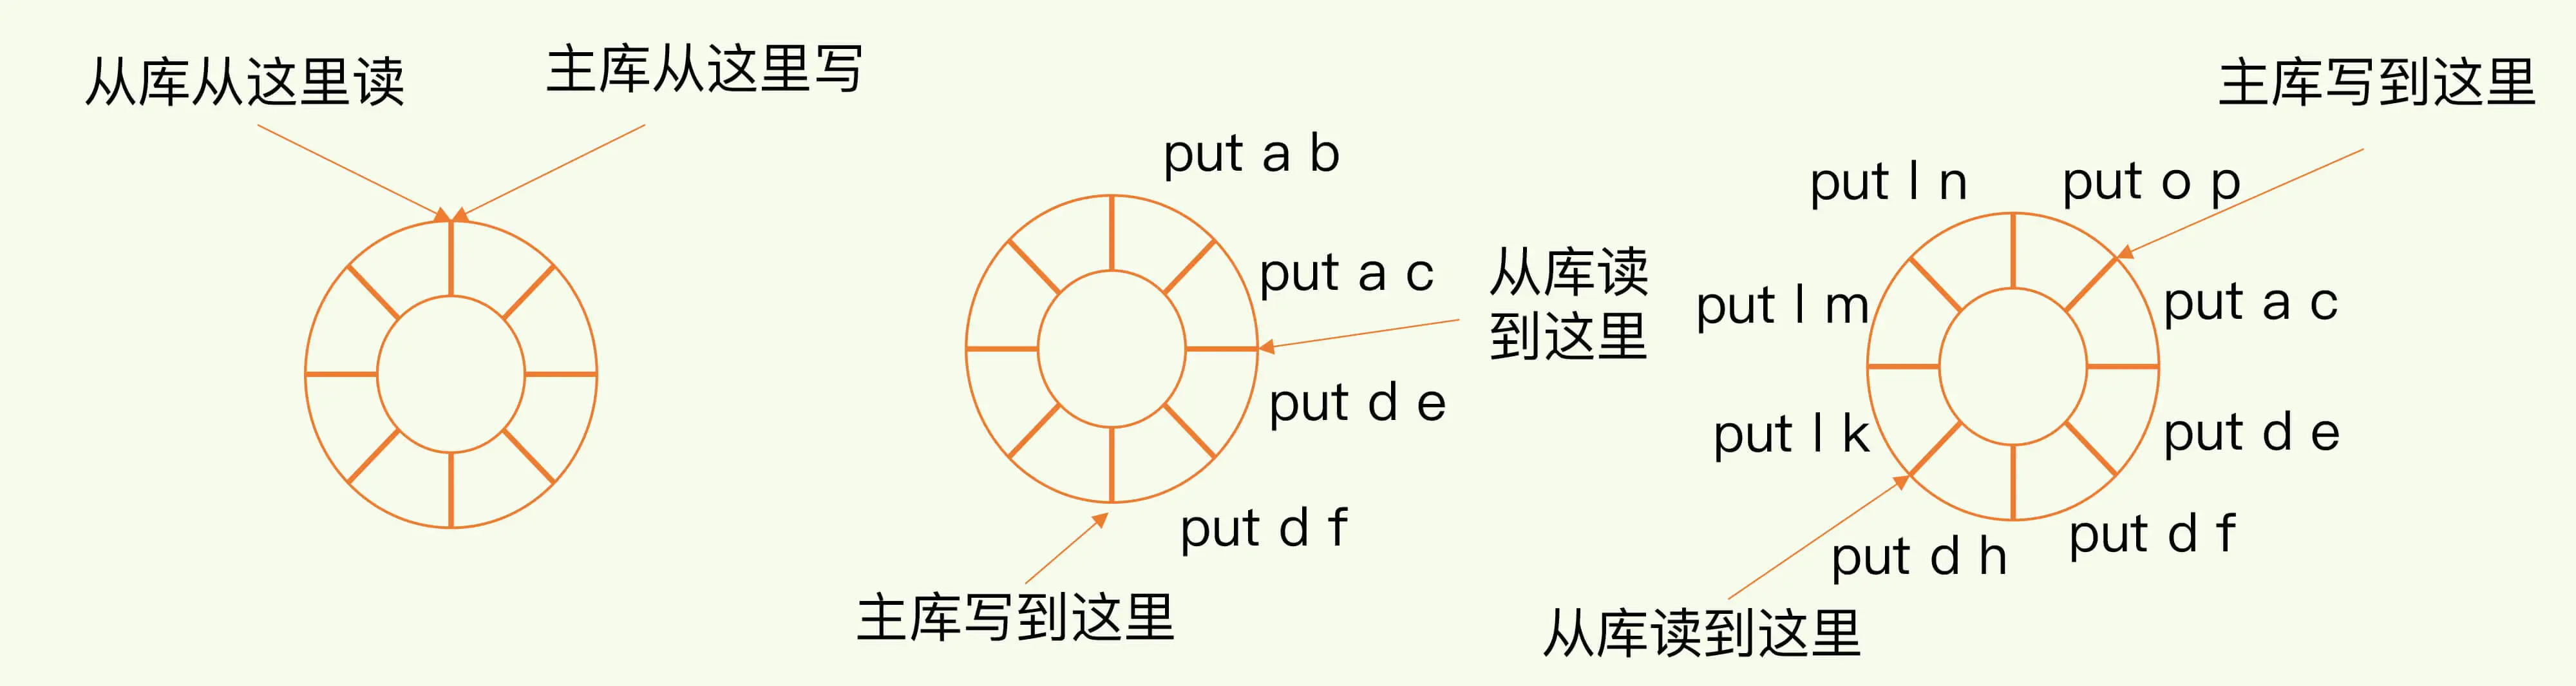
因为 replication buffer 是一个环形的缓存,当主从库长期断开时,是有可能被覆盖掉旧的数据,这个时候是会重新发起全量复制,主库根据从库发送的 slave_repl_offset 来判断是增量还是全量的复制。

那为什么全量复制使用 RDB 而不是使用 AOF 呢?

  • RDB 文件是经过压缩的二进制文件,AOF 文件是记录每一次的操作,包含对同一个 key 的多次冗余操作,文件比 RDB 要大的多,使用 AOF 可以减少带宽
  • RDB 是二进制数据,从库还原速度快。而 AOF 需要依次重放每一个命令,恢复速度慢。

# 4. 参考文章

  • 本文主要是学习《极客时间-redis 核心技术与实战》专栏总结而来