


惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

V
V2EX
博客园 - 叶小钗
WordPress大学
WordPress大学
N
Netflix TechBlog - Medium
M
MIT News - Artificial intelligence
美团技术团队
aimingoo的专栏
aimingoo的专栏
博客园_首页
奇客Solidot–传递最新科技情报
奇客Solidot–传递最新科技情报
Microsoft Security Blog
Last Week in AI
Last Week in AI
The GitHub Blog
The GitHub Blog
小众软件
小众软件
T
Tailwind CSS Blog
Martin Fowler
Martin Fowler
B
Blog RSS Feed
月光博客
月光博客
量子位
H
Hackread – Cybersecurity News, Data Breaches, AI and More
Hugging Face - Blog
Hugging Face - Blog
IT之家
IT之家
Y
Y Combinator Blog
B
Blog
MyScale Blog
MyScale Blog

StudyingLover's Blog

Diffusion Policy笔记 rwkv笔记 act笔记 nanovllm-block_manager opencode多智能体 nanobot-pre-train nanobot-rl nanobot-sft nanobot-checkpoint_manager nanobot-gpt nanobot-mid-train Vision Mamba (Vim)笔记 BPE演示 最后一遍学习Transformer YOLOv5 目标检测笔记 下载根服务器解析记录 Dynaseal A Backend-Controlled LLM API Key Distribution Scheme with Constrained Invocation Parameters 判断链表有环 王道25数据结构勘误 关于perplexity的open-sourcing-r1-1776 AI为什么不像人类一样进行多轮对话 新博客改造日记和功能测试 linuxqq只显示登陆背景图 数字设计和计算机体系结构(机械工业出版社)勘误(自制) Dynaseal:面向未来端侧llm agent的llm api key分发机制 A Definitive Guide to Markdown Style This post is using MDX, Where you can embed JSX and Astro components RT-Patch学习 pydantic实现的LLM ReAct fastapi 和 uvicorn 设置监听 ipv6
ViT在DDPM取代UNet(DiT)
About the Author StudyingLover · 2023-08-20 · via StudyingLover's Blog

ViT在DDPM取代UNet(DiT)

项目主页

这篇论文主要是尝试使用ViT取代DDPM中的UNet,叫做Diffusion Transformer-DiT,作者训练了DiT-S、DiT-B、DiT-L 和 DiT-XL四种模型,每种模型的patch取8,4,2, 一共训练了12个模型。

作者探索的完整 DiT 设计空间是补丁大小、变压器块架构和模型大小。

模型第一层是对 sequences of patches 进行操作(就是ViT把图片看成16∗1616*16的的单词之后单词构成的序列) 。 image.png
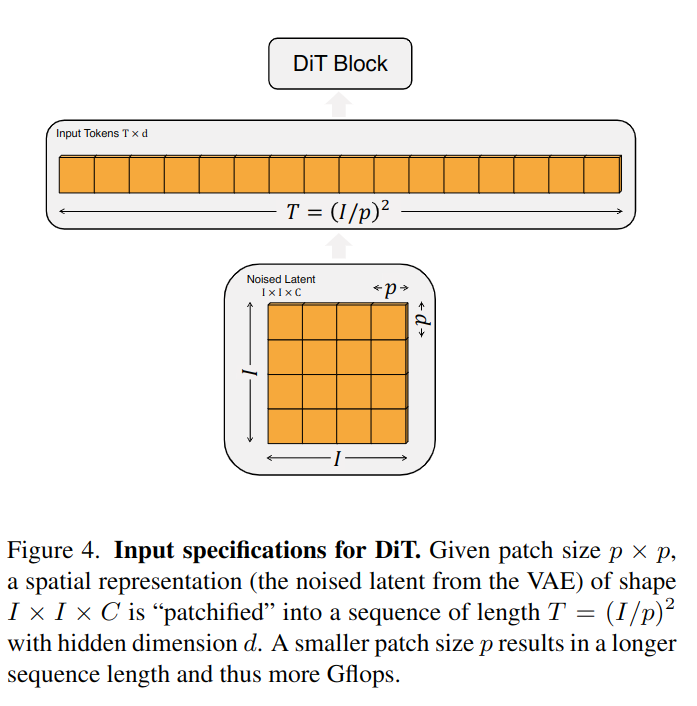
如图所示,给定的patch是p×pp\times p ,VAE采样出来的噪声大小是I×I×CI\times I\times C ,那么patches会变成长度为T=(I/p^)2T=(I/\hat{p})^{2} 的一个序列,每个patch维度是dd ,位置嵌入用的是sine-cosine。

接下来就是diffusion transformers的设计。 image.png
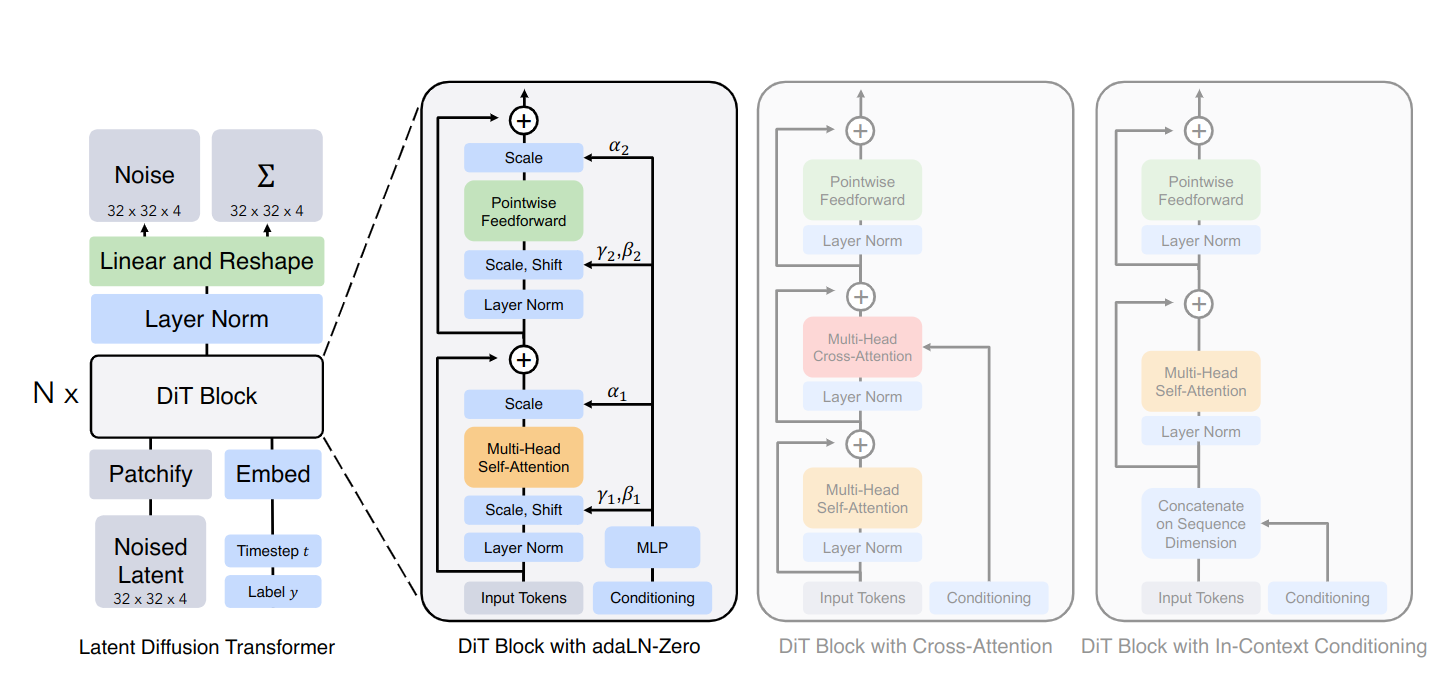
作者提到了一点,就是获取到path序列之后应该在后面加上去噪步数和类别标签,并在最后一个DiT块之后删掉。

在最终的 DiT 块之后,需要将输出解码为噪声预测和对角协方差预测。这两个输出的形状都等于整个模型的输入。作者使用标准线性解码器来做到这一点。如果使用 adaLN 自适应就应用最后一层范数,并将每个标记线性解码为 p×p×2Cp\times p\times2C 张量,其中 CC 是输入到DiT的空间大小。最后,将解码的token重新排列到其原始空间布局中,得到预测的噪声和协方差。