

惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

D
DataBreaches.Net
IT之家
IT之家
博客园_首页
博客园 - 【当耐特】
V
V2EX
Apple Machine Learning Research
G
Google Developers Blog
让小产品的独立变现更简单 - ezindie.com
Recent Announcements
F
Fortinet All Blogs
GbyAI
GbyAI
腾讯CDC
H
Hackread – Cybersecurity News, Data Breaches, AI and More
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
I
InfoQ
H
Help Net Security
T
Tailwind CSS Blog
B
Blog RSS Feed
Martin Fowler
Martin Fowler
人人都是产品经理
人人都是产品经理
The Cloudflare Blog
博客园 - 叶小钗
雷峰网
雷峰网
量子位

老董笔记

尚硅谷机构在哪?尚硅谷培训怎么样?靠谱吗-互联网IT百科 韩顺平介绍,传智讲师,开办泰牛,入尚硅谷等一系列-互联网IT百科 pandas多重索引标准样式(写入excel有空行)-互联网IT百科 cannot join with no overlapping index names-互联网IT百科 pandas多列变多行(即宽表变长表)melt和stack函数-互联网IT百科 pandas多行转多列(长表变宽表)pivot和unstack-互联网IT百科 Index contains duplicate entries, cannot reshape完美解决-互联网IT百科 single positional indexer is out-of-bounds-互联网IT百科 Can only compare identically-labeled Series objects-互联网IT百科 pandas transform用法详解(多个案例)-互联网IT百科 python四舍五入精确实现-互联网IT百科 pandas的groupby使用apply分组排序-互联网IT百科 index 0 is out of bounds for axis 0 with size 0-互联网IT百科 pandas分组过滤filter函数-互联网IT百科 联想Win10系统如何禁用触摸屏关闭触摸-互联网IT百科 groupby分组计算transform转换返回相同长度序列-互联网IT百科 brooks seo教程python教程,brooks seo教程网盘,布鲁seo资源-互联网IT百科 电脑右键文件夹一直转圈电卡死怎么回事-互联网IT百科 施琪嘉的心理成长课(荐)-互联网IT百科 百度SEO公司_SEO推广公司哪家好_SEO外包服务如何选-老董笔记 groupby后agg同1列用多个聚合函数、不同列用不同函数、自定义函数-互联网IT百科 pandas的groupby单列多列分组聚合运算-互联网IT百科 DataFrameGroupBy对象及分组个数、分组大小、组名索引、组数据详解-互联网IT百科 pandas中groupby之Grouper and axis must be same length-互联网IT百科 pandas中groupby的分组原理-互联网IT百科 pandas的groupby的使用详解大全-互联网IT百科 openpyxl单元格自动换行强制换行Alignment(wrapText=True)-互联网IT百科 python教程全套(可就业)-互联网IT百科 联想win10系统CPU显示100%,电脑呼呼响怎么回事-互联网IT百科 如何自制CPU,CPU原理是怎么样的?-互联网IT百科
requests二进制响应r.content下载图片视频及解码gzip和deflat...
2021-11-10 · via 老董笔记

  日常用爬虫采集数据除了采集文本,还会采集图片、视频等数据,requests能以字节的方式访问请求响应体获取二进制数据从而可以实现图片和视频的下载!所以对于非文本请求可以直接用r.content来获取。

  下载百度百科里面的1张图片代码如下:

# -*- coding: utf-8 -*-
headers = {
'user-agent':'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/95.0.4638.69 Safari/537.36 Edg/95.0.1020.44',
}

url = 'https://bkimg.cdn.bcebos.com/pic/b03533fa828ba61ea8d3c8f6227f800a304e241ff39d?x-bce-process=image/resize,m_lfit,w_536,limit_1/format,f_jpg'
r = requests.get(url,headers=headers)
with open('baike_py.jpg','wb') as f:
	f.write(r.content)

  对于文本内容用r.content获取后可以再手动decode()。

# -*- coding: utf-8 -*-
headers = {
'user-agent':'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/95.0.4638.69 Safari/537.36 Edg/95.0.1020.44',
}

url = 'https://www.baidu.com/'
r = requests.get(url,headers=headers)
print(r.content.decode('utf-8'))

  网页压缩算法

  有的网页体积很大,直接传输浪费资源和时间,因此网页可以先压缩一下再传输,到了客户端后再解压缩!压缩算法有很多常见的有gzip、deflate、br。

  在请求1个网页时客户端请求头增加1个字段Accept-Encoding:
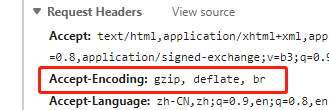
  Accept-Encoding:gzip, deflate, br。这代表客户端支持gzip、deflate、br的数据解码。

  在返回1个网页时,服务器端响应头里返回1个Content-Encoding字段:
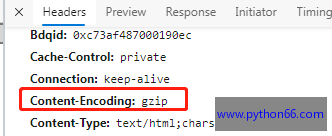
  Content-Encoding:gzip。这代服务端返回gzip数据格式。

  服务端也可以返回未压缩的正文,此时不允许返回Content-Encoding。

  对于gzip和deflate 压缩,使用r.content后requests 会自动解码gzip和deflate传输编码的响应数据。

很赞哦!

python编程网提示:转载请注明来源www.python66.com。
有宝贵意见可添加站长微信(底部),获取技术资料请到公众号(底部)。同行交流请加群 python学习会