LLM Token 消耗节省计划
How to Save Token for LLM
分类: AI, Tech101, 教程 / 字数: 2278 / 标签: 人工智能, AI, Token, 节省, 输入, 输出, 缓存命中, 预填充, 解码, 上下文
我在之前的文章「AI 时代的生产力和生产关系」中曾抛出过一个问题:如果由你自己承担龙虾的费用,你是否还会像当前这样使用龙虾?虽然之前的文章「本地部署大模型服务」介绍了如何通过本地部署实现 Token 自由,但想要你的智能体更聪明,往往还是需要一个参数规模远超你本地机器所能承受的模型才更靠谱些。当然也可以祭出你的多卡服务器,但无论以何种方式实现 Token 自由,终究都不免落入 ROI 计算的俗套,因为这背后的背后都是实打实的真金白银。统计了当前流行的部分国内外模型的价格,如下表所示:
| 模型 | 发布日期 | 参数 | 上下文长度 | 能力 | 输入价格 | 输出价格 | 缓存命中价格 |
|---|---|---|---|---|---|---|---|
| Claude Opus 4.6 | 2026-02 | 未知 | 1M | \$5 | \$25 | \$0.5 | |
| GPT-5.4 | 2026-03 | 未知 | 1.05M | ≤272K \$2.5 >272K \$5 |
≤272K \$15 >272K \$22.5 |
≤272K \$0.25 >272K \$0.5 |
|
| Grok 4.20 | 2026-03 | 未知 | 2M | ≤200K \$2 >200K \$4 |
≤200K \$6 >200K \$12 |
≤200K \$0.2 >200K \$0.4 |
|
| Gemma 4 31B | 2026-04 | 31B | 262.1K | \$0.14 | \$0.4 | \$0.07 | |
| Gemma 4 26B A4B | 2026-04 | 26B | 262.1K | \$0.13 | \$0.4 | \$0.05 | |
| Kimi K2.5 | 2026-02 | 1000B | 262.1K | \$0.6 | \$3 | \$0.1 | |
| MiniMax M2.7 | 2026-03 | 230B | 204.8K | \$0.3 | \$1.2 | \$0.06 | |
| GLM 5 Turbo | 2026-04 | 744B | 202.8K | \$1.2 | \$4 | \$0.24 | |
| Qwen 3.5 27B | 2026-02 | 27B | 262.1K | \$0.3 | \$2.4 | \$0.15 | |
| Qwen 3.5 35B A3B | 2026-02 | 35B | 262.1K | \$0.25 | \$2 | \$0.12 | |
| :图片,:视频,:音频,:工具调用,:思考,:代码优化 参考:https://openrouter.ai/,https://llm-stats.com/ |
|||||||
上述模型在 OpenClaw 上的成功率和输入价格对比图如下所示:
从上述图表中不难看出:模型越大、能力越丰富、支持的上下文越长价格也就越贵。同时部分模型针对超长的输入输出还会加价计费,这是因为随着输入输出的增加,模型的计算量并不是以线性的方式增长的,而是指数增长。
那么除了选择一个高性价比的模型之外,可还有其他的省钱之道?接下来我们来聊聊你的钱都花在了哪些地方,从定价表来看包括三个部分:输入、输出和缓存命中,为了更好的理解三者价格的差异,我们需要先回答如下两个问题。
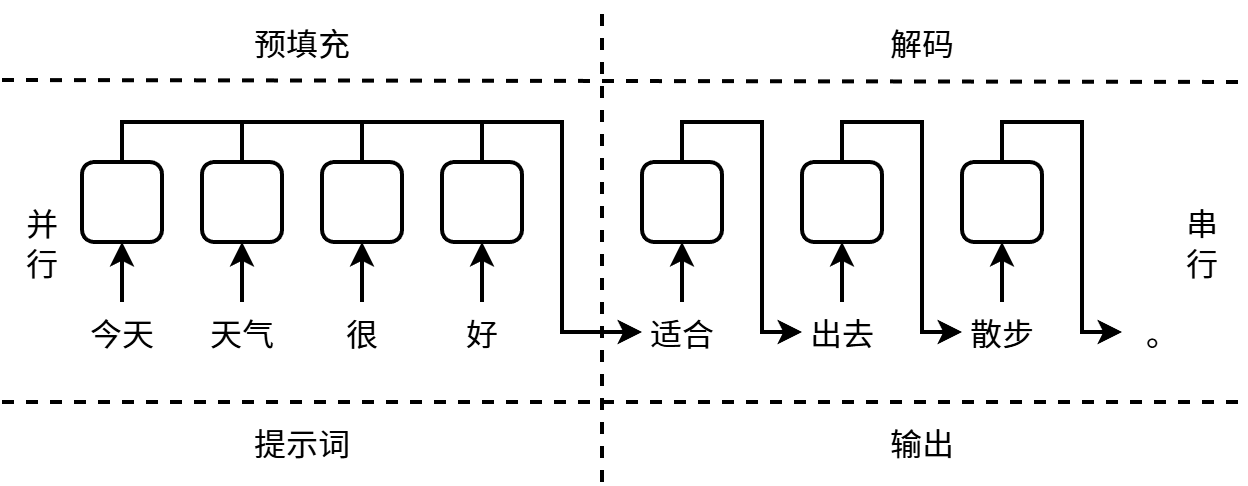
大模型的推理分为两个阶段:预填充(Prefill)和解码(Decode),过程如下图所示:
模型在获取到用户的提示词后,会将提示词中的所有 Token 一次性读入到模型中,这个阶段是高度并行的。例如当提示词中包含 100 个 Token 时,模型可以同时处理这 100 个 Token,GPU 最擅长的就是此类并行计算。此时 GPU 的利用率很高,因此分摊到每个 Token 上的成本就比较小。
预填充结束后模型开始输出,输出的 Token 只能一个一个的计算。这是因为每生成一个 Token,模型都需要将其拼接到之前的序列中,用作输入来生成下一个 Token。这是自回归解码模型的运行原理,无法并行,此时 GPU 的利用率较低,性能瓶颈在于显存中的数据传输而非计算。假设模型的参数量为 $P$,提示词的 Token 长度为 $M$,已经输出的 Token 长度为 $n$,那么在计算输出第 $n + 1$ 个 Token 时,模型的计算量为 $\left(M + n\right) \times P$。假设输出的 Token 总长度为 $N$,则总计算量为 $\sum_{i=1}^{N} \left(M + i\right) \times P$。可以看出,计算量和 Token 输出数量之间并非线性关系,这就是为什么有些模型针对超长的输出会加价计费。
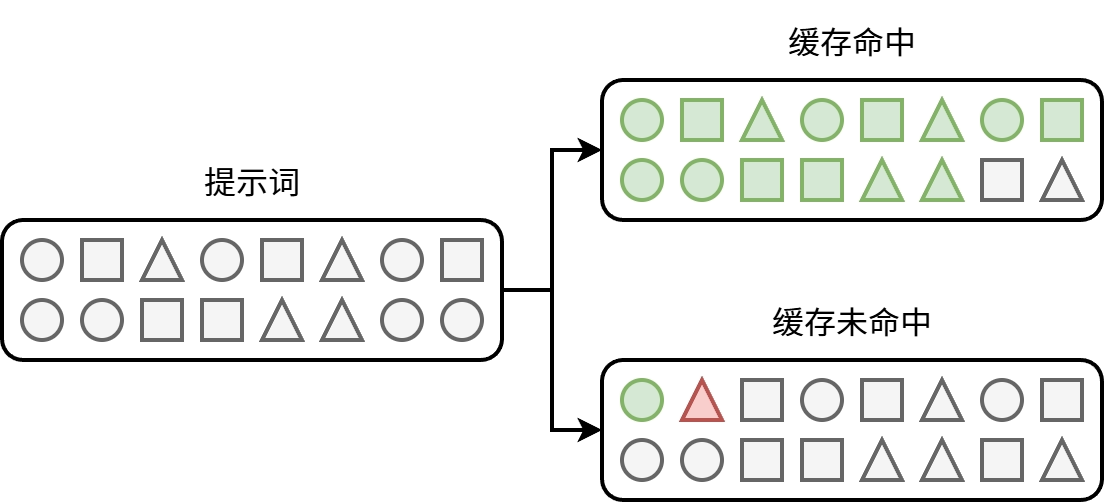
模型的输入除了用户的提示词以外,往往还会包含系统提示词等内容,这部分在每次模型运行的过程中都是相同的。通过提示词缓存技术可以将这段前缀提示词计算的结果保存在高速缓存中,在下次预填充的时候,如果前缀一样则直接可以把这部分结果从高速缓存中读取出来,而不需要重复计算。此时的成本仅包含缓存的存储和加载开销,对 GPU 算力几乎没有占用,因此这部分价格会很低。
需要注意的是,缓存是前缀匹配的,哪怕修改了一个字,后面的部分也都需要重新计算。缓存通常具有一定的有效期,一般几分钟到几小时就会失效。智能体往往会将系统提示词等不变的内容放在前面,将用户提示词等变化的内容放在后面,从而提升缓存命中率。
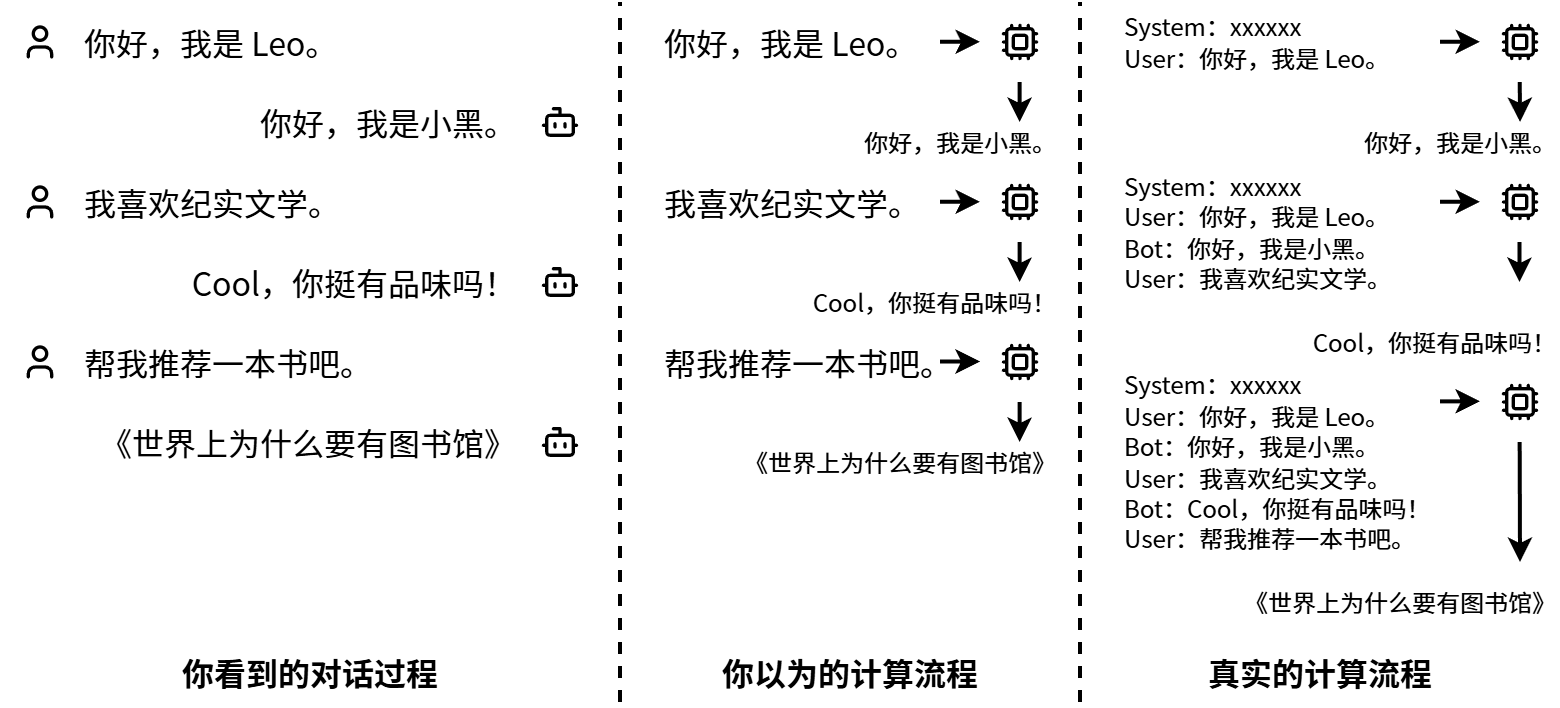
你需要知道 LLM 本身是一个无状态的服务,也就是说当模型确定后,你给它什么样的输入,它就针对性地给到你什么样的输出。当你在和智能体对话的时候,每一次智能体接收的输入并不仅仅是你这轮与其对话的内容,而是整个会话中的全部。
所以想要节省 Token,核心就是做好上下文管理,管得太紧(缺少必要的信息)效果就会大打折扣,管得太松(无用的信息太多)不单单是费钱效果也可能会受到影响。结合上下文管理,如下给到不同视角的一些节省 Token 的技巧和建议:
记忆管理
明确需求
写 Prompt 和沟通一样,是一门艺术。有些场景需要模糊些,例如探索性分析,模型可能会给到你意想不到的结果。但当需求明确的时候,准确的需求描述可以让智能体少很多弯路。需求一次性说完整,比一轮一轮的挤牙膏式会少消耗不少 Token。
别学某些芯片厂,总是挤牙膏 😂
控制输出
输出比输入贵上个 5-10 倍,告诉 AI 你要什么,不要让它自由发挥。以及最后那一句“我真的太棒了!”的情绪价值属实大可不必。❌:帮我分析一下这篇文章。✅:分析一下这篇文章,用一百个字总结核心内容。
严重怀疑服务商在 LLM 里写死了一条指令:多说些,我好多赚点儿 🤑
以上是几点通用的技巧和建议。在更多细分的场景(例如:编码)会有更多的实用技巧,在此不再一一展开,可以参考如下文章:
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。