大语言模型微调
Fine-tuning Large Language Models
分类: AI / 字数: 4368 / 标签: 微调, Fine-tuning, 大语言模型, LLMs, Large Language Models, 预训练, Pre-training, 后训练, Post-training, 全参数微调, Full Fine-tuning, 部分参数微调, Repurposing, 监督微调, Supervised Fine-tuning, 无监督微调, Unsupervised Fine-tuning, 指令微调, Instruction Fine-tuning, 对齐微调, Alignment Fine-tuning, 参数高效微调, Parameter-efficient Fine-tuning, Prefix Tuning, Prompt Tuning, P-Tuning, P-Tuning v2, LoRA, IA3
微调(Fine-tuning)是深度学习中迁移学习的一种方法,其将现有模型已经学到的知识作为学习新任务的起点。虽然微调表面上是模型训练中使用的一种技术,但它与传统意义上的“训练”截然不同。为了消除歧义,在这种情况下通常将传统意义上的“训练”称为预训练(Pre-training)。1
与微调类似的另一个概念称之为后训练(Post-training),两者均发生在预训练之后,其目的也都是为了进一步提升模型的效果,通常两者可以理解为相同的概念。从优化的发起人角度出发:当终端用户希望模型可以更好的适配自己的领域知识,则需要进行的操作称之为微调;当模型开发者希望可以更好的将模型与人类的价值、道德和预期保持一致,则需要进行的操作称之为后训练。2
从本质上讲,磨练一个预训练基础模型的能力要比从头开始训练一个新模型更容易,也更省钱,因为预训练已经获得了与当前任务相关的广泛知识。对于具有数百万甚至数十亿个参数的深度学习模型尤其如此,例如在自然语言处理(NLP)领域的大语言模型(LLM)或卷积神经网络(CNN)和视觉转换器(ViT)(用于计算机视觉任务,例如图像分类、对象检测或图像分割等)。
通过迁移学习利用先前的模型训练,微调可以减少获得适合特定用例和业务需求的大模型所需的昂贵算力和标记数据量。例如,微调可用于调整预训练大语言模型的对话语气或预训练图像生成模型的图片样式,还可用于使用专有数据或领域特定的专业知识来补充模型的原始训练数据集。
微调是需要进一步训练模型的技术,模型的权重已经通过先前的预训练得到了更新。使用基础模型的先前知识作为起点,通过在任务特定的较小数据集上进行训练来对模型进行微调。
虽然从理论上讲,任务特定的数据集都可以用于初始训练,但在小数据集上从头开始训练一个大模型可能会存在过拟合的风险:模型可能会在训练示例中学习得到良好的表现,但对新数据的泛化能力却很差。这会导致模型不适合给定的任务,也违背了模型训练的初衷。 因此,微调可以兼具两者的优势:利用对大量数据进行预训练所获得的广泛知识和稳定性,并训练模型对更详细、更具体概念的理解。
从参数角度,我们可以将微调分为全参数微调(Full Fine-tuning)和部分参数微调(Repurposing):
从数据角度,我们可以将微调分为监督微调(Supervised Fine-tuning)和无监督微调(Unsupervised Fine-tuning):
从方式角度,我们可以将微调划分为指令微调(Instruction Fine-tuning)和对齐微调(Alignment Fine-tuning):
在进行模型微调时我们需要关注显存的消耗,以确保在当前的硬件环境中可以正常进行微调。在进行模型微调时,显存消耗主要同如下因素有关:
以全参数微调一个 1B 模型为例,所需的显存大致为 12GB(模型参数:2GB,梯度:2GB,优化器状态:8GB)。在使用部分参数微调时,模型参数本身不变,需要微调的参数会大幅度减少,因此梯度和优化器状态所需的显存也会大幅度减少。在应用一些量化技术后,例如使用 INT8 精度进行微调,则所有部分的显存占用均会相应的减少。
参数高效微调部分主要参考了 llm-action 项目。
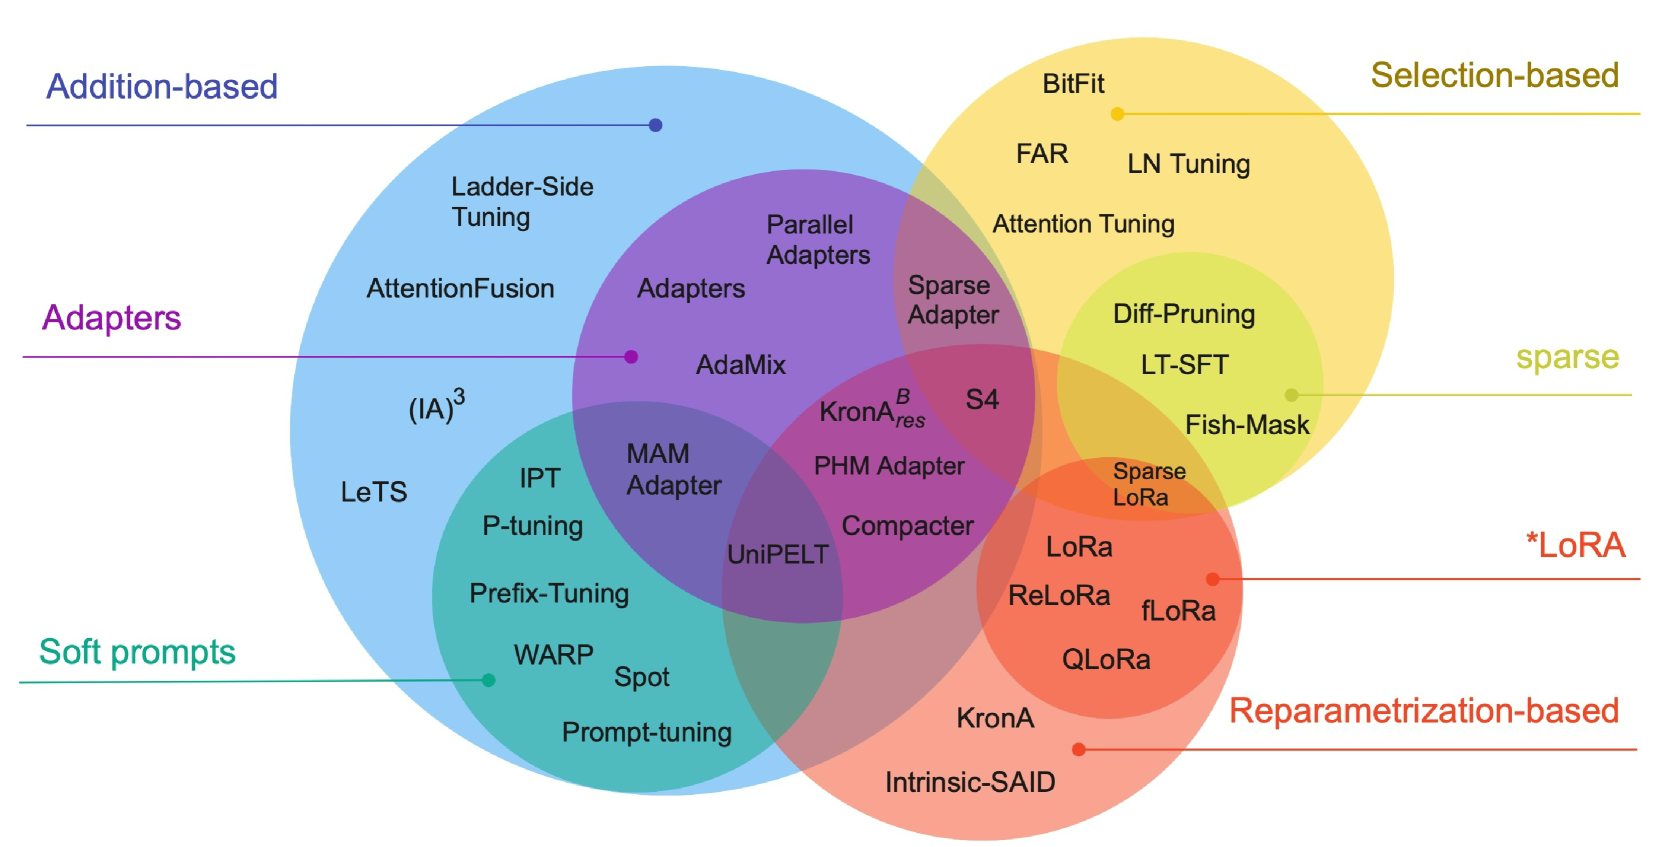
参数高效微调(Parameter-Efficient Fine-Tuning)是指固定大部分预训练模型的参数,仅微调少量或额外的模型参数的微调方法,从而可以极大的降低计算成本。参数高效微调可以从方法的角度可以分为三类 3:引入新参数(Addition-based),微调部分参数(Selection-based)和重参数化(Reparametrization-based),其中引入新参数又可以划分为适配器方法和软提示方法两种。
在实战过程中我们可以使用 Huggingface 开源的 PEFT 扩展库进行参数高效微调,作为 Huggingface 开源项目其可以与 Transformers,Accelerate 和 Diffusers 等多个开源库无缝衔接使用。在官方文档中我们可以查看支持的微调类型和任务类型。
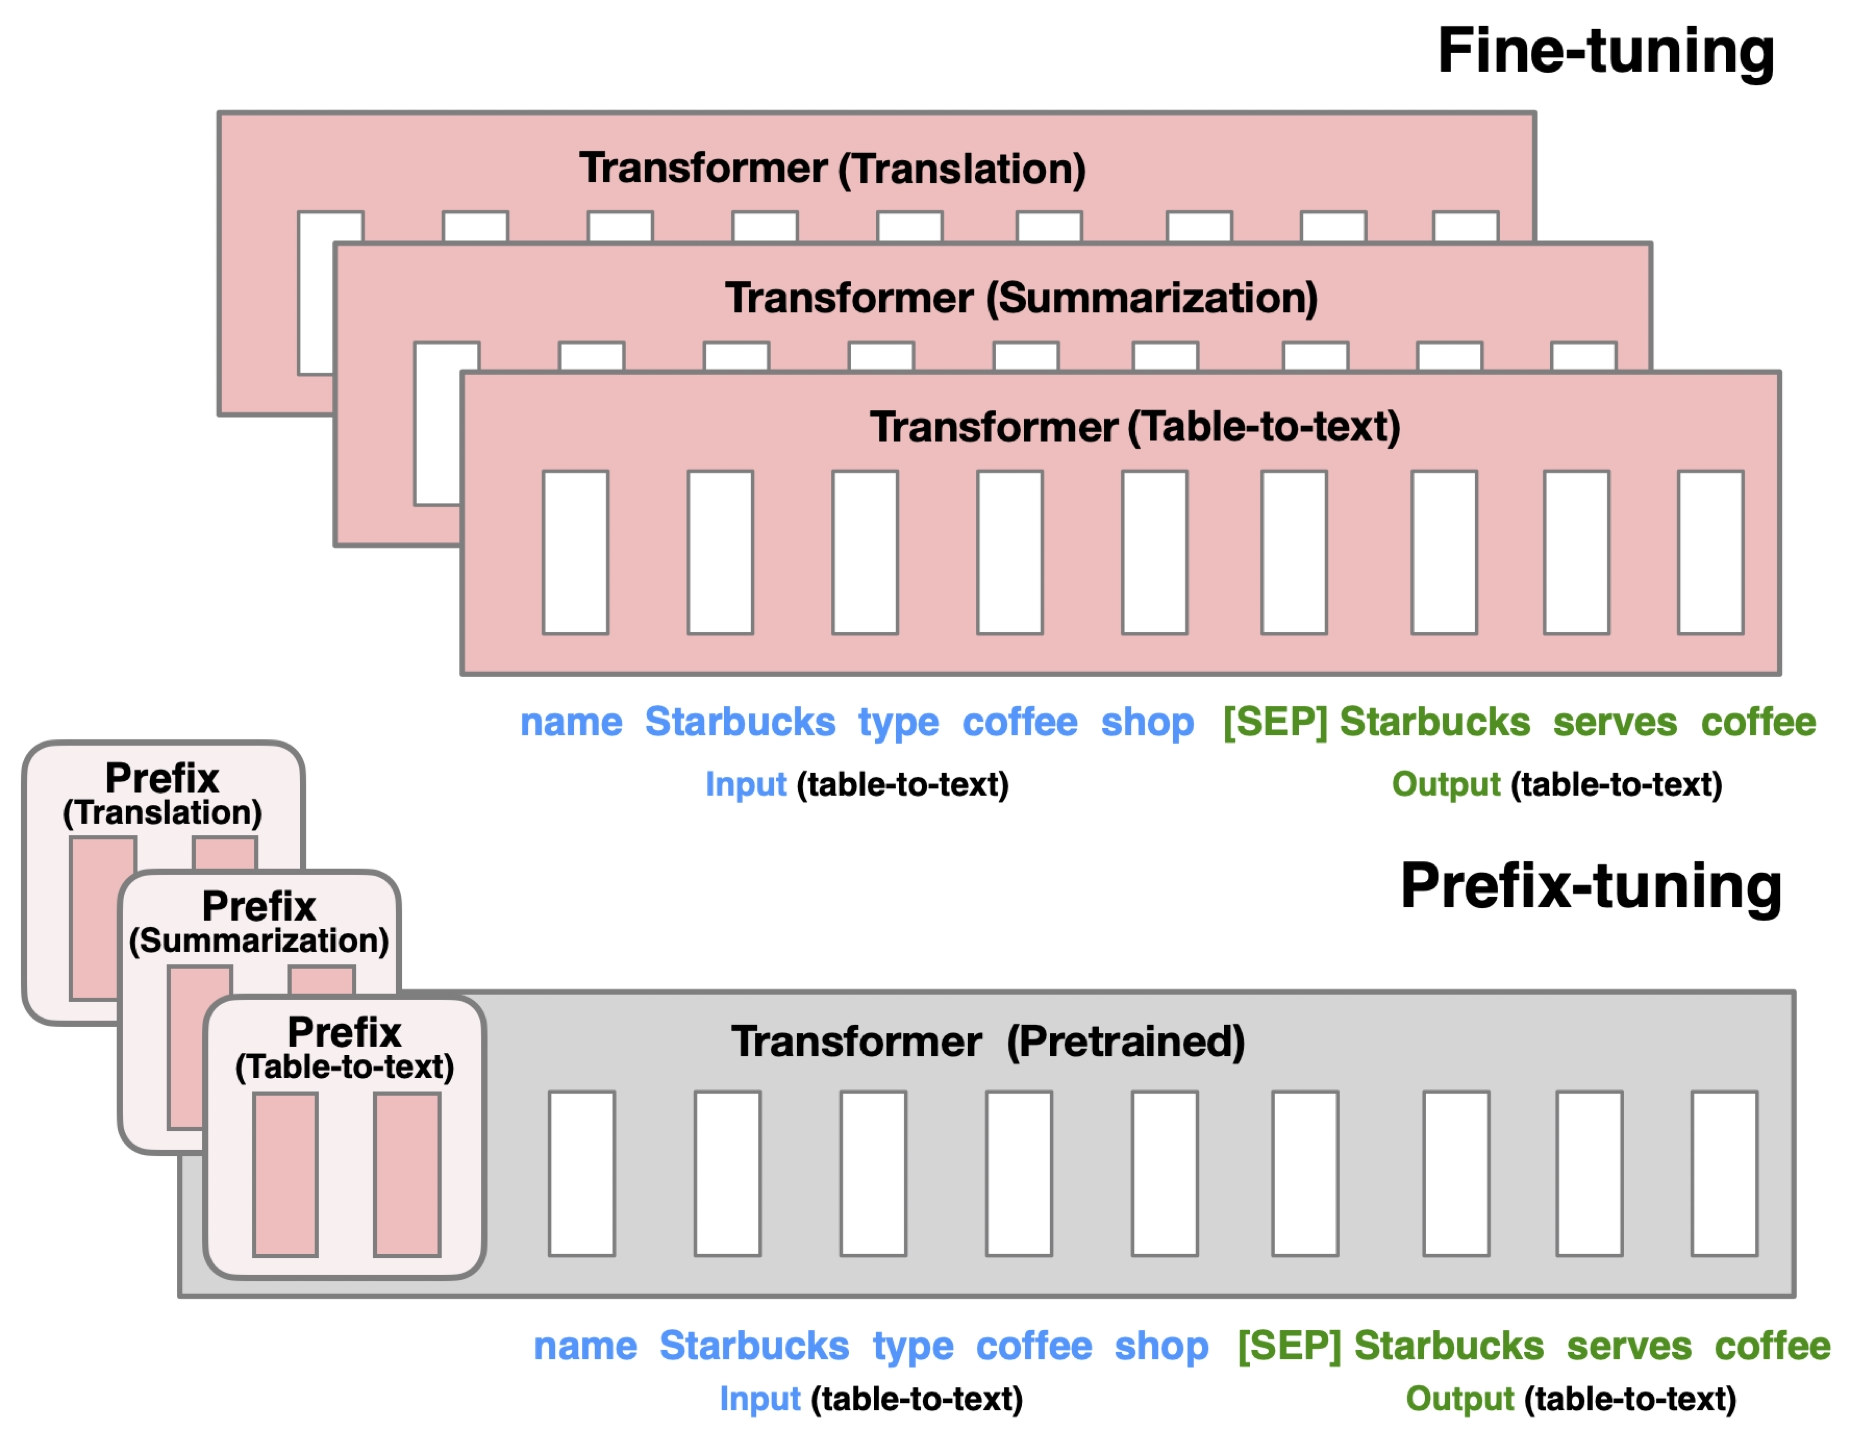
Prefix Tuning 4 是在输入的 token 前构造与任务相关的 virtual token 作为前缀,在微调的时候仅更新前缀部分的参数。
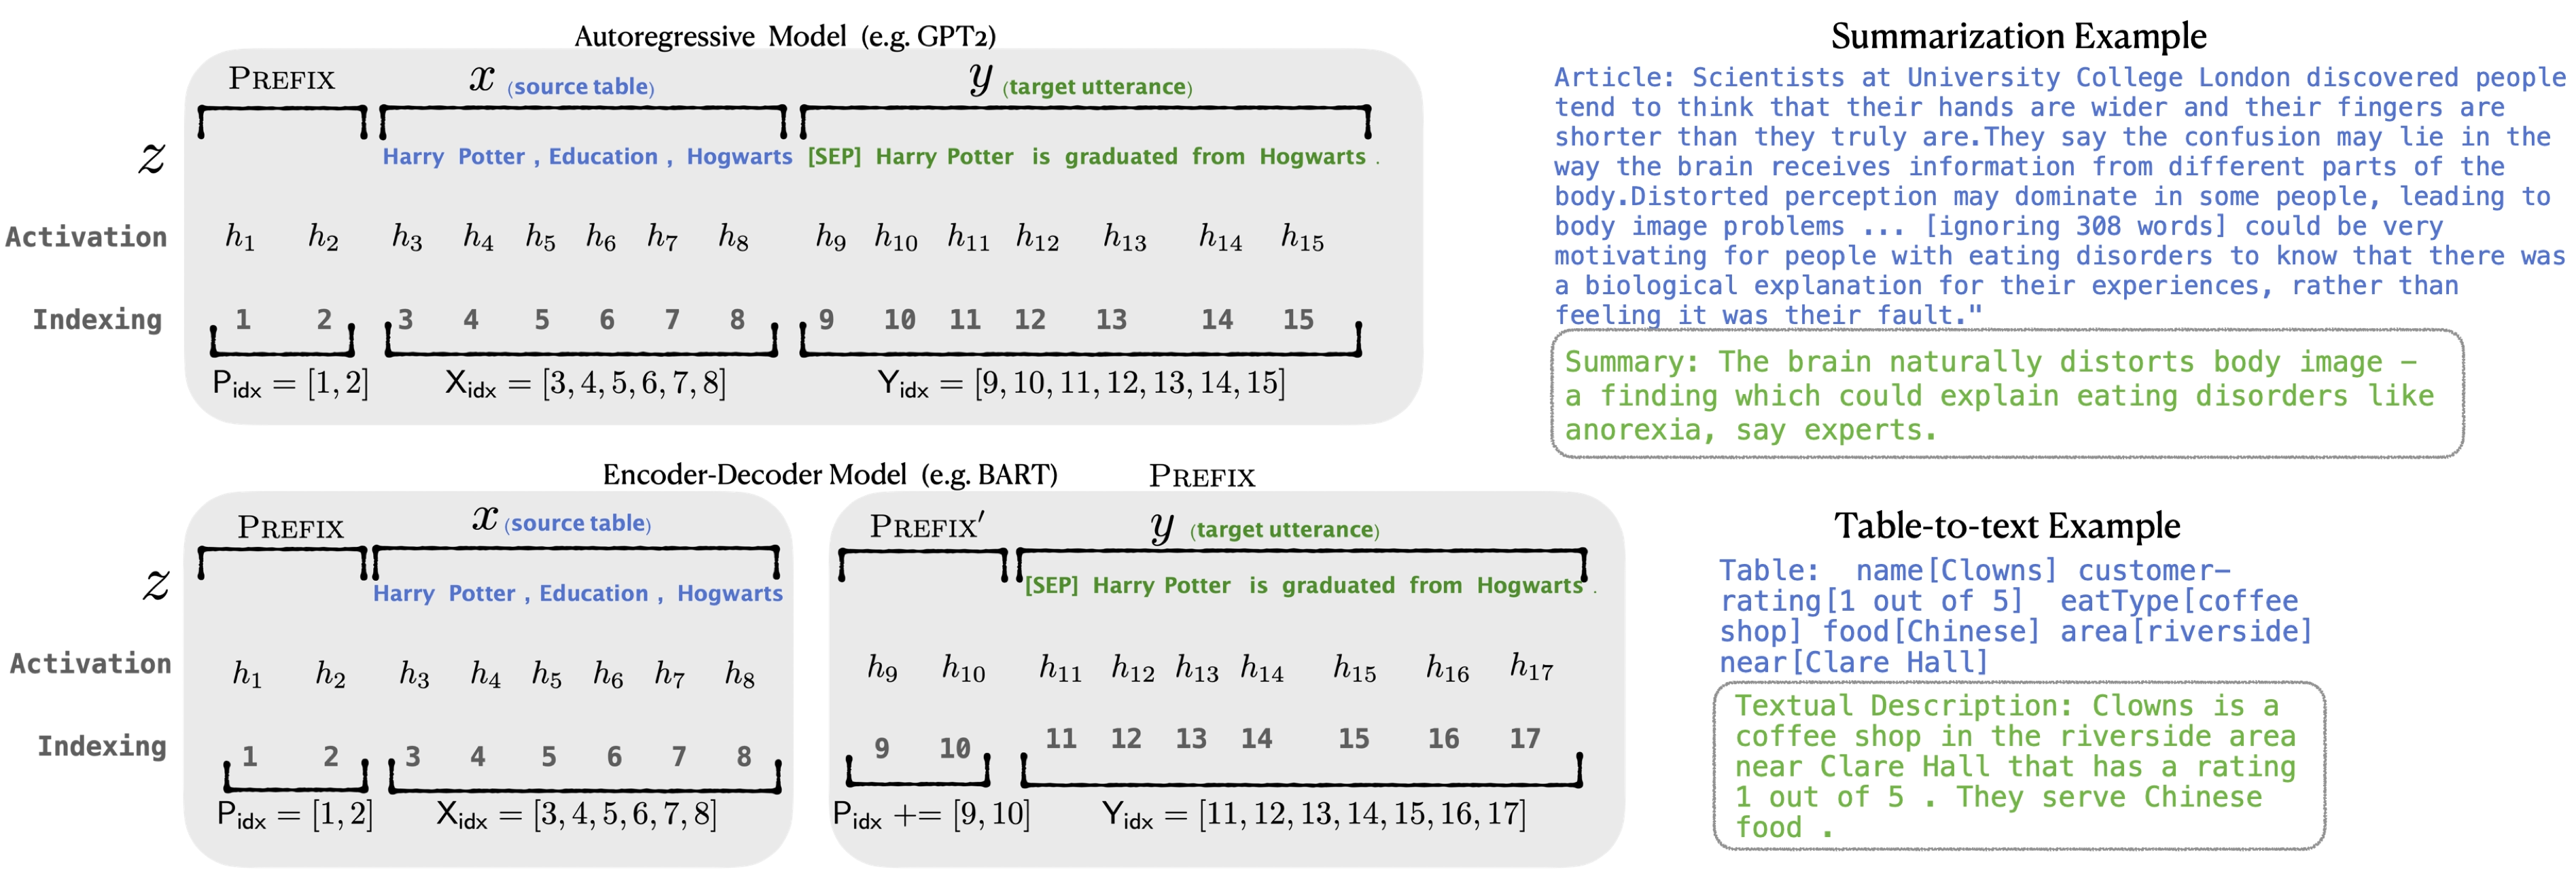
针对不同的模型结构,构造的前缀也有所不同:
作者发现直接更新前缀的参数会导致训练不稳定,因此在前缀之前添加了 MLP 结构,在训练完成后 MLP 部分的参数无需保留,仅保留前缀的参数即可。同时作者也针对前缀使用多少个 virtual token 以及前缀放置的位置对于微调的性能影响进行了相关实验,细节请参考论文原文。
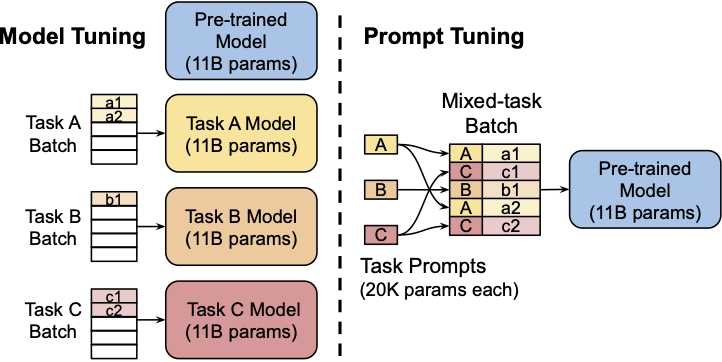
Prompt Tuning 5 可以看作是 Prefix Tuning 的简化版本,其为每个任务定义不同的 Prompt,然后拼接到数据上作为输入。
Prompt Tuning 仅在输入层添加 token,不需要像 Prefix Tuning 那样添加 MLP 结构解决训练问题。通过实验发现,随着模型参数的增加,Prompt Tuning 的效果会逼近全参数微调的效果。
实验还发现,与随机和使用样本词汇表的初始化相比,采用类标签初始化的微调效果更好,但随着模型参数的增加,效果差异会消失。同时 Prompt 的 token 长度在 20 左右可以获得不错的效果,同样随着模型参数的增加,token 长度带来的增益会消失。
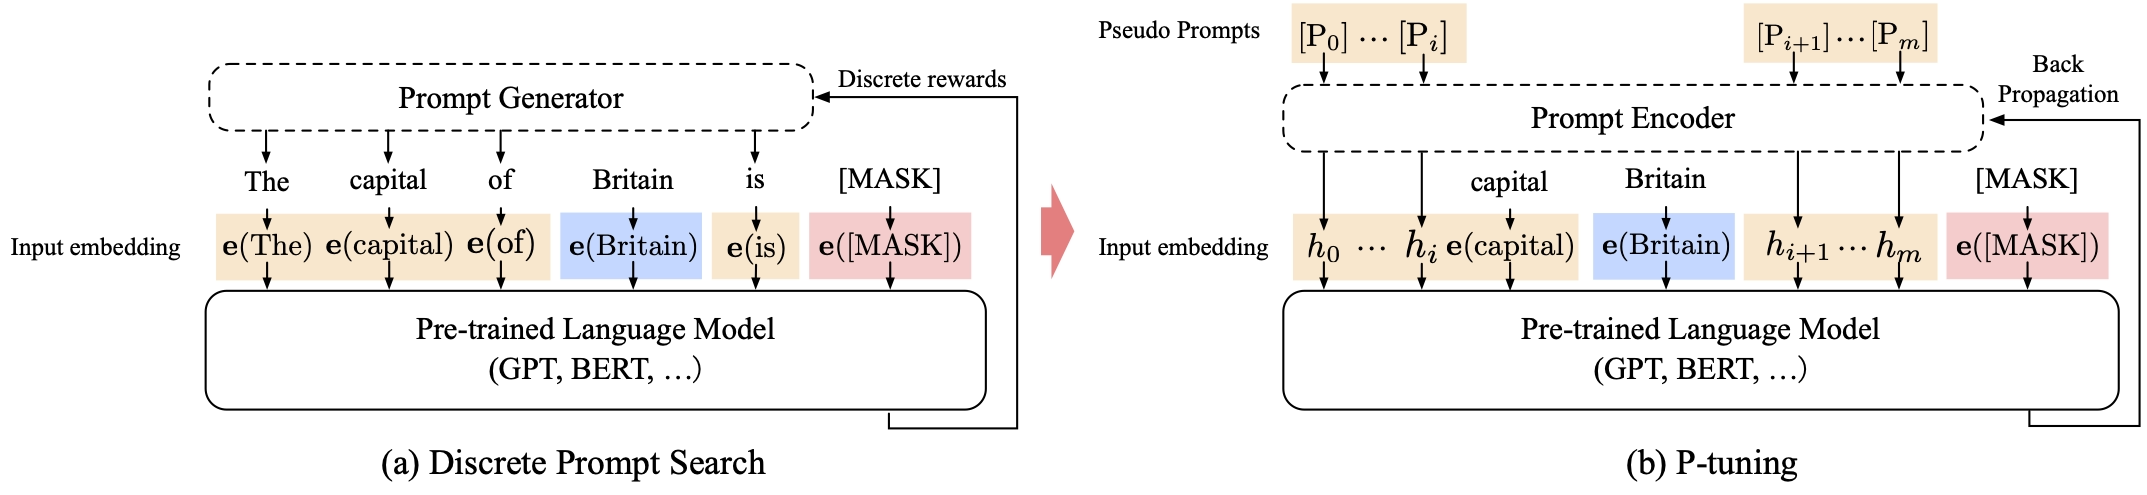
P-Tuning 6 将 Prompt 转换为可学习的 Embedding 层,再通过 MLP+LSTM 结构对 Prompt Embedding 进行处理。
对比 Prefix Tuning,P-Tuning 增加了可微的 virtual token,但仅作用于输入层,没有在每一层都添加。同时,virtual token 的位置也不一定是前缀,其插入的位置是可选的,目的是将传统人工设计的 Prompt 模板中的真实 token 替换为可微的 virtual token。
实验发现随机初始化 virtual token 容易陷入局部最优,因此通过一个 Prompt Encoder(即 MLP+LSTM 结构)对其进行编码可以获得更好的效果。
Prompt Tuning 和 P-Tuning 存在如下问题:
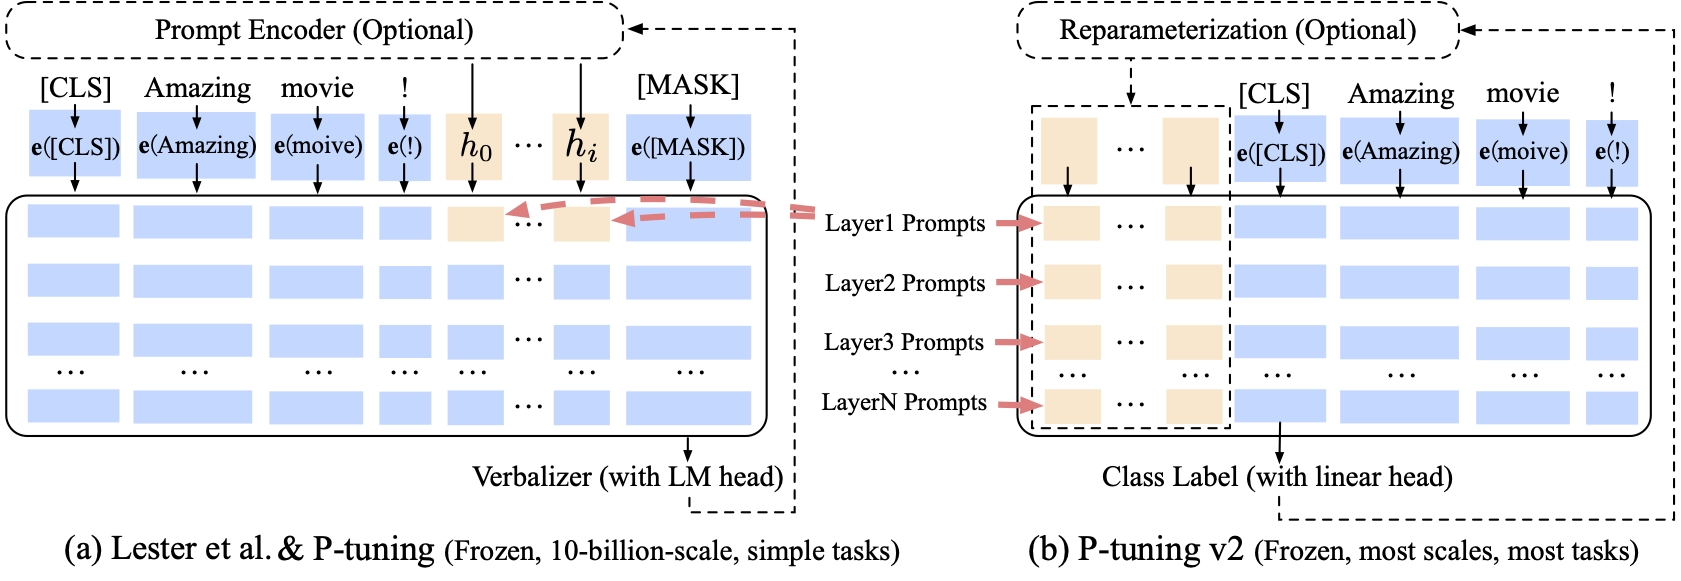
考虑到上述问题,P-Tuning v2 7 利用深度提示优化(例如:Prefix Tuning)对 Prompt Tuning 和 P-Tuning 进行改进,类似 Prefix Tuning,其在每一层都加入了 Prompt token 作为输入。
P-Tuning v2 还通过移除重参数化编码器、针对不同任务采用不同提示词长度、引入多任务学习、使用传统分类标签范式等方法进行模型改进。实验表明 P-Tuning v2 可以在不同规模和不同任务中实现与全量微调相媲美的效果。
Adapter Tuning 8 设计了一个 Adapter 模块,并在每个 Transformer 层中插入两个 Adapter 模块,在微调时仅更新增加的 Adapter 模块和 Layer Norm 层中的参数。
Adapter 模块由两个前馈层和一个非线性层组成。第一个前馈层将 Transformer 的输入从 $d$ 维(高维)映射到 $m$ 维(低维),其中 $m \ll d$。通过控制 $m$ 的大小可以限制 Adapter 模块的参数量。中间通过非线性层后,第二个前馈层再将 $m$ 维映射回 $d$ 维作为 Adapter 模块的输出。同时通过 Skip Connection 将 Adapter 的输入也添加到 Adapter 的输出中,这样可以保证即便 Adapter 最开始的参数值接近 0,通过 Skip Connection 的设置也可以保证训练的有效性。
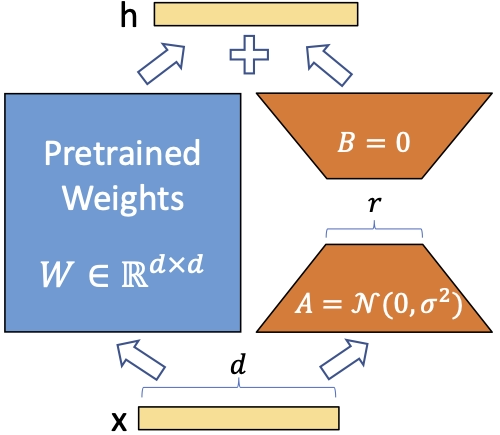
神经网络包含很多全连接层,其通过矩阵乘法实现。很多全连接层的权重矩阵是满秩的,针对特定任务微调后,模型的权重矩阵其实具有很低的本征秩(intrinsic rank),因此将参数矩阵投影到更小的空间仍可以得到有效的学习。LoRA 9 的核心思想就是通过低秩分解降低特征矩阵的参数量,从而以较小的参数量来实现大模型的间接训练。
在涉及到矩阵相乘的模块中,在其旁边增加一个新的通路,通过第一个矩阵 $A$ 将维度从 $d$ 降至 $r$,在通过一个矩阵 $B$ 将维度从 $r$ 升回 $d$,其中 $r \ll d$。
在微调时,仅更新上述两个矩阵的参数,再将两条通路的结果相加作为最终的结果,即 $h = W_0 x + B A x$。训练时矩阵 $A$ 通过高斯函数初始化,矩阵 $B$ 初始化为零矩阵,这样训练开始时 $B A = 0$,从而可以确保新的通路对模型的结果没有影响。
在 Attention 模块中,权重矩阵包括用于计算 Q,K,V 的 $W_q$,$W_k$,$W_v$ 以及多头注意力的 $W_o$,实验表明保证权重矩阵的种类数量比增加秩 $r$ 的大小更为重要,通常情况下 $r$ 选择 4,8,16 即可。
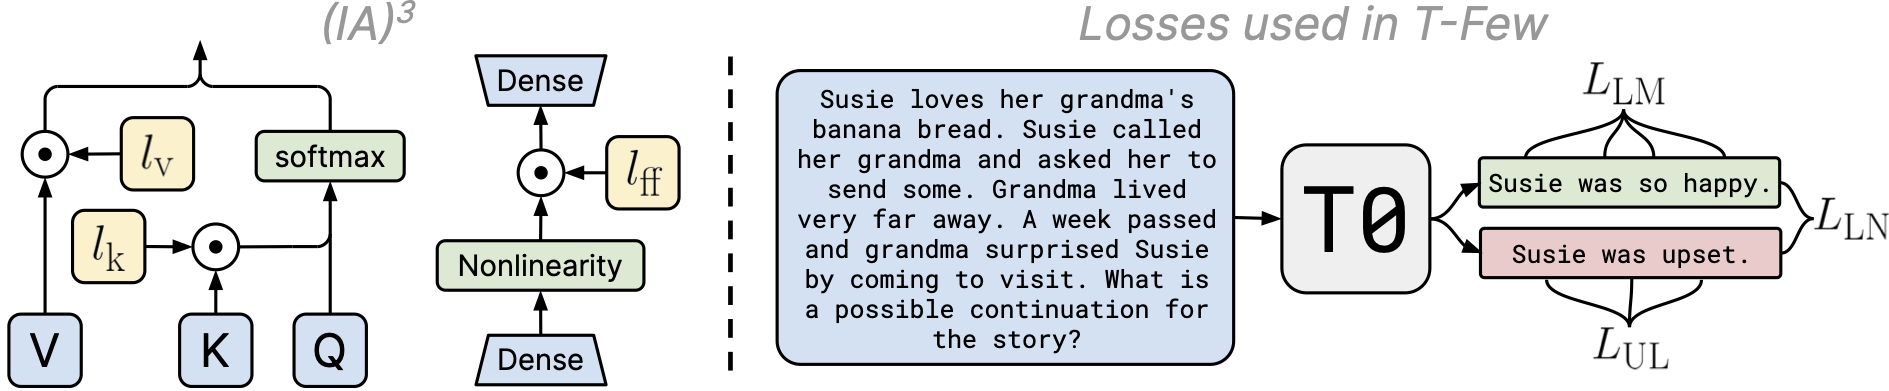
IA3 10 不同于 LoRA 学习低秩权重,而是通过学习向量($l_k$,$l_v$,$l_{ff}$)对模型的部分参数进行加权实现对一些激活层的抑制或放大,同时优化损失函数以适应少样本学习。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。