



Hadoop 集群搭建
Hadoop Cluster Setup
分类: Tech101, 教程 / 字数: 1499 / 标签: Hadoop, Hadoop 集群, Hadoop Cluster, Zookeeper, Namenode, Datanode, YARN, Resource Manager, Node Manager, Journal Node
文本使用的软件版本分别为:
按照虚拟环境准备 (Virtual Environment Preparation) 准备虚拟机列表如下:
| 主机名 | IP | 角色 |
|---|---|---|
| vm-01 | 192.168.56.101 | HDFS Namenode HDFS Datanode YARN Resource Manager YARN Node Manager Journal Node Zookeeper |
| vm-02 | 192.168.56.102 | HDFS Namenode HDFS Datanode YARN Resource Manager YARN Node Manager Journal Node Zookeeper |
| vm-03 | 192.168.56.103 | HDFS Namenode HDFS Datanode YARN Node Manager Journal Node Zookeeper |
将 /opt 目录所有者赋予当前用户:
sudo chown -R leo:leo /opt
在根目录建立 data 目录,并将其所有者赋予当前用户:
sudo mkdir /data
sudo chown -R leo:leo /data
将 JDK 安装包解压缩到 /opt 目录并创建软链接:
cd /opt
tar -zxvf jdk-8u291-linux-x64.tar.gz
ln -s /opt/jdk1.8.0_291 /opt/jdk
将如下信息添加到 /etc/profile 中:
# JDK
export JAVA_HOME=/opt/jdk
export PATH=$PATH:$JAVA_HOME/bin
方便起见可以使用 rsync 命令同步 JDK:
rsync -auvp /opt/jdk1.8.0_291 leo@vm-02:/opt
rsync -auvp /opt/jdk1.8.0_291 leo@vm-03:/opt
将 Zookeeper 安装包解压到 /opt 目录并创建软链接:
cd /opt
tar -zxvf apache-zookeeper-3.7.0-bin.tar.gz
ln -s /opt/apache-zookeeper-3.7.0-bin /opt/zookeeper
将如下信息添加到 /etc/profile 中:
# Zookeeper
export ZOOKEEPER_HOME=/opt/zookeeper
export PATH=$PATH:$ZOOKEEPER_HOME/bin
在 /data 目录下创建 zookeeper 文件夹:
在 /data/zookeeper 目录中创建 myid 文件:
echo 1 > /data/zookeeper/myid    # 仅在 vm-01 上执行
echo 2 > /data/zookeeper/myid    # 仅在 vm-02 上执行
echo 3 > /data/zookeeper/myid    # 仅在 vm-03 上执行
复制 Zookeeper 配置文件:
cd /opt/zookeeper/conf
mv zoo_sample.cfg zoo.cfg
修改 zoo.cfg 文件内容如下:
# the directory where the snapshot is stored.
# do not use /tmp for storage, /tmp here is just
# example sakes.
dataDir=/data/zookeeper

# servers
server.1=vm-01:2888:3888
server.2=vm-02:2888:3888
server.3=vm-03:2888:3888
方便起见可以使用 rsync 命令同步 Zookeeper:
rsync -auvp /opt/apache-zookeeper-3.7.0-bin leo@vm-02:/opt
rsync -auvp /opt/apache-zookeeper-3.7.0-bin leo@vm-03:/opt
将 Hadoop 安装包解压到 /opt 目录并创建软链接:
cd /opt
tar -zxvf /hadoop-3.2.2.tar.gz
ln -s /opt/hadoop-3.2.2 /opt/hadoop
将如下信息添加到 /etc/profile 中:
# Hadoop
export HADOOP_HOME=/opt/hadoop
export PATH=$PATH:$HADOOP_HOME/bin
在 /data 目录下创建如下文件夹:
mkdir /data/hadoop
mkdir /data/hadoop/tmp
mkdir /data/hadoop/pid
mkdir /data/hadoop/logs
mkdir /data/hadoop/hdfs
mkdir /data/hadoop/hdfs/journalnode
mkdir /data/hadoop/hdfs/namenode
mkdir /data/hadoop/hdfs/datanode
编辑 /opt/hadoop/etc/hadoop/core-site.xml 内容如下:
<?xml version="1.0" encoding="UTF-8"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<configuration>
  <property>
    <!-- HDFS 的 nameservice -->
    <name>fs.defaultFS</name>
    <value>hdfs://ns1/</value>
  </property>
  <property>
    <!-- Hadoop 临时目录 -->
    <name>hadoop.tmp.dir</name>
    <value>/data/hadoop/tmp</value>
  </property>
  <property>
    <!-- Zookeeper 地址 -->
    <name>ha.zookeeper.quorum</name>
    <value>vm-01:2181,vm-02:2181,vm-03:2181</value>
  </property>
</configuration>
编辑 /opt/hadoop/etc/hadoop/hdfs-site.xml 内容如下:
<?xml version="1.0" encoding="UTF-8"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<configuration>
  <property>
    <!-- HDFS 的 nameservice -->
    <name>dfs.nameservices</name>
    <value>ns1</value>
  </property>
  <property>
    <!-- namenode 列表 -->
    <name>dfs.ha.namenodes.ns1</name>
    <value>nn1,nn2,nn3</value>
  </property>
  <property>
    <!-- nn1 的 RPC 通信地址 -->
    <name>dfs.namenode.rpc-address.ns1.nn1</name>
    <value>vm-01:9000</value>
  </property>
  <property>
    <!-- nn2 的 RPC 通信地址 -->
    <name>dfs.namenode.rpc-address.ns1.nn2</name>
    <value>vm-02:9000</value>
  </property>
  <property>
    <!-- nn3 的 RPC 通信地址 -->
    <name>dfs.namenode.rpc-address.ns1.nn3</name>
    <value>vm-03:9000</value>
  </property>
  <property>
    <!-- nn1 的 HTTP 通信地址 -->
    <name>dfs.namenode.http-address.ns1.nn1</name>
    <value>vm-01:50070</value>
  </property>
  <property>
    <!-- nn2 的 HTTP 通信地址 -->
    <name>dfs.namenode.http-address.ns1.nn2</name>
    <value>vm-02:50070</value>
  </property>
  <property>
    <!-- nn3 的 HTTP 通信地址 -->
    <name>dfs.namenode.http-address.ns1.nn3</name>
    <value>vm-03:50070</value>
  </property>
  <property>
    <!-- namenode 在 journalnode 上的存放位置 -->
    <name>dfs.namenode.shared.edits.dir</name>
    <value>qjournal://vm-01:8485;vm-02:8485;vm-03:8485/ns1</value>
  </property>
  <property>
    <!-- journalnode 在磁盘上的存放位置 -->
    <name>dfs.journalnode.edits.dir</name>
    <value>/data/hadoop/hdfs/journalnode</value>
  </property>
  <property>
    <!-- 开启 namenode 失败自动切换 -->
    <name>dfs.ha.automatic-failover.enabled</name>
    <value>true</value>
  </property>
  <property>
    <!-- 配置失败自动切换实现方式 -->
    <name>dfs.client.failover.proxy.provider.ns1</name>
    <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value>
  </property>
  <property>
    <!-- 配置隔离机制方法,多个机制用换行分割,即每个机制暂用一行 -->
    <name>dfs.ha.fencing.methods</name>
    <value>sshfence</value>
  </property>
  <property>
    <!-- 使用 sshfence 隔离机制时需要 ssh 免密登陆 -->
    <name>dfs.ha.fencing.ssh.private-key-files</name>
    <value>/homt/leo/.ssh/id_rsa</value>
  </property>
  <property>
    <!-- 配置 sshfence 隔离机制超时时间 -->
    <name>dfs.ha.fencing.ssh.connect-timeout</name>
    <value>30000</value>
  </property>
  <property>
    <!-- journalnode HTTP 通信地址 -->
    <name>dfs.journalnode.http-address</name>
    <value>0.0.0.0:8480</value>
  </property>
  <property>
    <!-- journalnode RPC 通信地址 -->
    <name>dfs.journalnode.rpc-address</name>
    <value>0.0.0.0:8485</value>
  </property>
  <property>
    <!-- HDFS 副本数量 -->
    <name>dfs.replication</name>
    <value>1</value>
  </property>
  <property>
    <!-- namenode 在磁盘上的存放位置 -->
    <name>dfs.namenode.name.dir</name>
    <value>/data/hadoop/hdfs/namenode</value>
  </property>
  <property>
    <!-- datanode 在磁盘上的存放位置 -->
    <name>dfs.datanode.data.dir</name>
    <value>/data/hadoop/hdfs/datanode</value>
  </property>
  <property>
    <!--开启 webhdfs 接口访问 -->
    <name>dfs.webhdfs.enabled</name>
    <value>true</value>
  </property>
  <property>
    <!-- 关闭权限验证,hive 可以直连 -->
    <name>dfs.permissions.enabled</name>
    <value>false</value>
  </property>
</configuration>
编辑 /opt/hadoop/etc/hadoop/yarn-site.xml 内容如下:
<?xml version="1.0"?>
<configuration>
  <property>
    <!-- 开启 resourc emanager 高可用 -->
    <name>yarn.resourcemanager.ha.enabled</name>
    <value>true</value>
  </property>
  <property>
    <!-- 指定 resourc emanager 的 cluster id -->
    <name>yarn.resourcemanager.cluster-id</name>
    <value>leo</value>
  </property>
  <property>
    <!-- 指定 resourc emanager 的名字 -->
    <name>yarn.resourcemanager.ha.id</name>
    <value>rm1</value>
  </property>
  <property>
    <!-- 指定 resourc emanager 的名字 -->
    <name>yarn.resourcemanager.ha.rm-ids</name>
    <value>rm1,rm2</value>
  </property>
  <property>
    <!-- 指定 resourc emanager 1 的地址 -->
    <name>yarn.resourcemanager.hostname.rm1</name>
    <value>vm-01</value>
  </property>
  <property>
    <!-- 指定 resourc emanager 2 的地址 -->
    <name>yarn.resourcemanager.hostname.rm2</name>
    <value>vm-02</value>
  </property>
  <property>
    <!-- 指定 zookeeper 集群地址 -->
    <name>yarn.resourcemanager.zk-address</name>
    <value>vm-01:2181,vm-02:2181,vm-03:2181</value>
  </property>
  <property>
    <name>yarn.nodemanager.aux-services</name>
    <value>mapreduce_shuffle</value>
  </property>
</configuration>
提示
需要在 vm-02 中将 yarn.resourcemanager.ha.id 的值设置为 rm2,在 vm-03 中删除 yarn.resourcemanager.ha.id 属性。
编辑 /opt/hadoop/etc/hadoop/mapred-site.xml 内容如下:
<?xml version="1.0"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<configuration>
  <property>
    <name>mapreduce.framework.name</name>
    <value>yarn</value>
  </property>
  <property>
    <name>mapreduce.application.classpath</name>
    <value>
        /opt/Hadoop/share/hadoop/common/*,
        /opt/hadoop/share/hadoop/common/lib/*,
        /opt/hadoop/share/hadoop/hdfs/*,
        /opt/hadoop/share/hadoop/hdfs/lib/*,
        /opt/hadoop/share/hadoop/mapreduce/*,
        /opt/hadoop/share/hadoop/mapreduce/lib/*,
        /opt/hadoop/share/hadoop/yarn/*,
        /opt/hadoop/share/hadoop/yarn/lib/*
    </value>
  </property>
</configuration>
修改 /opt/hadoop/etc/hadoop/hadoop-env.sh 内容如下:
export JAVA_HOME=/opt/jdk
export HADOOP_LOG_DIR=/data/hadoop/logs
export HADOOP_PID_DIR=/data/hadoop/pid
修改 /opt/hadoop/etc/hadoop/yarn-env.sh 内容如下:
export JAVA_HOME=/opt/jdk
在 /opt/hadoop/sbin/start-dfs.sh 和 /opt/hadoop/sbin/stop-dfs.sh 开始位置添加:
HDFS_NAMENODE_USER=leo
HDFS_DATANODE_USER=leo
HDFS_JOURNALNODE_USER=leo
HDFS_ZKFC_USER=leo
在 /opt/hadoop/sbin/start-yarn.sh 和 /opt/hadoop/sbin/stop-yarn.sh 开始位置添加:
YARN_RESOURCEMANAGER_USER=leo
YARN_NODEMANAGER_USER=leo
修改 /opt/hadoop/etc/hadoop/workers 内容如下:
vm-01
vm-02
vm-03
方便起见可以使用 rsync 命令同步 Hadoop:
rsync -auvp /opt/hadoop-3.2.2 leo@vm-02:/opt
rsync -auvp /opt/hadoop-3.2.2 leo@vm-03:/opt
分别在 vm-01,vm-02 和 vm-03 上执行如下操作:
当所有虚拟机 zookeeper 启动完毕后,执行如下操作:
可能得到如下输出:
ZooKeeper JMX enabled by default
Using config: /opt/zookeeper/bin/../conf/zoo.cfg
Client port found: 2181. Client address: localhost. Client SSL: false.
Mode: leader
或
ZooKeeper JMX enabled by default
Using config: /opt/zookeeper/bin/../conf/zoo.cfg
Client port found: 2181. Client address: localhost. Client SSL: false.
Mode: follower
分别在 vm-01,vm-02 和 vm-03 上执行如下操作:
hdfs --daemon start journalnode
在 vm-01 上执行如下操作:
将格式化之后的元数据到其他 namenode:
rsync -auvp /data/hadoop/hdfs/namenode/current vm-01:/data/hadoop/hdfs/namenode/current
rsync -auvp /data/hadoop/hdfs/namenode/current vm-02:/data/hadoop/hdfs/namenode/current
在 vm-01 格式化 zookeeper:
分别在 vm-01,vm-02 和 vm-03 上执行如下操作:
hdfs --daemon stop journalnode
在 vm-01 启动 DFS:
/opt/hadoop/sbin/start-dfs.sh
会得到如下输出:
Starting namenodes on [vm-01 vm-02 vm-03]
Starting datanodes
Starting journal nodes [vm-01 vm-03 vm-02]
Starting ZK Failover Controllers on NN hosts [vm-01 vm-02 vm-03]
在 vm-01 启动 YARN:
/opt/hadoop/sbin/start-yarn.sh
会得到如下输出:
Starting resourcemanagers on [vm-01 vm-02]
Starting nodemanagers
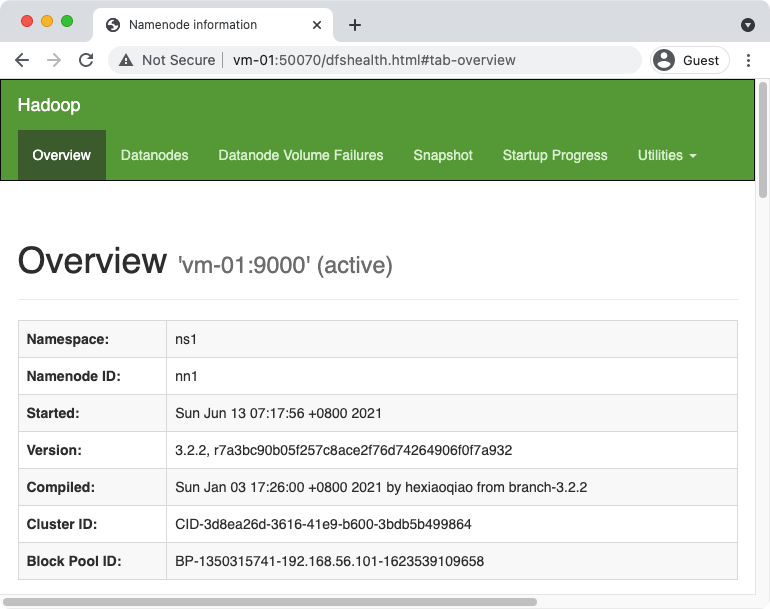
通过 http://vm-01:50070 可以进入 Hadoop Web 页面:
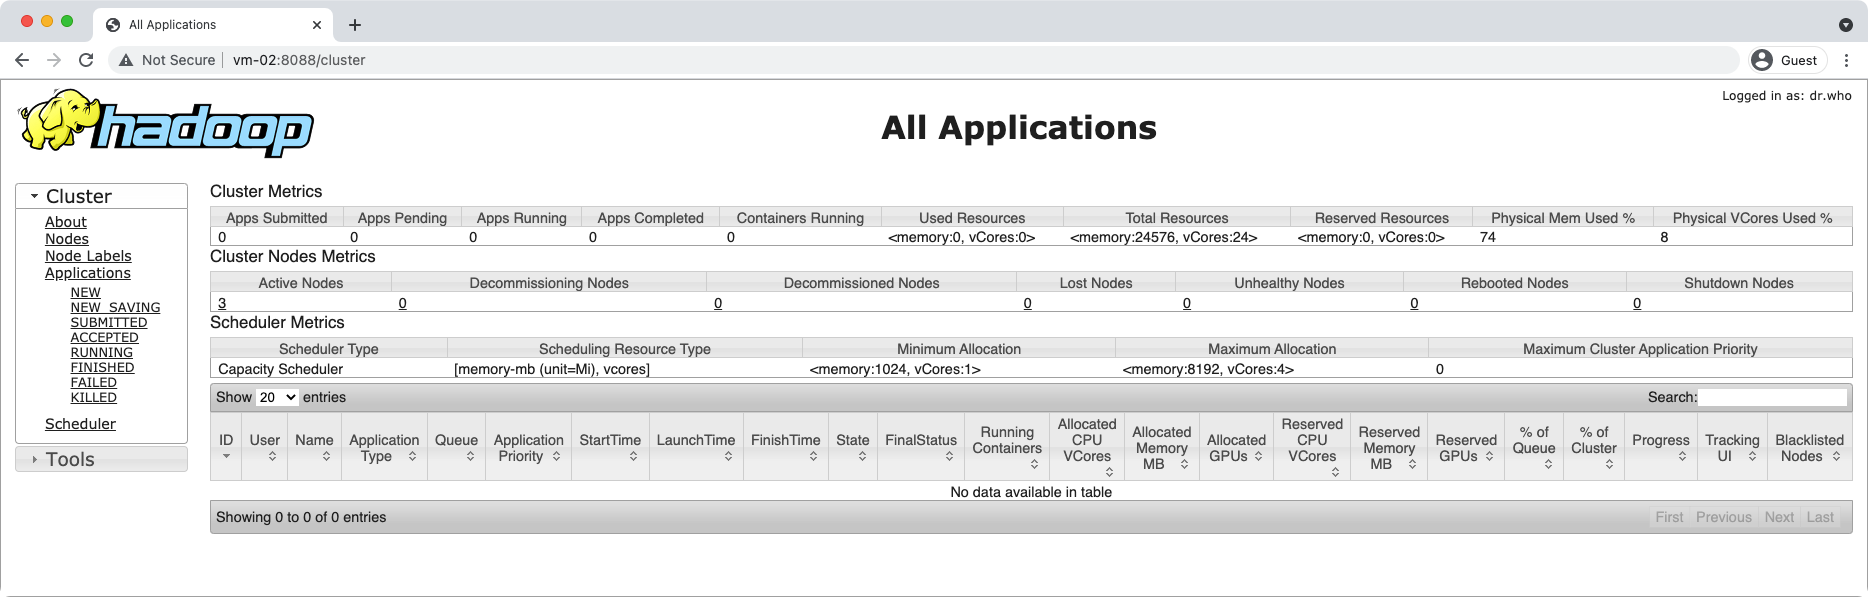
通过 http://vm-01:8088 可以进入 YARN 页面:
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。