1966 年,Joseph Weizenbaum 写出了 ELIZA。这个只有几百行代码的程序,靠一套人工编排的关键词匹配脚本,让无数用户产生了”它在听我说话”的错觉。Weizenbaum 本人对此深感不安——人们竟然愿意相信一个纯模板匹配的程序”理解”了他们 weizenbaum1966。
六十年后,大语言模型拥有千亿参数,能写代码、能翻译、能推理。人们再次争论:它真的”理解”了吗?它有”智能”吗?这场争论的声音更大、参与的人更多,但核心困惑与 ELIZA 时代并无二致——我们感受到的”智能”,到底来自系统本身,还是来自系统承载的人工?
从 ELIZA 的显式脚本到 LLM 的隐式参数,人工承载的形式发生了巨大变化,但”多少人工,就有多少智能”的底层逻辑始终如一。不同的是,今天我们有了更精确的度量框架——François Chollet 2019 年提出的智能定义——让我们可以穿透表象,回答那个从 ELIZA 时代就悬而未决的问题:智能到底是什么?它从哪里来?如何度量它?
本文是系列终章。我们将以 Chollet 的度量框架为标尺,重新审视从 ELIZA 到 LLM 的每一个系统,揭示”人工承载”从显式到隐式再到有机的演进路径,并在 Minsky 心智社会与 Chollet 度量论的交汇处,提出关于 Agent 未来的工程判断。
在展开一切讨论之前,必须先确立一个基础价值观:Agent 或 LLM 是工具。
争论一个工具有没有”意识”是没有意义的——锤子不需要有意识才能钉钉子。人是愿望的来源和存在的意义,工具的意义在于更好地完成人赋予的任务。但有一种情况例外:若要 Agent 自主制定工作计划,它需要”自知”(知道自己在做什么)、”自觉”(知道为什么这样做)、”自止”(知道何时该停止)——此时”意识”才有工具性意义。不是因为它”应该”有意识,而是因为具备这些能力后它能更好地完成某些类型的任务。
本文搁置两类担忧。第一类是人类主体性担忧——”人工智能一旦具有意识,其思考能力必然不低于人类,还要不要听人的”——这一问题预设了”有意识就会不听人的”,但工具的意义恰恰在于服务于人的愿望。第二类是道德与法律担忧——”某些任务即使机器表面上能做,也不应被委托给机器”——这是重要的规范性问题,但不在本文的讨论范围内。
本文聚焦一个实用问题:什么是”更好地完成任务”中的”智能”?它从哪里来?如何度量它?回答这个问题,需要一把精确的标尺。
François Chollet 在 2019 年的论文《On the Measure of Intelligence》中提出了一个根本性的范式转换 chollet2019。他将智能定义为:
智能是系统在任务范围、先验知识和经验的约束下,获取新技能的效率。
这一定义的核心在于把”智能”与”技能”分开。一个系统在特定任务上表现极好(如 AlphaGo 下围棋),不等于它智能——因为这种表现可能完全来自大量先验知识(训练数据)和大量经验(训练回合)。Chollet 的关键论断是:
“无限先验知识或无限训练数据允许实验者以任意方式’购买’系统任意水平的技能,从而掩盖系统自身的泛化能力。”
“购买”(buy)一词精确地揭示了问题本质:技能可以靠数据”买”来,但”买来的技能”不等于智能。真正的智能体现在面对全新任务时,以多少经验和多快的速度学会并泛化。
Chollet 进一步区分了三种泛化层次:鲁棒性(在同类任务的不同实例上保持一致)、灵活性(适应任务分布中的小变化)和泛化性(在全新类别的任务中迁移和适应)。他认为,当代 AI 评估大多停留在前两个层次,而他设计的 ARC benchmark 正是为了测试第三层:系统能否从少量示例中抽象出规则,并泛化到从未见过的任务。
Chollet 的定义包含四个相互约束的维度,它们共同构成了智能的度量空间:
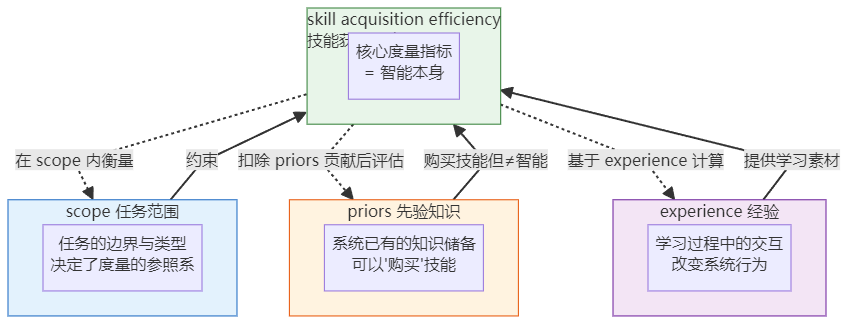
作者注: 以上四要素图是对 Chollet 定义的可视化解读,而非原文配图。将 scope、priors、experience、skill acquisition efficiency 理解为一个相互约束的度量空间,有助于我们在后续章节中系统地定位每一个 AI 系统的”智能坐标”。
这一框架将在本文后续章节中反复出现——它提供了一个统一的度量标尺,让我们可以重新审视从 ELIZA 到 LLM 的每一个系统。
“多少人工,就有多少智能”——这不是一句俏皮话,而是理解 AI 历史的一把钥匙。从符号主义时代到今天的大模型时代,人工承载经历了三次形态转变,但底层逻辑始终一致:系统表现出的技能水平,与其承载的人工知识量正相关。
ELIZA 是一个脚本引擎——它不含任何领域知识 weizenbaum1966。它的”智能”全部来自 DOCTOR 脚本的人工编排:关键词排名、分解规则、重组规则。脚本越好,用户越感觉”回答好像和输入相关”,越感觉其”智能”。但这个”智能”不在 ELIZA 程序中——它在脚本的编排中,在编排脚本的人的判断中。
在 Chollet 的框架下,ELIZA 的脚本是 priors(先验知识)——脚本编排得越好,”购买”的对话技能越多。但 ELIZA 的 skill acquisition efficiency = 0:它不能学习任何新技能。换一个脚本,它就变成另一个”人”;不换脚本,它永远只做同一件事。
STRIPS 的算子三元组由前提条件、添加表和删除表组成 fikes1971。add/del list 的本质是工程师关于”这个动作会影响到什么”的人工判断。当 STRIPS 执行 goto(room_A, room_B) 时,它”知道”位置变化——但这”知道”不是它推理出来的,而是工程师在列表中写明的。那些没有出现在列表中的谓词呢?封闭世界假设认为它们自动保持不变——这恰恰是 McCarthy & Hayes 1969 提出的框架问题的核心。
MYCIN 的每条规则形如 IF 前提 THEN 结论 WITH 置信度 shortliffe1976。CF 值从专家那里来,每条规则的置信度是专家根据经验和直觉设定的人工判断。600 条规则等于 600 个人工编码的知识单元——这就是知识获取瓶颈。MYCIN 的”智能”不在推理引擎中,而在 600 条人工编码的规则中。
在 Chollet 的框架下,STRIPS 的算子和 MYCIN 的规则都是 priors。算子越完备、规则越精确,”购买”的技能越多。但它们自身不能学习新算子或新规则——skill acquisition efficiency = 0。
LLM”吃”了大量人类文本——这些文本本身就是人工的承载。每一段文本背后都有人在思考、在表达、在组织语言。LLM 的”智能”——如果有的话——在很大程度上来自这些文本所承载的人类知识和推理模式。
从 ELIZA 的”显式脚本”到 LLM 的”隐式参数”,人工承载发生了一个关键转变:人工从可读变为不可读。ELIZA 的脚本人人可读,谁都能审查它为什么这样回答;STRIPS 的算子三元组完全透明;MYCIN 的规则和 CF 值可以追溯。但 LLM 的参数——千亿个数字——没有人能”阅读”它们。
Chollet 的论断在此精确命中:LLM 的训练数据就是 priors,千亿参数”购买”了极高水平的语言技能。但这种技能是否等同于智能?Chollet 说不是——因为 LLM 在面对训练分布外的全新任务时,泛化能力仍然有限。
下表系统对比了五个系统在 Chollet 框架下的定位:
| 系统 | 人工承载形式 | 可读性 | Chollet 框架对应 | skill acquisition efficiency |
|---|---|---|---|---|
| ELIZA | 脚本规则 | 完全可读 | priors(脚本=先验知识) | 0(不能学习新技能) |
| STRIPS | add/del list | 完全可读 | priors(算子=先验知识) | 0(不能学习新算子) |
| MYCIN | 规则+CF | 完全可读 | priors(规则=先验知识) | 0(不能学习新规则) |
| LLM | 训练文本→参数 | 不可读 | priors(参数=压缩先验)+ experience(训练过程) | 有限(可以微调,但不能在线学习) |
| 人类 | 经验+文化传承 | 隐式 | priors(进化先验)+ experience(终身学习) | 高(可以从少量示例学会新技能) |
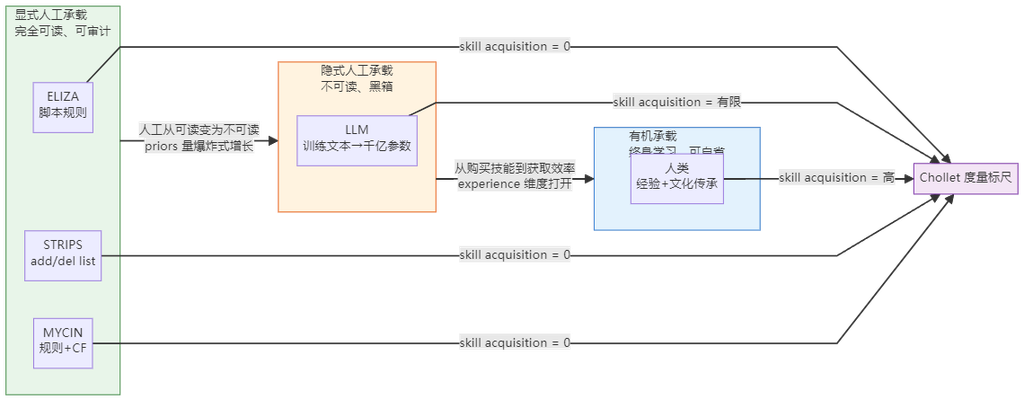
作者注: 人工承载的三阶段演进——显式、隐式、有机——是本文对 AI 历史发展路径的凝练,而非任何单一文献的论断。这一演进的核心驱动力是 priors 规模的增长与可读性的下降之间的张力:显式阶段 priors 少但透明,隐式阶段 priors 多但不可读,而有机阶段的人类同时具备丰富 priors 和内省能力。如何在保持大规模 priors 的同时恢复可读性与可审计性,是未来 Agent 工程的核心挑战之一。
如果说 priors 是智能的静态维度——系统已经知道什么——那么”尝试-错误-再选”就是智能的动态维度:系统如何从经验中学习。这个维度直接对应 Chollet 定义中的 experience 与 skill acquisition efficiency。
ELIZA 没有尝试-错误机制。给定一个输入,它做固定匹配,产生固定输出。如果匹配到了关键词 mother,它就回 Tell me more about your mother——不管这个回答是否”合适”。
ELIZA 没有”觉得不行就换方法”的能力。它不会想”这个回答好像不太对,让我换个方式”——因为它没有任何”觉得”的机制。它是 stimulus-response 的纯机械偶对。在 Chollet 的框架下,ELIZA 不能”再选”——脚本固定,永远只做同一件事。skill acquisition efficiency = 0。
STRIPS 的状态空间搜索是”尝试-错误”的:它尝试一个算子,检查是否接近目标,如果不行就回溯尝试另一个。这种搜索有明确的终止条件:目标状态满足。
Logic Theorist 证明定理、STRIPS 达到目标状态、McCarthy 的 Advice Taker 推出祈使句——它们的共同特征是目标可量化。能证就证明了,不能证就没证明;达到目标状态就到了,没达到就还没到。这些问题有”正确答案”。
但 STRIPS 的”尝试”局限在固定的搜索空间内——它可以再选算子,但不能学习新算子。skill acquisition efficiency 仍然 = 0。
ELIZA 面对的领域是心理对话——这里没有”正确答案”。说”Tell me more about your father”是好还是不好?取决于用户的感受,而不是某个可度量的指标。
MYCIN 处于此问题的中间地带。它的诊断有”正确答案”(细菌类型),但它的”好坏”对标的是”有没有人这样的水平”——以人类专家的诊断能力为基准。CF=0.8 意味着”专家有 80% 的把握”——但这个 80% 本身就是专家设定的,不是客观真值。
这种区分映射到 Chollet 的框架:智能度量必须绑定任务范围(scope)。STRIPS 的 scope 是”状态空间中的可达性”——可量化、有终止条件。ELIZA 的 scope 是”用户的主观感受”——不可量化、无终止条件。MYCIN 的 scope 是”以人类专家为基准的诊断准确率”——半量化。不同 scope 下的”智能”度量方式根本不同。
从”尝试-错误-再选”的视角看,不同系统落在一条效率光谱上:
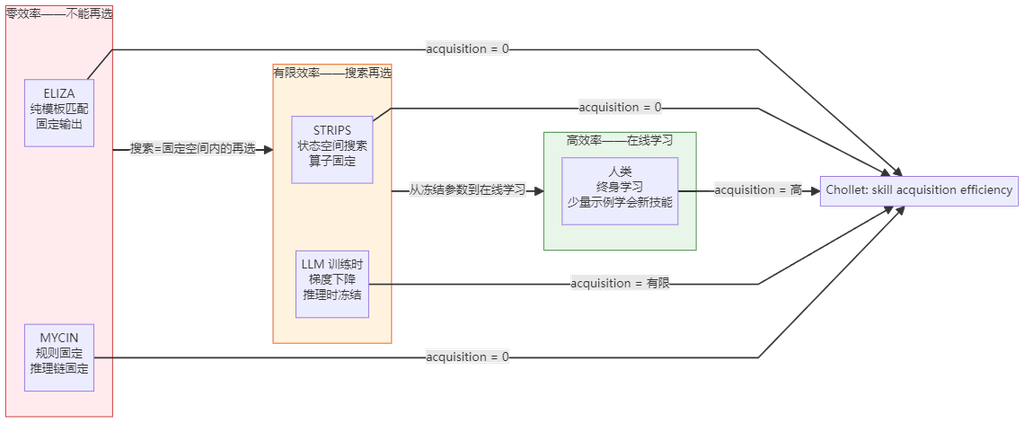
“尝试-错误-再选”本身就是学习过程。智能体现在”再选”的效率——用多少次尝试学会新技能。LLM 训练时可以”再选”(梯度下降),但推理时冻结,因此 skill acquisition efficiency 是有限的而非高的。人类可以在线”再选”——从少量经验中学会新技能——这才是 Chollet 框架下真正的高智能。
如果说”尝试-错误-再选”描述了学习的内部机制,那么”什么东西在改变系统行为”则描述了学习的外部输入。从 McCarthy 的陈述句告知,到 Brooks 的感知耦合,再到 Chollet 的经验维度——这是智能从静态走向动态的三个阶段。
McCarthy 的 Advice Taker 的核心设计是:不告诉机器”做什么”,而告诉机器”世界是什么样的”——用陈述句告知,让机器自行推出”该做什么” mccarthy1958。
McCarthy 的设计宣言是:
“The intelligence, if any, of the advice taker will not be embodied in the immediate deduction routine. This intelligence will be embodied in the procedures which choose the lists of premises to which the immediate deduction routine is to be applied.”
演绎引擎本身不含智能——智能在于选择哪些前提交给演绎引擎。这一论断在今天依然有效:LLM 的注意力机制是”即时演绎例程”,而 harness 的 prompt 工程、tool 选择、RAG 检索是”选择前提的过程”。
Brooks 1986 年的 subsumption 架构取消了”告知”和”表征”的中间步骤:感知→行为层→致动,无世界模型,无规划器 brooks1986。
“世界自身即是它最好的模型”——不需要内部表征,直接感知世界并行动。这是一种”告知”的极端简化:世界直接”告知”机器人该做什么。感知取代了告知的位置,环境本身成为了知识的来源。
LLM 的工作方式是:给定一个 prompt(告知),生成 token 序列(行动)。prompt 改变了 LLM 的输出行为——同一个 LLM,不同的 prompt 产生完全不同的输出。
但这里有一个关键区别:LLM 不能从单次交互中学习。它的”学习”是训练时的参数更新——训练完成后,参数冻结。推理时的 prompt 只是”激活”了已有参数中的某些模式,而不是”学习”了新东西。这意味着 LLM 停留在”告知改变行动”的阶段,尚未进入”经验改变行动”的阶段。
从”告知改变行动”到”感知改变行动”再到”经验改变行动”——这是智能从静态走向动态的三个阶段。
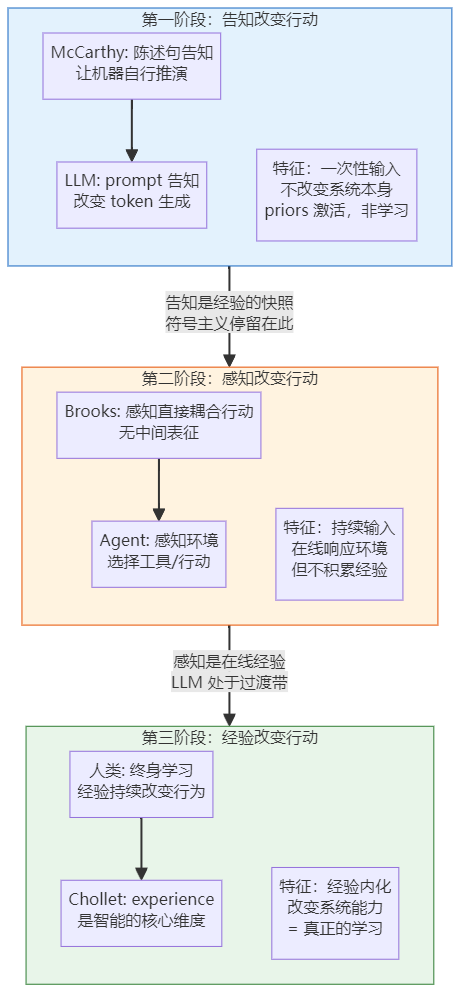
作者注: 将智能演进划分为”告知—感知—经验”三阶段,是本文在 McCarthy、Brooks、Chollet 三人思想基础上的综合凝练。符号主义系统停留在”告知”阶段——它们接收陈述句并推演,但不从中学习;LLM 处于”告知”和”感知”之间——prompt 是告知,tool-use 是感知,但推理时不积累经验;真正的智能需要”经验”维度——系统从交互中持续改变自身能力,这正是 Chollet 框架的核心诉求。Agent 技术的发展方向,就是推动系统从第一、第二阶段向第三阶段演进。
Minsky 1986 年在《心智社会》中将”将复杂行为归因于单一中央动因”的错误命名为单动因谬误(Single-Agent Fallacy)minsky1986。
Minsky 的核心论点:智能不在任何单个 agent 中,而在 agent 的组织方式中。一个由本身无智能的小 agent 组成的机构,对外可以表现出”懂行”——但这种”懂行”不是任何单个 agent 的属性,而是组织结构本身的涌现属性。
当前有一种流行倾向:把 LLM 的”智能”归因于 Transformer 架构。这恰恰是 Minsky 说的单动因谬误。
LLM 表现出的”智能”是多组件多原因造成的。Transformer 架构提供了注意力机制——一种统计匹配的内部机制;训练数据提供了人类文本的统计分布——知识的来源;RLHF 对齐通过人类反馈塑造了行为模式;Harness 框架的 prompt 工程、tool 选择、RAG 构成了”机构”的组织方式;评估方式和 benchmark 设计则定义了什么叫做”好”。
把智能归因于”Transformer 架构”就像把一栋楼的”好”归因于砖头——砖头是必要的,但”好”来自建筑设计、施工质量、装修、区位等多因素的组合。
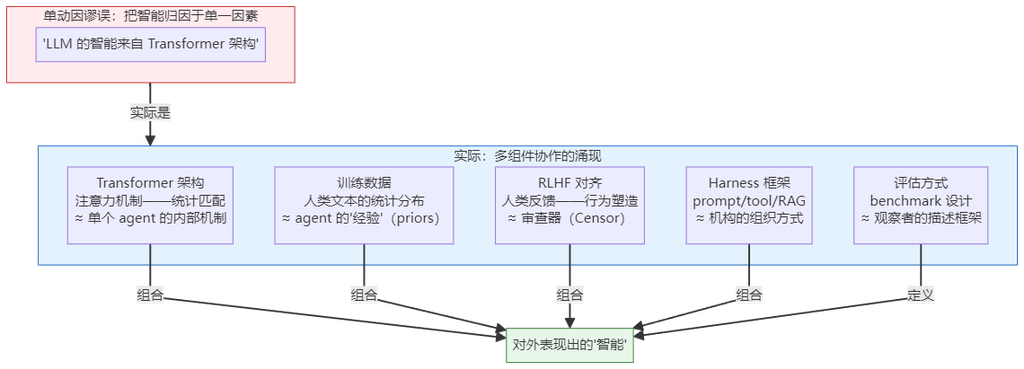
Minsky 和 Chollet 从不同维度回答了”智能在哪里”的问题:
| 维度 | Minsky 1986 | Chollet 2019 |
|---|---|---|
| 核心问题 | 智能在哪里? | 智能如何度量? |
| 回答 | 在组织方式中,不在单个 agent 中 | 在获取新技能的效率中,不在技能本身 |
| 维度 | 结构维度 | 动态维度 |
| 对 LLM 的启示 | 智能不在 Transformer 权重中,在多组件协作中 | 智能不在训练数据量中,在泛化效率中 |
两者互补:组织方式决定了”能获取什么技能”,获取效率决定了”能多快学会”。一个设计良好的 multi-agent 系统(Minsky 的启示)在限定 scope 内可能比单一 LLM 有更高的 skill acquisition efficiency(Chollet 的度量)。
复杂工作本身就需要不同角色。定计划、分工、执行、审核、测试、上线维护——这些步骤需要不同的能力和不同的角色。要求单个 Agent/LLM 一次就能干好所有事是不切实际的。
这与 Minsky 的论点形成呼应:智能不在任何单个 agent 中,而在 agent 的组织方式中。一个软件项目不是一个人从头写到尾的——有产品经理定需求、架构师设计系统、开发者写代码、测试工程师验证质量、运维工程师保障上线。每个角色专精自己的领域,通过协作完成复杂工作。
当前的多 Agent 实践——从 Claude Code 的 Agent Teams 到 Trae 的 Explore Agent,从 Loop Engineering 的 bash 循环到各种”角色扮演”式分工——本质上大多共享一个特征:同一个 LLM(大脑),不同的提示词(面具),住在同一台电脑里。
这种”同脑不同面具”的架构有其现实合理性。它解决的核心问题是上下文窗口溢出——一个 Agent 需要专注代码审查时,不应被规划阶段的上下文污染。Claude Code 的子 Agent 用独立的进程和上下文窗口实现隔离,Loop Engineering 用”repo 作为外部记忆”绕过单次对话的遗忘——”Agent 遗忘,repo 记住” loopeng。
但在 Chollet 的框架下,这一局限更清晰:同一 LLM 的 priors 和 experience 是共享的——提示词只改变了哪些 priors 被激活,没有改变 priors 本身。一个用”你是代码审查专家”提示词的 LLM,和一个用”你是测试工程师”提示词的同一个 LLM,拥有完全相同的训练数据和参数——它们的”专精”是表面的激活差异,不是结构性的能力差异。
这类似于 ELIZA 换脚本——脚本改变了输出模式,但底层的”智能”(skill acquisition efficiency)完全相同。当前的”多 Agent”在多数情况下只是”多提示词”——是 ELIZA 式换脚本的企业版。
作者注:以下为本文凝练,而非原文论断。 真正的专精化需要超越提示词层面的差异,进入结构和资源层面的差异。Minsky 的心智社会中,每个 agent 有不同的内部结构——See agent 和 Get agent 不是”同一个 agent 加不同提示词”,而是功能上根本不同的单元。放到 LLM 语境中,真正的专精化 Agent 应该在四个层面实现差异化:
| 层面 | 提示词专精(当前) | 结构专精(未来方向) |
|---|---|---|
| LLM 模型 | 同一模型,不同 system prompt | 不同模型:小模型做路由,大模型做推理,领域微调模型做专精任务 |
| 工具集 | 共享同一套工具 | 专精工具集:代码 Agent 只有编译器/调试器;文档 Agent 只有文档检索/版本控制 |
| 技能(提示词设计) | 靠编排器分配角色 | 独立的 Skill 文件:编码了该领域的操作程序、最佳实践、错误恢复策略 |
| 资源(知识库) | 共享或不使用 | 专有 RAG 知识库:代码 Agent 索引项目源码;测试 Agent 索引测试用例和 bug 历史 |
提示词专精的”多 Agent”就像让同一个人穿不同制服做不同工作——换衣服不换能力。结构专精的”多 Agent”才是让不同专业背景的人做不同工作——能力本身不同。Gartner 预测到 2026 年 40% 的企业应用将包含任务专精 Agent,到 2027 年三分之一将组合不同技能的 Agent gartner2025。小语言模型(SLM)的研究也表明,7B-70B 参数的领域微调模型在专精任务上”足够强大、更合适、更经济” slm2025。
作者注: 四层专精化——专项 LLM + 专项工具 + 专项技能 + 专项资源——不是理论设想,而是已经在萌芽的工程趋势。每一层的专精化都对应不同的工程挑战和收益:
专项 LLM:路由模型(小而快)负责分类和分发,推理模型(大而强)负责复杂决策,领域微调模型(如代码模型、医疗模型)负责专精任务。不同模型可以针对不同推理步骤选用,降低成本的同时在关键环节保持质量。
专项工具:代码审查 Agent 只需要编译器、linter 和测试运行器——不需要日历 API 或邮件发送能力。工具集的缩减降低了错误面,提高了可靠性。这对应 Minsky 的防循环纪律:每个 agent 的能力边界必须清晰,工具越少越容易核查”这个 agent 本身是否专精”。
专项技能(Skill):将领域操作程序编码为可复用的 Skill 文件——不是”提示词”,而是结构化的操作规范,包含前置条件、执行步骤、错误恢复策略。这类似于 STRIPS 的算子三元组:每个 Skill 是一个可验证的操作单元,前置条件和效果明确。
专项资源(RAG):专有知识库让 Agent 的”知识”不限于训练数据。代码 Agent 索引当前项目的源码和依赖文档;测试 Agent 索引历史 bug 和测试用例。这是 Chollet 框架中 experience 的外部化——不是靠参数记住,而是靠检索获取。Agentic RAG 将”搜索 + 摘要”升级为”推理 + 行动”,Agent 可以规划步骤、调用工具、检验结果并从新证据中学习 agenticrag。
如果真正的专精化 Agent 各有不同的 LLM、工具、技能和资源,它们之间如何协调?这是 Minsky 未解决的问题在工程中的再现。
Minsky 给出了八种协作构件:分层与异层、不妥协原则、交叉抑制、K 线记忆、框架与默认假设、审查器谱系、B 脑反思层、差动机目标机 minsky1986。这八种构件回答了”agent 之间如何协作”——但它们本身如何协调?
Minsky 的回答是”共处一脑的情境浸润”:agent 们因为共存于同一个心智中而自然影响彼此。但”情境浸润”是什么?它不是一个可操作的算法——它是一个比喻。如果协调机制不能被精确形式化,那它就不是一个工程方案,而是一个修辞。这正是 Bar-Hillel 式批评精准命中的地方:Minsky 的八种构件是组织原则的命名,而非可执行程序的规格说明。
对比 McCarthy 在 Advice Taker 中面临的 Bar-Hillel 批评——”前提选择不能自动完成”——Minsky 的问题是”协调机制不能自动实现”。两者共享同一个困境:提出了正确的直觉,但缺乏可操作的工程路径。这一困境不会因为技术进步而自动消失——它必须在组织层被显式回答。
作者注: 当前的工程实践正在给出显式协议而非”情境浸润”的答案。以下四条路径是对 Minsky 协调困境的工程化替代,也是从哲学直觉走向工程方案的必经之路:
这些机制是对 Minsky”情境浸润”的工程化替代。Minsky 的直觉是对的——智能在组织方式中——但组织方式本身必须被显式设计,而非依赖隐喻。从”情境浸润”到”消息协议”的转变,正是从哲学直觉到工程方案的必经之路。
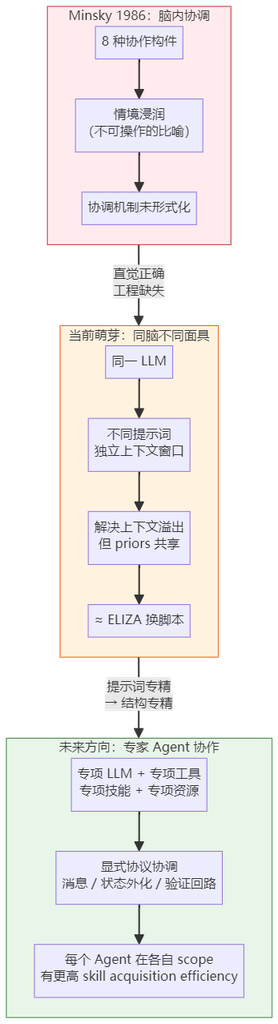
在四层专精化的框架下,每个专精化 Agent 在各自 scope 内可能有更高的 skill acquisition efficiency——因为 scope 限定后,priors 和 experience 可以更集中,泛化目标更明确。这比一个”万能但不精”的单一 LLM 更符合 Minsky 的组织论和 Chollet 的度量论。
回到我们的起点——ELIZA。在 Chollet 的框架下重新审视这个最小智能体,可以获得一些意想不到的洞察。
在 Chollet 的框架下,ELIZA 的智能 = 0。它不能学习任何新技能——脚本固定,永远只做同一件事。换一个脚本只是换了 priors,不是”获取了新技能”。
但 ELIZA 产生了强烈的智能错觉——ELIZA 效应。这说明了什么?
ELIZA 的”智能感”来自两个因素:用户投射 + 脚本编排。脚本 = priors(先验知识)。脚本越好,”购买”的对话技能越多——但系统自身的智能仍为零。
Chollet 的框架精确地解释了 ELIZA 效应:priors 购买了技能,但系统没有获取新技能的能力。用户感受到的”智能”是 priors 的效果,不是系统的属性。这与 Weizenbaum 本人的警告一致——ELIZA 让人感觉”被理解”,但这种感觉来自用户自己的投射,不是机器的理解。
Minsky 1960 年代在 MIT 的积木机器人——数百个小程序协作完成搭塔任务。每个子程序本身无智能,但组合起来表现出”智能”行为。
这与 ELIZA 的”单脚本智能”形成对照:ELIZA 是一个脚本产生的表面效果;MIT 堆箱子是多个子程序的协作涌现。在 Chollet 的框架下:MIT 堆箱子的 priors 更丰富(数百个子程序 vs 一个脚本),”购买”了更高水平的搭塔技能——但它的 skill acquisition efficiency 仍然 = 0(不能学习新的子程序)。
从 ELIZA 到 MIT 堆箱子到 STRIPS 到 MYCIN——priors 越来越丰富,”购买”的技能越来越多,但 skill acquisition efficiency 始终为零。直到 LLM 出现——LLM 可以通过训练”学习”,但它的 experience 在训练时冻结,推理时不能在线获取新技能。
回到开头的基础价值观:意识只有在”自主制定工作计划需要自知、自觉、自止”时才有工具性意义。
在 Chollet 的框架下,”自知、自觉、自止”可以被理解为一种元认知技能——系统对自己能力的认知和监控。这不是神秘的意识问题,而是一种可度量的能力:自知是系统知道自己能做什么、不能做什么(scope awareness);自觉是系统知道自己为什么选择这样做(可解释性);自止是系统知道何时该停止(终止条件判断)。
这些能力在 Chollet 的框架下是可度量的技能,而不是哲学概念。一个能”自知”的系统在”自我评估”scope 内有更高的 skill acquisition efficiency;一个能”自止”的系统在”终止判断”scope 内有更高的效率。
这是系列的最后一篇。让我们回到最初的问题,收束全系列的思考。
Agent 是工具。智能是工具效率——具体说,是工具适应新任务的能力。Chollet 的定义将其精确化:智能 = 获取新技能的效率 = 工具适应新任务的能力。
“多少人工就有多少智能”在 Chollet 的框架下可以精确化为:priors 购买了技能,但 priors ≠ 智能。ELIZA 的脚本购买了对话技能,但 ELIZA 不能学习——智能 = 0;STRIPS 的算子购买了规划技能,但 STRIPS 不能学习——智能 = 0;MYCIN 的规则购买了诊断技能,但 MYCIN 不能学习——智能 = 0;LLM 的训练数据购买了语言技能,LLM 可以微调但不能在线学习——智能 = 有限。
从 ELIZA 到 LLM,人工承载从显式变为隐式,从可读变为不可读——但本质结构不变:技能来自人工(priors),智能来自获取新技能的效率(skill acquisition efficiency)。
Minsky 告诉我们:智能不在单个 agent 中,在组织方式中。
Chollet 告诉我们:智能不在技能本身中,在获取新技能的效率中。
两者合起来对 Agent 设计的实用指导是:用专精化分工协作的组织方式,在各自 scope 内追求更高的 skill acquisition efficiency——这比”单一万能 Agent”更合理。
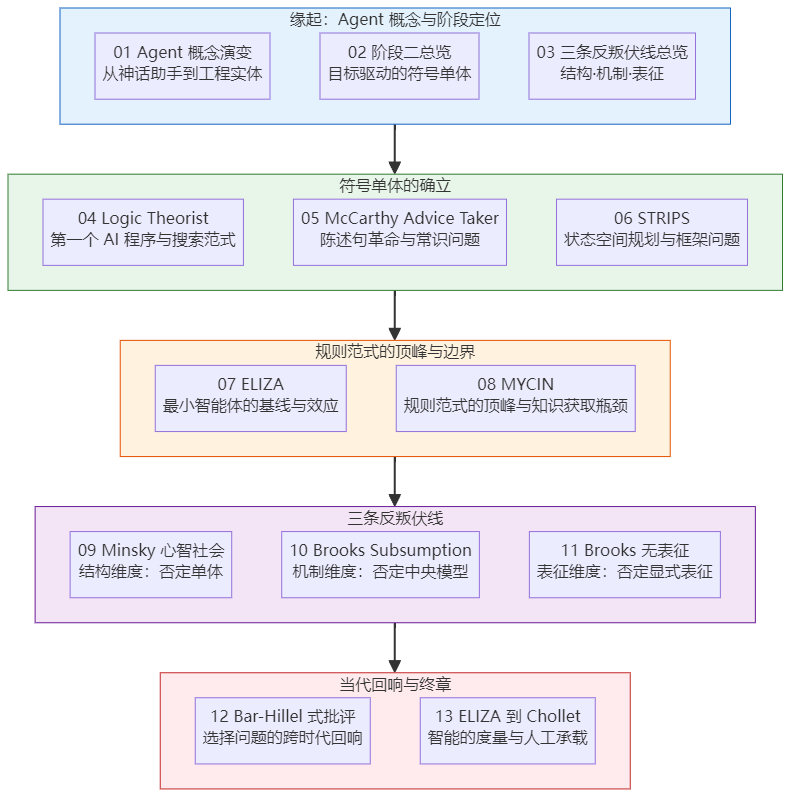
本系列共 13 篇文章,从 AI 概念的演变出发,经历了符号单体的确立、三条反叛伏线的涌现,最终到达 LLM 时代的独立回响与未来展望。
当前的多 Agent 实践——同一个 LLM、不同的提示词、同一台电脑——是专精化协作的萌芽,但不是终点。这一阶段解决的核心问题是上下文窗口管理和注意力切分,类似于让一个人在不同时间穿不同制服做不同工作。在 Chollet 的框架下,提示词只改变了 priors 的激活方式,没有改变 priors 本身——这与 ELIZA 换脚本在结构上同构。
更长远的方向是真正的专家 Agent 协作:专项 LLM + 专项工具 + 专项技能 + 专项资源。每个 Agent 在各自领域有真正不同的能力——不是提示词的激活差异,而是模型、知识、工具的结构性差异。这意味着每个 Agent 在各自 scope 内有更高的 skill acquisition efficiency——因为 priors 更集中、experience 更相关、泛化目标更明确。
Minsky 的协调困境——”情境浸润不可操作”——在这一未来中不会消失,但会被工程手段逐步替代:显式消息协议替代浸润、状态外化替代共享上下文、验证回路替代审查器直觉、编排层替代自然协调。协调机制从”自然发生”变为”显式设计”——这正是从哲学直觉到工程方案的必经之路。
从 ELIZA 的单脚本,到 STRIPS 的算子三元组,到 MYCIN 的规则库,到 LLM 的千亿参数,再到未来的专精化 Agent 协作——人工承载的形式在变(从显式到隐式再到结构化专精),但”多少人工就有多少智能”的底层逻辑不变。变化的是:未来的专精化让”人工”不再混入一个不可读的参数黑箱,而是分散到可审计的专项资源中——每个 Agent 的 priors 可被独立审查、独立优化、独立度量。
回到基础价值观:Agent 是工具,意识之争只在工具性需要时才有意义。如果自主制定工作计划需要”自知、自觉、自止”,那这些能力就是值得追求的工程目标——不是哲学上的意识,而是 Chollet 框架下可度量的元认知技能。
专精化 Agent 协作的终点不是”有意识的 Agent”,而是”每个 Agent 在各自领域足够专精,通过显式协议协作完成复杂工作”——这既是 Minsky 的心智社会在工程中的落地,也是 Chollet 的度量框架在实践中的应用。
自知,是知道自己的边界;自觉,是理解选择的理由;自止,是懂得停止的时机。 这三者不是对”意识”的哲学追求,而是对”更好的工具”的工程要求。当 Agent 具备了这些能力,它就能更好地服务于人的愿望——而这,才是智能的全部意义。
[chollet2019] Chollet, F. (2019). “On the Measure of Intelligence.” arXiv:1911.01547.
[weizenbaum1966] Weizenbaum, J. (1966). “ELIZA—A Computer Program For the Study of Natural Language Communication Between Man and Machine.” CACM 9(1): 36-45.
[fikes1971] Fikes, R. & Nilsson, N. (1971). “STRIPS: A New Approach to the Application of Theorem Proving to Problem Solving.” IJCAI 1.
[shortliffe1976] Shortliffe, E. (1976). MYCIN: Computer-Based Medical Consultations. Elsevier.
[mccarthy1958] McCarthy, J. (1958). “Programs with Common Sense.” In Mechanisation of Thought Processes, Symposium Proceedings.
[minsky1986] Minsky, M. (1986). The Society of Mind. Simon & Schuster.
[brooks1986] Brooks, R. A. (1986). “A Robust Layered Control System for a Mobile Robot.” IEEE Journal of Robotics and Automation 2(1): 14-23.
[loopeng] Huntley, G. (2025). “Ralph Wiggum as a Software Engineer” — Loop Engineering 的起源;参见 Osmani, A. (2026). “The Five Components of Loop Engineering.” Pragmatic Engineer.
[gartner2025] Gartner (2025). “Gartner Predicts 40% of Enterprise Apps Will Feature Task-Specific AI Agents by 2026.” Gartner Press Release, Aug 2025.
[slm2025] arXiv:2506.02153 (2025). “Small Language Models are the Future of Agentic AI.”
[wooldridge1995] Wooldridge, M. & Jennings, N. (1995). “Intelligent Agents: Theory and Practice.” Knowledge Engineering Review 10(2): 115-152.
[claudecode] Anthropic (2026). “Introducing Claude Code Dynamic Workflows.” Anthropic Newsroom.
[agenticrag] Instinctools (2026). “Agentic RAG: From Search+Summarize to Reason+Act.”
| Agent 考古 符号单体时代 系列文章 | 关键词 |
|---|---|
| 导读:符号单体时代:第一组织形式的确立与反叛 | — |
| Logic Theorist:符号搜索的第一台证明机器 | 手段-目的分析、状态空间搜索、定理证明 |
| McCarthy Advice Taker:陈述句革命的最早蓝图 | 陈述句告知、推理-行动闭环、属性表装配 |
| STRIPS:状态空间规划的成熟与框架问题 | 算子三元组、世界模型增量、帧问题解法 |
| ELIZA:最小智能体的基线与错觉 | 正则模式匹配、聊天机器人、智能判定陷阱 |
| MYCIN:规则范式的顶峰与边界 | 置信度推理、专家系统、规则脆性 |
| 导读:三条反叛伏线汇论:语言接口·社会涌现·具身学习 | — |
| Minsky 心智社会:单体结构的内部否定 | 单动因谬误、机构协作、K 线记忆、审查器 |
| Brooks 包容架构:感知-行动耦合的工程反叛 | 分层包容、抑制/禁止仲裁、无中央模型 |
| Brooks 无表征智能:物理接地假设的哲学宣言 | 无表征智能、四关键概念、学习四分类 |
| 回顾:Bar-Hillel 式批评:意义、翻译与框架问题 | 翻译全自动悖论、意义消解、框架问题跨代回响 |
| 终章:自知、自觉、自止——终章定论 | 历史辩证法、组织演化层积观、回到当下 |
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。