MongoDB 是目前主流的 NoSQL 数据库之一。由于历史原因,接手的一个项目底层大量使用了 MongoDB 。在学生时代对 MongoDB 也有一些了解,但是真正用到生产项目里面还是第一次。不出意外的,在使用过程中也伴随着许多不适应,也不止一次的怀念便捷的 ORM、熟悉的 SQL (甚至 InfluxDB 这种时序数据库也是兼容SQL查询的) 。这里主要讲一下,在过去一年里使用 MongoDB 中的一些新认识以及遇到的问题。

数据建模中的关键挑战是平衡应用程序的需求,数据库引擎的性能特征以及数据检索模式。在设计数据模型时,请始终考虑数据的应用程序使用情况(即查询,更新和数据处理)以及数据本身的固有结构。
很多人误以为MongoDB这类数据库就不应该存在相互之间的关联,尽量将相关数据存在同一张表里,使用嵌套的形式。
其实下面这种遵循范式的数据表设计在MongoDB中也是常见的

一般来说,在下述情况下可以使用规范化模型:
重复,并且读性能的优势又不足于盖过数据重复的弊端时候。多对多关系的时候。多层次结构数据集。引用比内嵌要更加灵活一些。 但客户端应用必须使用二次查询来解析文档内包含的引用。换句话说,对同样的操作来说,规范化模式会导致更多的网络请求发送到数据库服务器端。
从MongoDB 3.2开始,WiredTiger存储引擎是默认的存储引擎。而WiredTiger采用的数据结构就是B+Tree。参考链接:MongoDB存储引擎说明,以及 WiredTiger官方介绍。
依稀记得去年还有人问过我Mysql为什么要用B+树,谈到B+树节点间相互连接有利于快速的做范围查询。当时也是看到过类似的文章说,MongoDB由于不需要做范围查询,所以使用的占用空间比较少的B树。现在想起来,还是不能人云亦云。
MongoDB作为分布式数据库,它默认的主键的 _id 的生成方式实际上是值得好好聊聊的。
在一些早前的文章里,很容易看到下面类似的描述:
这些是 _id 的一些主要特征的摘要:
- _id 是集合中文档的主键,用于区分文档(记录)。
- _id自动编入索引。指定 { _id: } 的查找将 _id 索引作为其指南。
- 默认情况下,_id 字段的类型为 ObjectID,是 MongoDB 的 BSON 类型之一。如果需要,用户还可以将 _id 覆盖为 ObjectID 以外的其他内容。
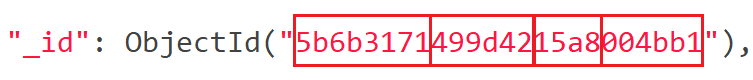
ObjectID 长度为 12 字节,由几个 2-4 字节的链组成。每个链代表并指定文档身份的具体内容。以下的值构成了完整的 12 字节组合:
- 一个 4 字节的值,表示自 Unix 纪元以来的秒数
- 一个 3 字节的机器标识符
- 一个 2 字节的进程 ID
- 一个 3 字节的计数器,以随机值开始
通常,你不必担心要如何生成 ObjectID。如果文档尚未分配 _id 值,MongoDB 将自动生成一个 _id 值。
实际上在3.4版本之后,官方文档中对ObjectId¶描述是:
ObjectIds are small, likely unique, fast to generate, and ordered. ObjectId values are 12 bytes in length, consisting of:
- a 4-byte timestamp value, representing the ObjectId’s creation, measured in seconds since the Unix epoch
- a 5-byte random value
- a 3-byte incrementing counter, initialized to a random value
所以中间ObjectId的机器标识符与进程 ID的五位被一个随机值替代了。
实际上在云原生容器化的场景下,机器标识符与进程id很有可能存在大规模的相同。因此一个随机数反而更加安全,可以保证id的唯一性。
毕竟,在同一时刻,两个独立的进程通过同样的次数,生成一样的随机数。这种情况几乎不可能发生。
在Mongodb里面存在另一种集群,就是分片技术,可以满足MongoDB数据量大量增长的需求。
优点:
当MongoDB存储海量的数据时,一台机器可能不足以存储数据,也可能不足以提供可接受的读写吞吐量。这时,我们就可以通过在多台机器上分割数据,使得数据库系统能存储和处理更多的数据。

MongoDB提供了基于哈希(hashed)和基于范围(Range)2种分片方式:
哈希分片使用hash索引来在分片集群中对数据进行划分。哈希索引计算某一个字段的哈希值作为索引值,这个值被用作片键。哈希分片以减少定向操作和增加广播操作为代价。分片集群内的数据更加均衡。从MongoDB4.0开始,mongo shell提供了convertShardKeyToHashed()方法,用于查看键的hash值。选择作为hash分片键的字段应该有良好的基数或者该字段包含大量不同的值,hash分片非常适合选取具有像objectId或时间戳那样单调更改的字段作为片键。使用sh.shardCollection()方法,来对集合进行hash分片。
1 | |
基于范围的分片会将数据划分为由片键值确定的连续范围。在范围分片模型中,具有“接近”片键的文档可能位于相同的chunk或者shard中,连续范围读取文档将变得高效,但是如果片键选择不佳,则读取和写入的想你将会降低。如果未选择其它选项(如hash分片或者zone),则基于范围的分片是默认的分片方式。范围分片片键的选择:基数大频率低非单调变化使用sh.shardCollection()方法,来对集合进行范围分片,可以选择单字段或者多字段sh.shardCollection(“database.collection”,{}) *
分片键决定了集合内的文档如何在集群的多个分片上分布数据,分片键要么是一个索引字段,要么是一个存在于集合所有文档中的符合索引字段。MongoDB尝试在集群中的各个分片之间平均分配数据块(chunk),特别注意,shard之间平均分配的数据块(chunk),而不是数据量,分片键的选择直接关系到分片结果的好坏。NOTE:在MongoDB4.2之前,文档的分片字段是不可以修改的。从4.2版本开始,除非分片键是不可变的_id字段,否则你可以更新文档的分片字段。所有需要分片的集合都必须具有支持分片的索引,即分片键上必须有索引,可以使分片键的索引,也可以是符合索引,对于符合索引,分片键必须是索引的前缀。如果集合为空,则sh.shardCollection()在分片键上自动创建索引,无需认为干预如果集合存在数据,则必须先创建索引,然后再使用sh.shardCollection()来为集合分片。分片键的选择需要综合考虑分片键的基数、频率和变化率。
基数。分片键的基数决定了分片集群可以创建的最大chunk的数目。在任何给定的时间,唯一的分片值只能存在一个chunk上。例如:使用性别进行分片,则只能分为“男”和“女”2个chunk,不能随着数据增多而分裂为更多的chunk,因为一个分片值只能存储在同一个chunk中。
频率。频率代表给定值在该列中出现的比率,与关系型数据库中select distinct …异曲同工。如果大多数文档包含了这些值的子集,那么存储这些文档的chunk将成为集群中的瓶颈,随着数据的增长,他们将会成为不可分割的数据块,降低了集群水平扩展的有效性。例如:集合people用来统计各个名族的人信息,使用名族作为分片字段,那么根据我国56个名族的人数分布,占据人口总数92%的汉族将占据一个chunk,这样会导致该chunk非常巨大,失去了分片的意义。
变化率。单调递增或单调递减的分片键可能将数据写到集群中的单个分片上。如果分片键值始终在增加,则所有新插入都将路由到以maxKey为上限的块。 如果分片键值始终在减小,则所有新插入都将路由到以minKey为下限的块。 包含该块的分片将成为写操作的瓶颈。
MongoDB的模糊查询可以使用 $regex 运算符通过正则表达式来进行匹配查询。$regex :为查询中的模式匹配字符串提供正则表达式功能 。
语法:
1 | |
options 中设置i模式可以进行忽略大小写的匹配。但是这样大概率不会使用索引,将会进行全表扫描。
本人有幸使用这个语句,查询某个亿级单表时,将整个MongoDB集群CPU拉爆。。。事后explain( )语句分析了下相关的查询语句,发现早前设置的索引确实没有命中。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。