
惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

H
Help Net Security
腾讯CDC
爱范儿
爱范儿
Google DeepMind News
V
V2EX
Blog — PlanetScale
Blog — PlanetScale
Engineering at Meta
Engineering at Meta
GbyAI
GbyAI
量子位
F
Fortinet All Blogs
G
Google Developers Blog
T
The Blog of Author Tim Ferriss
Cyber Security Advisories - MS-ISAC
Hugging Face - Blog
Hugging Face - Blog
Last Week in AI
Last Week in AI
T
Tailwind CSS Blog
J
Java Code Geeks
S
SegmentFault 最新的问题
D
Docker
博客园 - 司徒正美
The GitHub Blog
The GitHub Blog
Jina AI
Jina AI
M
MIT News - Artificial intelligence
博客园 - 【当耐特】

又见苍岚

COLMAP PatchMatch Stereo 算法详解 事件驱动的状态机框架:从理论到工程实践 Git 在国内网络环境下无法 Push 的排查与修复 —— 配置 Clash 代理 分段五次多项式插值原理详解 路径插值方法深度对比研究 Claude Code 使用指南 OpenClaw 记忆管理与技能创建指南 CBS(Conflict-Based Search)算法详解 A* 算法及其变种详解 OpenClaw 配置多 Agents Windows Powershell 无法加载文件,因为在此系统上禁止运行脚本问题的解决方案 MaxClaw 安装流程 大模型 AI 名词介绍 AList 网盘聚合工具简介 Protobuf 简介与测试 Claude Code 简介以及 GLM 4.7 模型接入 Github 歌词下载工具 163MusicLyrics Python __getattr__ 懒加载 Python TypedDict 机器人仿真平台 Gazebo 安装记录 机器人仿真平台 Gazebo 简介 多机器人路径规划问题(Multi-Agent Path Finding, MAPF)简介 Python exifread 读取修改过的 jpeg 信息错误问题修复 3D 坐标系变换的理解 3D 旋转矩阵基本概念 MongoDB Compass 介绍 Python 环境管理工具 uv Flutter 开发指南 Snipaste 安装下载与黑屏问题解决方案 全局路径规划算法记录
对比损失 Contrastive Loss
Yiwei Zhang · 2023-12-15 · via 又见苍岚

Contrastive Loss(对比损失)是一种损失函数,通常用于训练对比学习(Contrastive Learning)模型,这些模型旨在学习数据中的相似性和差异性。本文记录相关内容。

简介

Contrastive Loss(对比损失)是一种损失函数,通常用于训练对比学习(Contrastive Learning)模型,这些模型旨在学习数据中的相似性和差异性。对比学习的主要目标是将相似的样本对映射到接近的位置,而将不相似的样本对映射到远离的位置。Contrastive Loss 有助于实现这一目标。

Contrastive Loss 可以认为是ranking loss类型,我们平时ML任务的时候,用的最多的是cross entropy loss或者MSE loss。需要有一个明确的目标,比如一个具体的数值或者是一个具体的分类类别。但是ranking loss实际上是一种metric learning,他们学习的相对距离,相关关系,而对具体数值不是很关心。
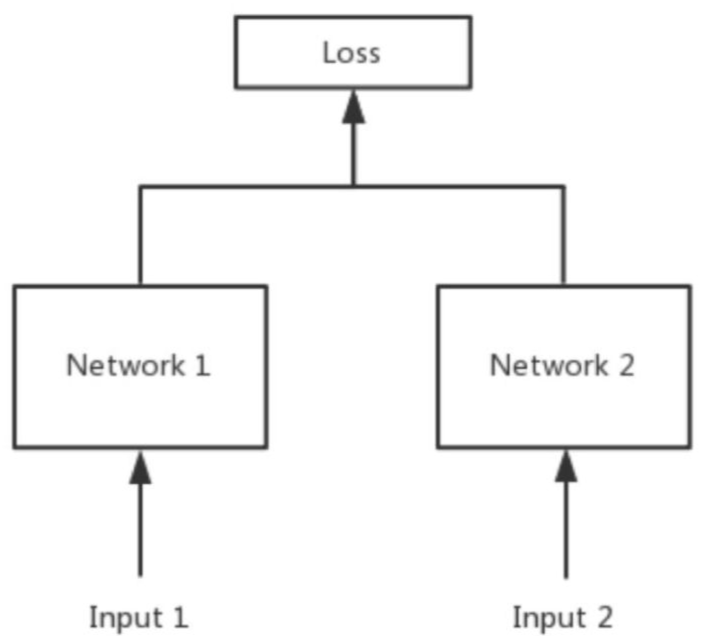
对比损失

对比损失大多数情况下运用在孪生网络(siamese network)中,这种损失函数可以有效的处理孪生神经网络中的paired data的关系(形式上并不一定是两个Net,也可以是一个Net两个Out,可以认为上面示意图的Network1和2是同一个,或者不是同一个)。contrastive loss的表达式如下:

$$ L=\frac{1}{2N}~\sum_{n=1}^Nyd^2+(1-y)\max(margin-d,0)^2 $$

其中 $\mathrm{d=||a_n-b_n||_2}$ 代表两个样本特征的欧氏距离,y为两个样本是否匹配的标签,y=1代表两个样本相似或者匹配,y=0 则代表不匹配,margin为设定的阈值。

这种损失函数最初来源于Yann LeCun 的 Dimensionality Reduction by Learning an Invariant Mapping,主要是用在降维中,即本来相似的样本,在经过降维(特征提取)后,在特征空间中,两个样本仍旧相似;而原本不相似的样本,在经过降维后,在特征空间中,两个样本仍旧不相似。

观察上述的contrastive loss的表达式可以发现,这种损失函数可以很好的表达成对样本的匹配程度,也能够很好用于训练提取特征的模型。

  • 当 $y=1$(即样本相似)时,损失函数只剩下 $∑ y d^ 2 $ ,即原本相似的样本,如果在特征空间的欧式距离较大,则说明当前的模型不好,因此加大损失。
  • 当 $y=0$ 时(即样本不相似)时,损失函数为 $∑ ( 1 − y )\max ( m a r g i n − d , 0 ) ^2 $ ,即当样本不相似时,其特征空间的欧式距离反而小的话,损失值会变大,这也正好符号我们的要求。

其中 $margin$ 是一个超参,相当于是给 $loss$ 定了一个上界($margin$ 平方),如果 $d$ 大于等于 $margin$,那么说明已经优化的很好了,$loss=0$。

下图表示的就是损失函数值与样本特征的欧式距离之间的关系,其中红色虚线表示的是相似样本的损失值,蓝色实线表示的不相似样本的损失值。
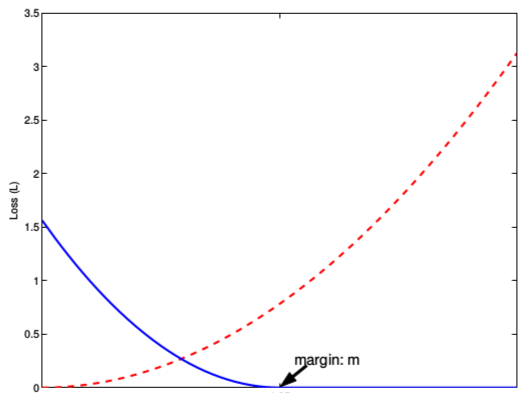
Contrastive Loss 的目标是最小化正样本对的距离或相似度,同时确保负样本对的距离或相似度大于一定的阈值 $margin$。这样,模型就会学习到在嵌入空间中更好地区分相似和不相似的样本。

参考资料

文章链接:
https://www.zywvvd.com/notes/study/deep-learning/loss/contrastive-loss/contrastive-loss/