惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

S
SegmentFault 最新的问题
Jina AI
Jina AI
罗磊的独立博客
V
Visual Studio Blog
freeCodeCamp Programming Tutorials: Python, JavaScript, Git & More
J
Java Code Geeks
U
Unit 42
Microsoft Azure Blog
B
Blog RSS Feed
爱范儿
爱范儿
酷 壳 – CoolShell
酷 壳 – CoolShell
Last Week in AI
Last Week in AI
T
The Blog of Author Tim Ferriss
腾讯CDC
Hugging Face - Blog
Hugging Face - Blog
T
Tailwind CSS Blog
让小产品的独立变现更简单 - ezindie.com
I
InfoQ
月光博客
月光博客
博客园_首页
Vercel News
Vercel News
P
Proofpoint News Feed
GbyAI
GbyAI
Y
Y Combinator Blog

又见苍岚

COLMAP PatchMatch Stereo 算法详解 事件驱动的状态机框架:从理论到工程实践 Git 在国内网络环境下无法 Push 的排查与修复 —— 配置 Clash 代理 分段五次多项式插值原理详解 路径插值方法深度对比研究 Claude Code 使用指南 OpenClaw 记忆管理与技能创建指南 CBS(Conflict-Based Search)算法详解 A* 算法及其变种详解 OpenClaw 配置多 Agents Windows Powershell 无法加载文件,因为在此系统上禁止运行脚本问题的解决方案 MaxClaw 安装流程 大模型 AI 名词介绍 AList 网盘聚合工具简介 Protobuf 简介与测试 Claude Code 简介以及 GLM 4.7 模型接入 Github 歌词下载工具 163MusicLyrics Python __getattr__ 懒加载 Python TypedDict 机器人仿真平台 Gazebo 安装记录 机器人仿真平台 Gazebo 简介 多机器人路径规划问题(Multi-Agent Path Finding, MAPF)简介 Python exifread 读取修改过的 jpeg 信息错误问题修复 3D 坐标系变换的理解 3D 旋转矩阵基本概念 MongoDB Compass 介绍 Python 环境管理工具 uv Flutter 开发指南 Snipaste 安装下载与黑屏问题解决方案 全局路径规划算法记录
原神——提瓦特大陆语音提取解析
Yiwei Zhang · 2023-05-24 · via 又见苍岚

语音训练需要优质的数据,我们尝试使用原神中的语音进行训练,首先需要提取并解析其中的语音信息。

感谢 B站大佬的分享

处理流程

  1. 找到数据
  2. 解压数据
  3. 解密数据

数据处理

找到数据

在 PC 版原神中,音频文件放在游戏文件夹中,我的路径为:

D:\Program Files\Genshin Impact\Genshin Impact Game\YuanShen_Data\StreamingAssets\AudioAssets\Chinese

3.7 版原神共 114 个语音文件 9.38 g,将其中的数据拷贝出来。

解压数据

拿到的数据均为 使用 Extractor2.5 解压数据

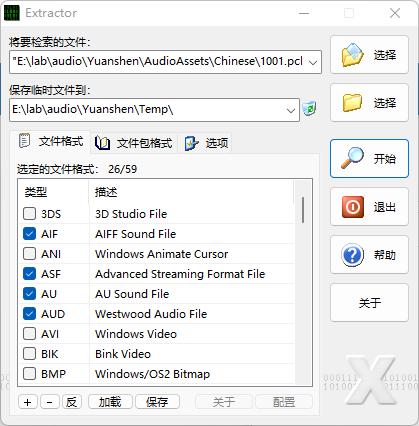
下载工具后解压,打开 exe 文件即可运行,选择所有刚刚生成的语音文件作为输入文件,选择输出文件夹:
开始解压:
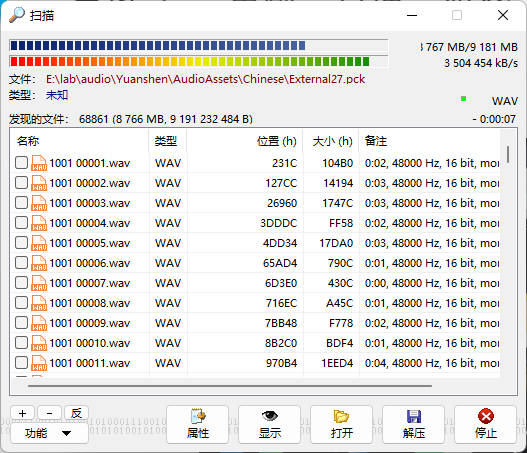
之后反选所有数据, 选择解压即可。

共拿到语音 72021 条。

解密数据

解压直接得到的数据无法听到语音,需要进行解密:

需要用到项目: https://github.com/vgmstream/vgmstream

进入项目的 release 下载需要的编译文件(以我当前 Win 为例):
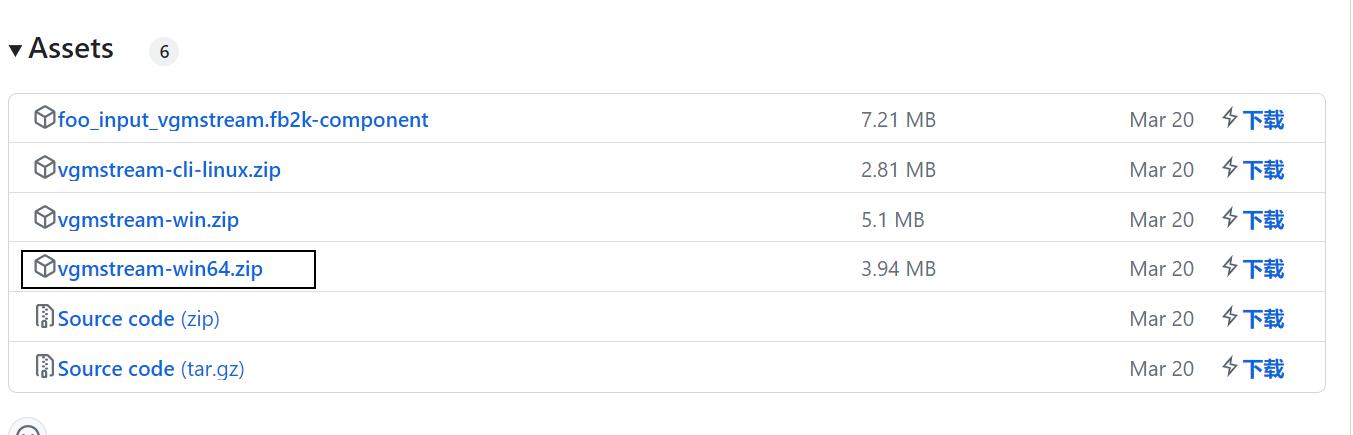
下载链接

下载后解压,得到可执行文件,将其加入系统路径

这样就可以使用 vgmstream-cli.exe 直接运行解密了

编写 Python 脚本:

1
2
3
4
5
6
7
8
9
10
11
import mtutils as mt
import os

target_file_path_list = mt.glob_recursively('Temp', 'wav')

for target_file_path in mt.tqdm(target_file_path_list):
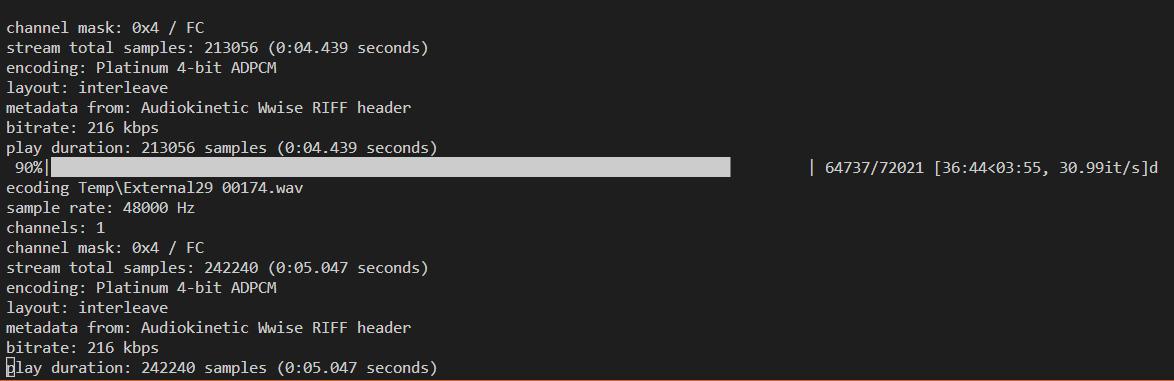
os.system(f'vgmstream-cli "{target_file_path}"')
mt.remove_file(target_file_path)
mt.file_rename(target_file_path + '.wav', target_file_path)
pass

我将数据放到 Temp 文件夹,脚本在 Temp 外一层,可以直接运行。

脚本 os.system 命令中空格字符需要用双引号包住

在我的机器上运行四十分钟解密所有语音文件,得到 72021 条。

筛选数据

粗略筛选数据,删除 200k 以下的音频文件,最终得到原神原始音频 57546 条。

参考资料

文章链接:
https://www.zywvvd.com/notes/study/audio/yuanshen-audio/yuanshen-audio/