惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

S
SegmentFault 最新的问题
G
Google Developers Blog
Stack Overflow Blog
Stack Overflow Blog
WordPress大学
WordPress大学
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
罗磊的独立博客
月光博客
月光博客
IT之家
IT之家
爱范儿
爱范儿
Google DeepMind News
小众软件
小众软件
C
Check Point Blog
B
Blog RSS Feed
H
Help Net Security
博客园 - 司徒正美
L
LangChain Blog
MongoDB | Blog
MongoDB | Blog
B
Blog
The Cloudflare Blog
Apple Machine Learning Research
Microsoft Security Blog
M
MIT News - Artificial intelligence
N
Netflix TechBlog - Medium
钛媒体:引领未来商业与生活新知
钛媒体:引领未来商业与生活新知

Mox的笔记库

2026PPoPP MLIR Tutorial学习 | Mox的笔记库 MacOS配置《明日方舟:终末地》 | Mox的笔记库 2025:向内生长 | Mox的笔记库 由mlir::ExecutionEngine引发的跨系统问题 | Mox的笔记库 WSL2配置Cuda-Tile环境记录(未完待续) | Mox的笔记库 Vibe Coding手搓项目记录 | Mox的笔记库 给Debian上包——以DuckDB为例 | Mox的笔记库 UCPD.sys事件存档 | Mox的笔记库 换新电脑之Mac mini M4从购买到配置 | Mox的笔记库 Mac配置MLX-C开发环境 | Mox的笔记库 RISC-V meets RDBMS——RISC-V架构上可运行数据库一览 | Mox的笔记库 DuckDB Sort实现调查 | Mox的笔记库 修复Redis在树莓派5上无法运行的问题 | Mox的笔记库 如何在MLIR中自定义类型并且输出运行 | Mox的笔记库 网站网络结构变更记录 | Mox的笔记库 SIGMOD25论文阅读:BPF-DB:——A Kernel-Embedded Transactional Database Management System For eBPF Applications Apache Arrow Gandiva项目解析 | Mox的笔记库 VLDB24论文阅读:Cloud-Native Database Systems and Unikernels——Reimagining OS Abstractions for Modern Hardware NoisePage源码分析(未完待续) | Mox的笔记库 VLDB20论文阅读:Mainlining Databases——Supporting Fast Transactional Workloads on Universal Columnar Data File Formats VLDB17论文阅读:Relaxed Operator Fusion for In-Memory Databases:Making Compilation, Vectorization, and Prefetching Work Together At Last 论文阅读:How not to structure your database-backed web applications——a study of performance bugs in the wild SIGMOD24阅读:ROME——Robust Query Optimization via Parallel Multi-Plan Execution 文章阅读:First Past the Post-Evaluating Query Optimization in MongoDB SIGMOD文章阅读:Apache Calcite——A Foundational Framework for Optimized Query Processing Over Heterogeneous Data Sources VLDB23论文阅读:Analyzing the Impact of Cardinality Estimation on Execution Plans in Microsoft SQL Server SIGMOD22论文阅读:Efficient Massively Parallel Join Optimization for Large Queries VLDB论文阅读:Weaving Relations for Cache Performance VLDB22论文阅读:ConnectorX——Accelerating Data Loading From Databases to Dataframes 论文阅读:UniKraft-Fast, Specialized Unikernels the Easy Way
EDBT25论文阅读:PhoebeDB——A Disk-Based RDBMS Kernel for H...
MocusEZ · 2025-07-22 · via Mox的笔记库

PhoebeDB是云和恩墨(enmotech)的数据库项目,这篇论文发表于EDBT 2025的Industry and Application Track,其中有些技术特性还是很有意思的

论文地址:https://openproceedings.org/2025/conf/edbt/paper-292.pdf

技术背景

一款以OLTP为主,在操作层面支持HTAP的,与PostgreSQL高度兼容单机数据库,主要针对SSD存储与大内存普及情况下的高性能OLTP的解决方案(这点和Umbra很像,但Umbra更侧重于OLAP)

实现细节

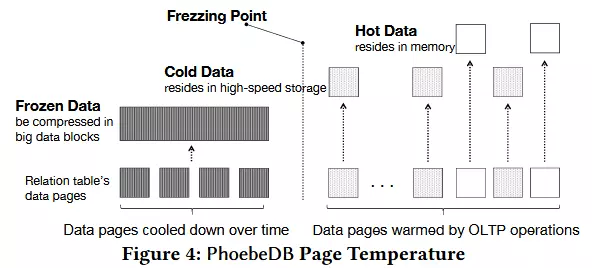
冷热分层存储
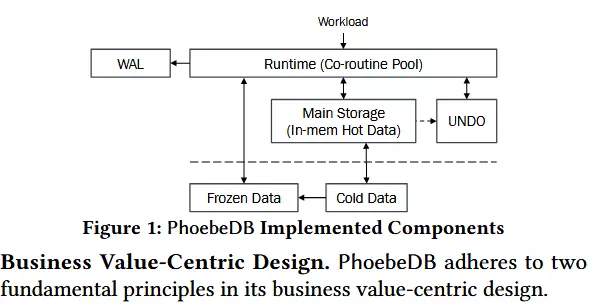
image-20250721205251333

image-20250721205420352

热数据放入内存,冷数据放入硬盘,这里面有一套判断与维护的机制

存储用的数据结构是B-Tree(有别于TiKV的LSM-Tree),采用的时PAX格式用于HTAP

Swizzle Point(指针转换/指针混编)
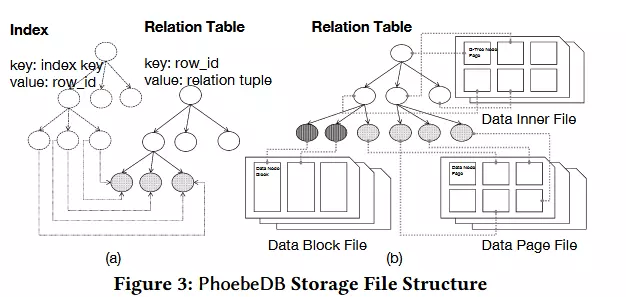
image-20250721205435246

实现了一套类似Leanstore的SwizzlePoint机制,关于SwizzlePoint不了解的可以看看AI怎么说

Google Gemini:

在计算机科学中,“swizzle pointer”(指针转换/指针混编)通常指的是将一种形式的引用(通常是基于名称、位置或文件偏移量的引用)转换为另一种形式的引用(通常是直接的内存地址指针)的操作。这个过程最常发生在数据从持久存储(如磁盘文件)加载到内存中时。

以下是关于 swizzle pointer 的几个关键点:

1. 目的

  • 提高性能: 当数据从磁盘加载到内存后,如果对象之间仍然使用基于磁盘地址或ID的引用,每次访问都需要进行查找或翻译,这会带来性能开销。通过将这些引用转换为直接内存指针,可以实现内存速度的访问,显著提高程序运行效率。
  • 处理持久化数据: 当我们把内存中的数据结构(比如一个链表或树)保存到磁盘时,不能直接保存内存地址,因为下次加载时这些地址很可能不再有效。所以,在保存时需要进行“反转换”(unswizzling),将内存指针转换为独立于位置的引用(例如,文件偏移量、唯一ID或数组索引)。当数据再次加载到内存时,就需要进行“swizzle”操作,将这些独立于位置的引用重新转换为新的内存指针。

2. 过程

Swizzling(加载/反序列化时):

  • 将非内存引用转换为内存指针: 当数据从磁盘文件(如数据库、可执行文件或自定义数据结构文件)加载到内存中时,数据内部可能包含指向其他数据片段的引用,这些引用不是直接的内存地址。例如,它可能是一个文件中的偏移量,或者一个对象的唯一ID。
  • “swizzle pointer”操作会将这些非内存引用“翻译”成当前加载到内存中的对象的实际内存地址。这样,程序就可以直接通过指针来访问相关数据,而不需要额外的查找或解析步骤。

Unswizzling(保存/序列化时):

  • 将内存指针转换为非内存引用: 当内存中的数据结构需要被保存到磁盘时,内存中的直接指针必须被“unswizzle”(反转换)回一种与位置无关的形式,这样即使数据被加载到不同的内存地址,引用关系也能保持有效。

3. 应用场景

  • 数据库管理系统(DBMS): 在数据库中,对象通常通过对象ID (OID) 或磁盘地址来引用。当这些对象被加载到内存中的缓冲区时,为了提高访问速度,它们的内部引用会被“swizzle”成内存地址。当数据需要写回磁盘时,这些地址又会被“unswizzle”回原始的OID或磁盘地址。
  • 持久化对象系统: 在一些面向对象的系统中,对象可以在内存和磁盘之间进行透明的存取。指针转换是实现这种透明性的关键技术之一。
  • 可执行文件加载: 当操作系统加载一个可执行文件到内存时,文件中的相对地址和符号引用会通过指针转换被解析成实际的内存地址。
  • 序列化和反序列化: 在将复杂数据结构序列化(保存)和反序列化(加载)时,指针转换是处理内部引用和链接的常用方法。

4. 注意事项

  • 复杂性: 如果数据结构中存在循环引用,指针转换会变得更加复杂,需要仔细管理旧引用和新地址之间的映射关系。
  • 安全性: 不当的指针转换实现可能导致安全漏洞,例如允许攻击者访问预期范围之外的内存地址。
  • 性能权衡: 尽管指针转换可以提高运行时性能,但转换本身会带来一定的开销,特别是在频繁加载和卸载数据时。因此,需要根据具体应用场景进行权衡。

总结来说,“swizzle pointer” 是一种优化技术,它通过在数据从持久存储加载到内存时,将位置无关的引用转换为直接内存指针,从而提高程序访问数据结构中对象的速度。

Co-routine Pool for High Concurrency(高并发协程池)
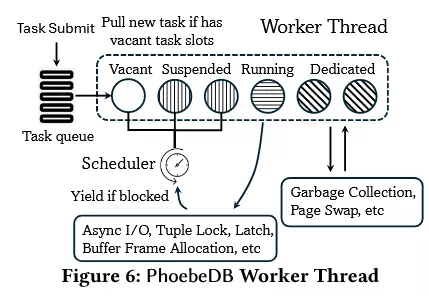
image-20250721210051402

我的理解就相当于时间片分配,协程(Coroutine)根据需要分配到不同的线程(感觉比较像Go语言中的协程概念?),这种方案可以有效利用异步IO,当线程结束时触发GC与页面交换(Page Swap)机制,同时也会删除些WAL

MVCC事务
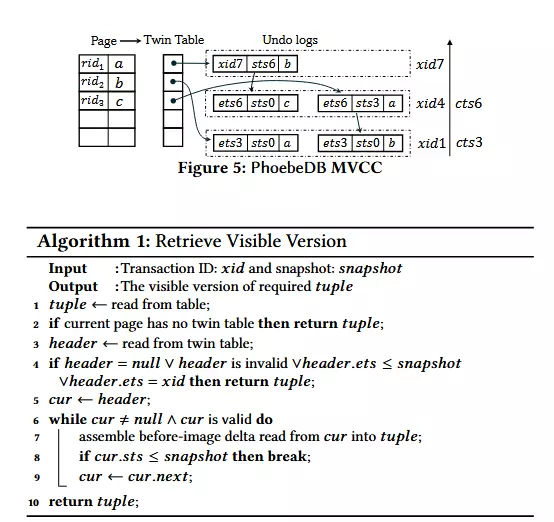
image-20250721210537011

拥有完整的MVCC事务,承诺拥有和PostgreSQL一致的事务隔离级别,这一块概念我没看太明白(坑以后再填Doge)

其事务不需要全局的Hasthtable进行锁管理,似乎可以分开管理

实验结果

在CentOS 9上运行TPC-C实验集,比PostgreSQL快27倍,tpmC指标为1370万(13.7 million)

编译基础设施:GCC 11

CPU:Intel(R) Xeon(R) Gold 5320 CPUs
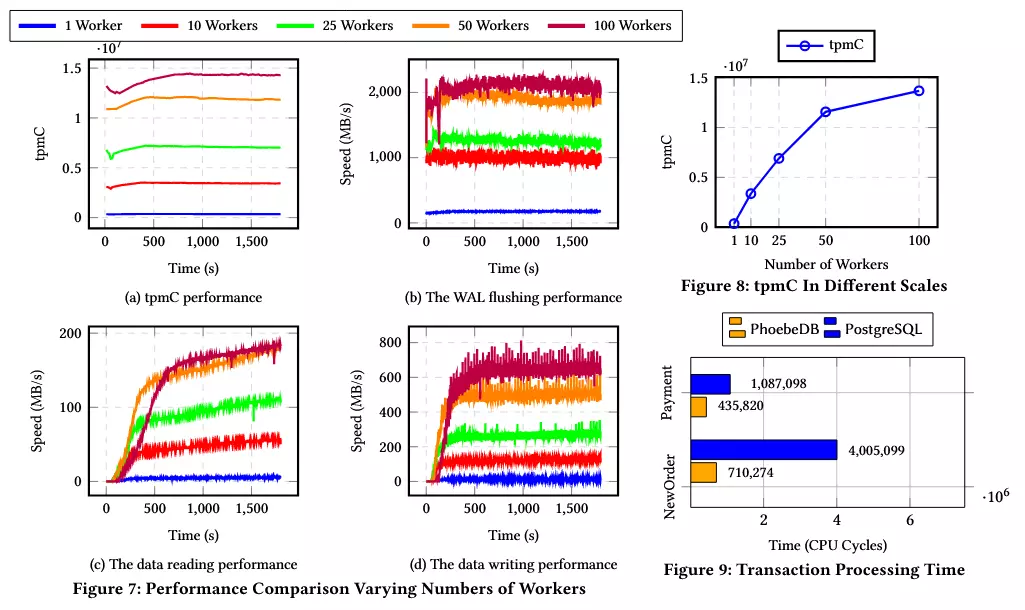
image-20250721210911748

结语

感觉除了Kernel By-Pass和NUMA,把能用于提升事务的数据库技术都给用上了

该数据库目前还在演进中,期待日后会有更多惊喜

avatar

探索未曾设想的道路