惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

MyScale Blog
MyScale Blog
F
Fortinet All Blogs
Cyber Security Advisories - MS-ISAC
D
Docker
freeCodeCamp Programming Tutorials: Python, JavaScript, Git & More
爱范儿
爱范儿
V
Visual Studio Blog
Last Week in AI
Last Week in AI
WordPress大学
WordPress大学
aimingoo的专栏
aimingoo的专栏
小众软件
小众软件
L
LangChain Blog
Vercel News
Vercel News
阮一峰的网络日志
阮一峰的网络日志
IT之家
IT之家
P
Proofpoint News Feed
博客园_首页
D
DataBreaches.Net
T
The Blog of Author Tim Ferriss
The GitHub Blog
The GitHub Blog
酷 壳 – CoolShell
酷 壳 – CoolShell
C
Check Point Blog
Engineering at Meta
Engineering at Meta
Microsoft Azure Blog

任霏博客

我将关闭服务器:AI彻底掐死了奄奄一息的个人博客 - 博客文章 - 任霏的个人博客网站 Vibe Coding 实现本地模型 Token 自由 IntelliJ IDEA + LM Studio + LM Link + Continue - 博客文章 - 任霏的个人博客网站 1Password涨价后,别急着退订1Password,这个操作能帮你省25% - 博客文章 - 任霏的个人博客网站 我,吃饱了撑的注册了个域名,Cloudflare账号没了,不建议将域名放在Cloudflare - 博客文章 - 任霏的个人博客网站 临时邮箱:保护隐私与免骚扰的新方式 - 博客文章 - 任霏的个人博客网站 价值4100万美元SOL被盗SwissBorg在Solana上遭遇安全事件超200万枚ETH排队退出质押 - 博客文章 - 任霏的个人博客网站 注意 Web3 钱包遭遇 NPM 超大规模供应链攻击投毒事件 - 博客文章 - 任霏的个人博客网站 我受到以太坊ERC-20假代币地址投毒攻击记录一下大家谨防上当受骗 - 博客文章 - 任霏的个人博客网站 在2025年使用显卡 NVIDIA RTX 2080 Ti 挖矿收益记录和分析还能不能挖矿 - 博客文章 - 任霏的个人博客网站 分享我是如何成功戒烟的经验(包含失败的经验) - 博客文章 - 任霏的个人博客网站 在 OpenWRT 中配置 PassWall2 插件的教程记录 - 博客文章 - 任霏的个人博客网站 Office Professional Plus 2019 VL 版下载与 KMS 激活 - 博客文章 - 任霏的个人博客网站 最近几天我的 CDN 流量受到来自电信[山东烟台]、[江苏扬州]两地家庭宽带的攻击 - 博客文章 - 任霏的个人博客网站 自建AI服务器使用PVE配置显卡直通虚拟机安装驱动、CUDA和cuDNN运行LLM大模型进行AI炼丹 - 博客文章 - 任霏的个人博客网站 各代英特尔Intel芯片组主板适配兼容的CPU和DDR内存数据统计 - 博客文章 - 任霏的个人博客网站 GitLab Global 国际站将在60天内删除中国大陆、香港、澳门地区的账号 - 博客文章 - 任霏的个人博客网站 Github Copilot Free 开放免费版所有人均可使用 OpenAI GPT-4o、Anthropic Claude 3.5 AI 代码生成服务 - 博客文章 - 任霏的个人博客网站 Cloudflare 更新了订阅协议明确禁止优选IP和搭建梯子的行为 - 博客文章 - 任霏的个人博客网站 Linux(systemd)手动离线安装二进制(binary)MairaDB数据库指定版本 - 博客文章 - 任霏的个人博客网站 流程引擎 Flowable/Activiti 无法启动报错:liquibase - Waiting for changelog lock.... - 博客文章 - 任霏的个人博客网站 Spring Boot 全局异常捕获 ControllerAdvice 无法捕获 过滤器(Filter)和拦截器(Interceptor)中的异常 - 博客文章 - 任霏的个人博客网站 Freenom 收回了全部免费域名(.tk/.cf/.gq/.ga/.ml) - 博客文章 - 任霏的个人博客网站 Alibaba Druid 数据库连接池 takeLast() AQS 死锁导致程序无响应 - 博客文章 - 任霏的个人博客网站 你的网站加入 HSTS preload 预加载列表了吗 - 博客文章 - 任霏的个人博客网站 我的博客网站接入使用 Cloudflare 的架构分享 - 博客文章 - 任霏的个人博客网站 在 Ubuntu 上的 Nginx 高并发配置实践 - 博客文章 - 任霏的个人博客网站 技术分析黑客敲诈勒索站长的新手法百度对此也无能为力 - 博客文章 - 任霏的个人博客网站 百度站长平台快速收录权限和sitemap提交权限被全部收回 - 博客文章 - 任霏的个人博客网站 极狐 GitLab 免费时代结束不升级付费账号将禁止登陆 - 博客文章 - 任霏的个人博客网站 免费.ml域名10年委托合同到期被马里共和国收回域名经营权 - 博客文章 - 任霏的个人博客网站
Hadoop入门教程(五):HDFS 分布式文件系统 - 博客文章 - 任...
任霏 · 2021-03-12 · via 任霏博客

教程索引目录请访问:《大数据技术入门级系列教程》

HDFS是指 Hadoop Distributed File System,Hadoop分布式文件系统。HDFS是一个高度容错性的系统,适合部署在廉价的机器上。HDFS能提供高吞吐量的数据访问,非常适合大规模数据集上的应用。

任何事物都有优缺点,世界上没有完美的东西,大数据使用 Hadoop 并不是说它很完美,而是暂时没有找到比它更好的解决方案。

HDFS的优点

HDFS的设计天生就是数据冗余的,所以数据会很安全,有很高的容错性,即使其中一个节点整个丢失也不会影响数据安全,因为数据将被分布在多个节点,并且存储多份,所以我们可以使用廉价的机器来存储我们宝贵的数据。

同时分布式的设计可以让集群拥有非常大的存储容量,可以是GB、TB、PB甚至是EB的容量。

HDFS的缺点

因为它的优点就会带来缺点,因为文件被分布在多个节点,所以获取文件的延迟就很严重,不像是单硬盘中获取数据那样毫秒级的读写数据。

同时因为 HDFS 是采用分布式存储,这就需要 NameNode 的帮助来记录文件分布在哪里,如果你有大量的小文件存储需求,也是不适合的,这会给 NameNode 带来非常大的压力。

不支持文件并发写和随机修改,也就是说 HDFS 并不能像硬盘那样随时修改数据,而是只能追加文件或者写入以后只进行读取操作。

HDFS的组成

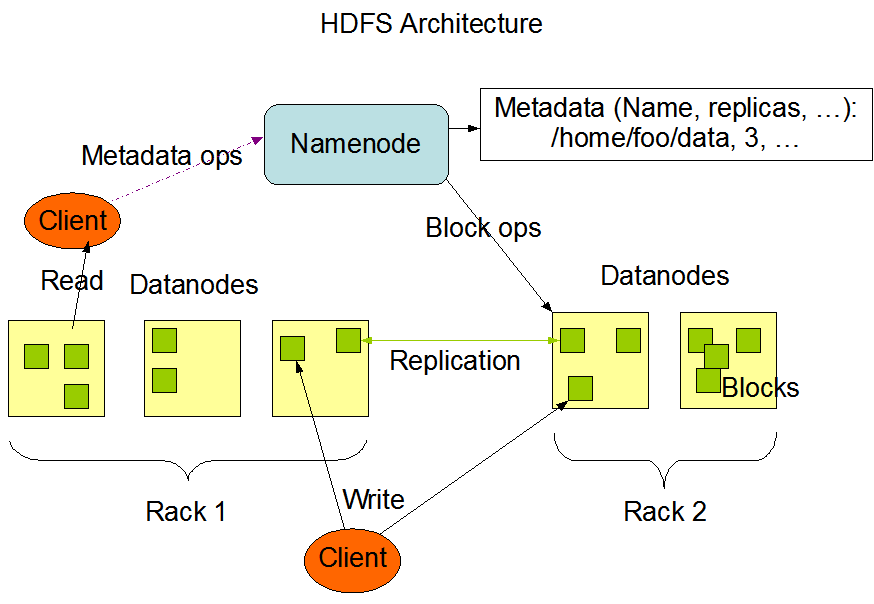
这里引用 Hadoop 官网文档的一个结构图,其中主要描述的就是三大块。

HDFS的组成

NameNode

NameNode是Master主管,它负责管理 HDFS、副本策略、数据块(Block)映射信息、处理客户端的读写请求。

DataNode

DataNode是Slave从属,它负责存储实际的数据块(Block)、读写数据

Client

Client是客户端,客户端对数据进行切分成多个数据块(Block)进行上传,与 NameNode 交互获取文件数据块(Block)的位置信息,与 DataNode 交互读写数据,主要通过客户端对 NameNode 下达命令。

HDFS的Block

HDFS 文件系统跟我们日常使用的硬盘还有个最大的不同之处就是数据块(Block),HDFS 并不是存储一个一个的文件,而是一个一个的数据块(Block),然后把数据块(Block)一个一个的存储在不同的集群节点中,需要提取文件的时候再从各个集群节点中提取出数据块(Block),恢复成我们原始的文件。

数据块(Block)的大小可以通过配置进行改变,但默认 Hadoop2.x 是128MB,Hadoop1.x 是64MB。

为什么是128M呢

我们需要先关注一下读取文件都发生了什么?

1.去询问 NameNode 我需要的文件都在哪里,这个叫寻址

2.去对应的 DataNode 读取数据块(Block),这里才是实际传输数据

假设我们的数据块(Block)很小,那么就会产生非常多的数据块(Block),在第一步寻址就会花费很长时间;那加入数据块(Block)很大呢,虽然数据块(Block)数量会减少,寻址会很快,但第二步可能就会很慢,因为硬盘的IO性能也是有限的。

目前市面上的机械硬盘读取速度都在 100MB/S 左右,如果将数据块(Block)设置成128M基本就是每秒读取一个数据块(Block),而寻址时间基本是10ms左右,这样搭配更合理一些,所以如果你的磁盘性能比较高的话可以将数据块(Block)调大,反之调小。我们使用默认的就可以。

HDFS的Shell命令

关于 HDFS 的 Shell 命令,我就不说太多了,因为我讲的话也是去抄官方文档,不如直接去看官方文档:https://hadoop.apache.org/docs/r2.10.1/hadoop-project-dist/hadoop-hdfs/HDFSCommands.html

我只讲几个常用的给起个头,剩下的就得自己看文档了。其实 HDFS 的操作和 Linux 中的操作十分像,所以上手会很快,来举个例子。

bin/hadoop fs 具体命令

显示目录信息:hadoop fs -ls /

创建文件夹:hadoop fs -mkdir -p /renfei/test

显示文件内容:hadoop fs -cat /renfei/test/hadoop.txt

是不是和 Linux 的操作一样的命令?所以我就不再啰嗦了,直接看官方文档吧。下一篇我们将使用编程的方式操作 HDFS。