
惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

V
Visual Studio Blog
Engineering at Meta
Engineering at Meta
月光博客
月光博客
钛媒体:引领未来商业与生活新知
钛媒体:引领未来商业与生活新知
T
Tailwind CSS Blog
博客园 - Franky
The GitHub Blog
The GitHub Blog
大猫的无限游戏
大猫的无限游戏
The Cloudflare Blog
B
Blog RSS Feed
云风的 BLOG
云风的 BLOG
小众软件
小众软件
罗磊的独立博客
Microsoft Azure Blog
I
InfoQ
美团技术团队
H
Hackread – Cybersecurity News, Data Breaches, AI and More
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
V
V2EX
C
Check Point Blog
WordPress大学
WordPress大学
博客园 - 【当耐特】
博客园 - 司徒正美
D
Docker

Mereith's Blog

记一次代理转发问题的排查与解决 PVE DataCenter Manager 端口号跳转错误修复 k8s + jenkins + gitlab 触发器 【转载】没有编程生产力这样的东西 【后续】居然被 ddos 了 居然被 ddos 了 Tagger - 让版本标签管理更简单 openclash 开启后端口转发失效 nextjs 启动时执行代码 买了太多VPS不知道干什么,干脆做个网站 juhost Level-1 测评 VMISS CN - Hong Kong VMISS JP - Tokyo - BGP 测评 VMISS CN - Hong Kong - BGP HomeLab 的终点是 最近在做的事情 因为选择艰难症,自己写了一套开源博客系统 手撸一个nodejs分布式爬虫,还要可视化 HomeLab 分享 我的个人工作流——开源项目推荐 动手写一个超简单的编译器 safari 插件开发 Safari Extensions Preferences 按钮无响应 设置移动端软键盘回车按钮文案 nginx proxy manager 非标准端口反代 Host 不对 监控 k8s ingress 自动添加域名 DNS 解析 使用 ingress 注解给 traefik ingress 添加中间件 使用流水线功能为文章添加固定结尾 为 VanBlog 添加一个小挂件 基于React/umi/egg自建博客系统 如何正确停止 NodeJS 子进程
【python爬虫】基于scrapy的小说爬虫
wanglu@mereith.com (mereith) · 2022-07-21 · via Mereith's Blog

请注意,本文编写于 2266 天前,最后修改于 1416 天前,其中某些信息可能已经过时。

前言

最近一直在学爬虫,从最基本的urllibrequestsbeautifulsoup到分布式爬虫框架scrapy,现在终于感觉可以上路了。所以先基于scrapy重写了我以前做的小说爬虫,代码都很简单,就不注释了。相关的知识点在我的python爬虫系列文章后面都会介绍到。 主要的参考文献:
思路

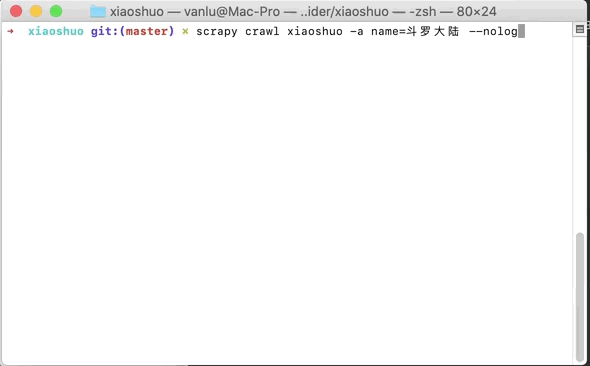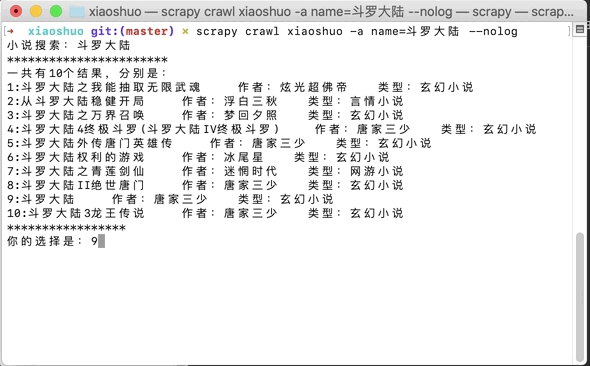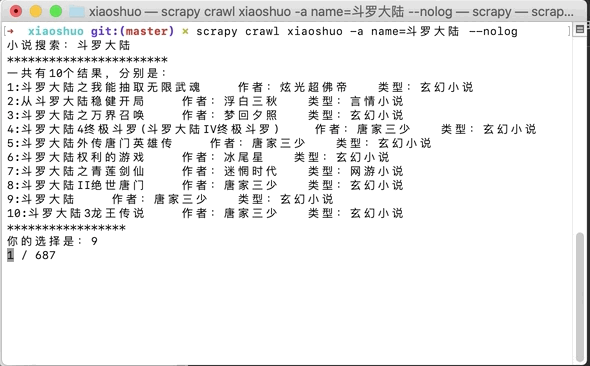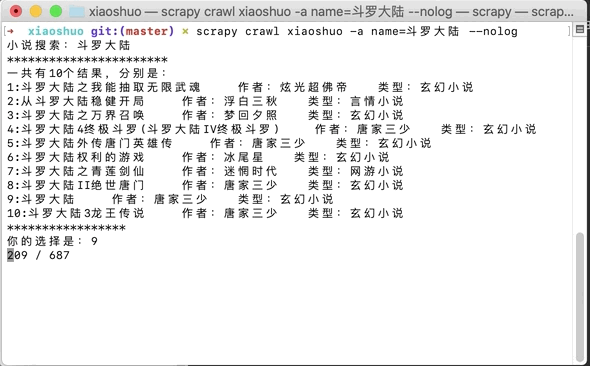
1.搜索小说名,用requests+lxml爬取结果,并让用户选择结果,返回小说目录的url 2.scrapy根据目录url解析小说章节数以及每章的具体url,其中把小说章节数送给item再到itempipeline保存,每章的url则是生成异步请求,结果送给parse_chapter进行下一步的解析 3.parse_chapter解析每一章的内容,替换没用的\xa0,写入到item里,返回交给pipeline处理 4.对于pipeline为了写入文件章节顺序是对的,每次返回的item都先保存到包括当前章节编号和内容的字典里 5.爬取完毕,对字典进行排序,写入到小说文件中

使用说明

依赖

需要安装:

scrapy requests

直接pip instal scrapy requests即可,如果scrapy安装不了需要编译没成功的话,那么到这个网站下载自己对应编译好的再用pip安装即可

运行

项目目录中打开shell运行

scrapy crawl xiaoshuo -a name=小说名 --nolog

代码

请移步github