原文:Why I Like Using Maps (and WeakMaps) for Handling DOM Nodes
在处理大量DOM节点时,Map(和WeakMap)是非常实用的工具,本文分析了具体原因。
我们在JavaScript中使用大量普通的老式对象(POJO),来存储键值对数据,它很好用——清晰、易读:
1
2
3
4
5
| const person = {
firstName: 'Alex',
lastName: 'MacArthur',
isACommunist: false
};
|
但是当开始处理大量频繁读取、修改、添加属性的实体时,人们更常见的做法是采用Map这种数据结构。原因是:在特定的场景下,Map比对象有更多的优势,特别是存在性能敏感的问题,或者插入顺序非常重要时。
但在最近,我开始意识到它们特别适合的场景:处理大量DOM节点。
我在读Caleb Porzio最近的一篇博客时冒出了这个想法。在这篇博客中,他设计了一个10000行的表格作为示例,每一行都可以“激活”。为了管理每一行的选中状态,使用了一个对象存储键值对。以下是其中一个迭代的注释版本。我还补充了分号,因为我可不是野蛮人(译注:这里作者开玩笑,说不加句尾分号的是野蛮人)。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
| import { ref, watchEffect } from 'vue';
let rowStates = {};
let activeRow;
document.querySelectorAll('tr').forEach((row) => {
rowStates[row.id] = ref(false);
row.addEventListener('click', () => {
if (activeRow) rowStates[activeRow].value = false;
activeRow = row.id;
rowStates[row.id].value = true;
});
watchEffect(() => {
if (rowStates[row.id].value) {
row.classList.add('active');
} else {
row.classList.remove('active');
}
});
});
|
这些代码运行良好(而且和本文主题没有直接冲突,所以并无冒犯之意)。但是!它使用的是对象,一个大型的类似哈希映射表的结构。用来关联值(value)的键名(key)必须是字符串,因此在每一行必须有一个唯一ID(或其他字符串),在生成和读取这些ID时,必然带来额外的代码成本。
任何对象都可以作为键名
与之不同的是,Map允许使用HTML节点作为键名(key),因此这段代码改成了这样:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
| import { ref, watchEffect } from 'vue';
- let rowStates = {};
+ let rowStates = new Map();
let activeRow;
document.querySelectorAll('tr').forEach((row) => {
- rowStates[row.id] = ref(false);
+ rowStates.set(row, ref(false));
row.addEventListener('click', () => {
- if (activeRow) rowStates[activeRow].value = false;
+ if (activeRow) rowStates.get(activeRow).value = false;
activeRow = row;
- rowStates[row.id].value = true;
+ rowStates.get(activeRow).value = true;
});
watchEffect(() => {
- if (rowStates[row.id].value) {
+ if (rowStates.get(row).value) {
row.classList.add('active');
} else {
row.classList.remove('active');
}
});
});
|
最明显的好处是,不需要操心每一行的唯一ID了。每一行的HTML节点引用它自身作为键名——自然是唯一的。这样,就不需要设置或读取任何属性了,更简单、更有弹性。
读写操作一般而言是性能良好的
“一般而言”的斜体,是因为在大部分案例中,性能差异是微不足道的。但当你处理更大的数据集,读写操作就会显示出性能优势。这甚至是写在规范中的——Map的构建必须保证数据持续增长时的性能:
Map在实现过程中,使用的哈希表或其他机制,必须保证在数据集的元素数量增长时,平均访问时间呈亚线性变化。
“亚线性”代表性能不会随着Map大小的增长率而降级。所以,即使时很大的Map也会保持相对快的读写速度。
即使没有性能优势,也没有必要搞一个DOM属性,或者用字符串ID来查找。每个键名就是它自己的引用,可以省去一步或两步操作。
我还做了一些基本的性能测试,来验证这些想法。首先,根据Caleb的场景,我在页面上生成了10000个<tr>元素:
1
2
3
4
5
6
7
8
9
10
| const table = document.createElement('table');
document.body.append(table);
const count = 10_000;
for (let i = 0; i < count; i++) {
const item = document.createElement('tr');
item.id = i;
item.textContent = 'item';
table.append(item);
}
|
然后,我写了一个脚本,循环所有行,在对象或Map中存储一些相关状态,测量花了多长时间。我还在for循环中将相同的过程重复很多次,然后确定了平均的读写时间。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
| const rows = document.querySelectorAll('tr');
const times = [];
const testMap = new Map();
const testObj = {};
for (let i = 0; i < 1000; i++) {
const start = performance.now();
rows.forEach((row, index) => {
});
times.push(performance.now() - start);
}
const average = times.reduce((acc, i) => acc + i, 0) / times.length;
console.log(average);
|
我用不同的行数进行了测试。
|
100行 |
10000行 |
100000行 |
| 对象 |
0.023ms |
3.45ms |
89.9ms |
| Map |
0.019ms |
2.1ms |
48.7ms |
| 快(%) |
17% |
39% |
46% |
注意,这些结果在不同的环境中可能有很大差异,但总体来看,结果符合我的预期。当处理相对少的数量时,Map和对象的性能是相当的。但随着数量增加,Map开始拉开差距,亚线性的性能变化开始发力。
另外还有一个Map接口的特别版本,能更好的管理内存——WeakMap。它对键名(key)的引用是“弱引用”,任何键名在其他地方失去引用绑定,就符合垃圾回收的标准。因此,当键名不再被使用时,键名+键值就从WeakMap中被整个砍掉了,能清理更多的内存。这种机制对DOM节点而言同样有效。
为了弄出效果,我们将会使用FinalizationRegistry,在监听的引用被垃圾回收时,会触发回调(我从来没想到还有这么好用的东西,哈哈)。我们先从一个小列表开始:
1
2
3
4
5
| <ul>
<li id="item1">first</li>
<li id="item2">second</li>
<li id="item3">third</li>
</ul>
|
接下来,我们把这些列表项放入WeakMap,注册监听item2。我们将会移除item2,当它被垃圾回收时,回调函数会被触发,然后我们就能看WeakMap有何变化了。
但是…垃圾回收是不可预测的,而且也没有官方的方法手动触发,所以为了触发我们定时生成了大量对象,并将它们驻留在内存中。以下是完整脚本:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
| (async () => {
const listMap = new WeakMap();
document.querySelectorAll('li').forEach((node) => {
listMap.set(node, node.id);
});
const registry = new FinalizationRegistry((heldValue) => {
console.log('回收后:', heldValue);
});
registry.register(document.getElementById('item2'), listMap);
console.log('回收前:', listMap);
document.getElementById('item2').remove();
const objs = [];
while (true) {
for (let i = 0; i < 100; i++) {
objs.push(...new Array(100));
}
await new Promise((resolve) => setTimeout(resolve, 10));
}
})();
|
一开始,WeakMap包含3个列表项,符合预期。但在item2被移出DOM,发生垃圾回收时,它变了:
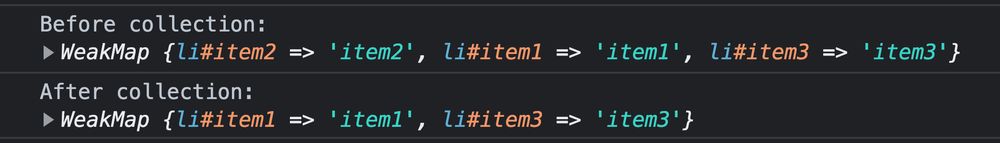
由于DOM中不再有对该节点的引用,WeakMap中item2的键名和键值被整个移除,释放了一点内存。这个特性我很喜欢,它能帮助环境中的内存保持更干净的状态。
太长不看版本
我喜欢用Map操作DOM节点,因为:
- 节点自身可以用作键名,不需要在每个节点上搞属性读写的事。
- 对大量的数据而言,它从设计到实现,都有更好的性能。
- 节点作为
WeakMap的键名,在节点从DOM移除时,可以实现自动的垃圾回收。
其他使用案例?
类似Map和Set的“新”特性,用在有趣的现实场景中,让我感觉很有意思。如果你也有类似的想法,和我分享一下吧!






