
惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

博客园 - 司徒正美
大猫的无限游戏
大猫的无限游戏
腾讯CDC
J
Java Code Geeks
博客园 - 【当耐特】
Microsoft Azure Blog
V
Visual Studio Blog
人人都是产品经理
人人都是产品经理
博客园 - Franky
博客园 - 聂微东
阮一峰的网络日志
阮一峰的网络日志
美团技术团队
云风的 BLOG
云风的 BLOG
freeCodeCamp Programming Tutorials: Python, JavaScript, Git & More
U
Unit 42
雷峰网
雷峰网
B
Blog RSS Feed
博客园_首页
量子位
F
Fortinet All Blogs
罗磊的独立博客
H
Hackread – Cybersecurity News, Data Breaches, AI and More
酷 壳 – CoolShell
酷 壳 – CoolShell
C
Check Point Blog

魔改工程师

获取大写字母瓷砖拼出独特图案数量 - 魔改工程师 日志文件异常检测 - 魔改工程师 **操作历史管理器的撤销/重做能力** - 魔改工程师 项目模块依赖构建顺序规划 - 魔改工程师 端口流量统计 - 魔改工程师 最大化游戏试玩资格分发 - 魔改工程师 前言 - 魔改工程师 前言 - 魔改工程师 前言 - 魔改工程师 前言 - 魔改工程师 前言 - 魔改工程师 YOLO26改进 – 特征融合 重参数化CSPELAN模块(Reparameterized CSPELAN Module)通过结构重参数化实现高效特征提取 YOLO26改进 – 特征融合 融合Hyper-YOLO混合聚合网络MANet(Mixed Aggregation Network)通过多路径设计实现高效特征学习与模型适应性提升 YOLO26改进 – 特征融合 RepGFPN重参数化特征金字塔网络 ,实现高效多尺度特征交互与融合 YOLO26改进 – 特征融合 EFC增强层间特征相关性,通过多尺度特征交互减少冗余信息丢失即插即用 - 魔改工程师 YOLO26改进 – 注意力机制 融合HCF-Net维度感知选择性整合模块DASI 增强小目标显著性 前言 - 魔改工程师 YOLO26 改进 – 注意力机制 HaloNet 局部自注意力 (Local Self-Attention) 以分块交互策略实现高效全局上下文建模 YOLO26 改进 – 注意力机制 DiffAttention差分注意力:轻量级差分计算实现高效特征降噪,提升模型抗干扰能力 TMLR 2025 前言 - 魔改工程师 YOLO26 改进 – 注意力机制 CAFM (Convolutional Block Attention Module) 卷积块注意力模块:轻量级设计优化特征提取流程,提升小目标感知 YOLO26 改进 – 注意力机制 ACmix自注意力与卷积混合模型:轻量级设计融合双机制优势,实现高效特征提取与推理加速 前言 - 魔改工程师 前言 - 魔改工程师 前言 - 魔改工程师 2026最新YOLO26改进:卷积层、轻量化、注意力机制、损失函数、Backbone、SPPF、Neck、检测头全方位优化汇总 - 魔改工程师 前言 - 魔改工程师 YOLO26改进 – SPPF模块 替代SPPF,FFocal Modulation焦点调制:即插即用轻量设计优化全局语义捕获 前言 - 魔改工程师 YOLO26改进 – SPPF模块 发论文神器!LSKA注意力改进SPPF,增强多尺度特征提取能力,高效涨点!!! - 魔改工程师
前言 - 魔改工程师
魔改工程师 · 2026-06-24 · via 魔改工程师

本文介绍了新型视觉适配器微调方法Mona,并将其集成到YOLO26中。传统全参数微调成本高、存储负担重且有过拟合风险,现有PEFT方法性能落后。Mona仅调整5%以内的骨干网络参数,在多个视觉任务中超越全参数微调。其核心亮点包括参数效率高、性能突破和即插即用。适配器模块包含降维、多认知视觉滤波器等单元,通过深度可分离卷积和多尺度卷积核处理视觉信号,还加入分布适配层优化输入分布。我们将Mona集成到YOLO26,经注册和配置yaml文件后进行实验,展现出良好效果。

文章目录: YOLO26改进大全:卷积层、轻量化、注意力机制、损失函数、Backbone、SPPF、Neck、检测头全方位优化汇总

专栏链接: YOLO26改进专栏
介绍

image-20251212235512548

摘要

Mona(Multi-cognitive Visual Adapter)是一种新型视觉适配器微调方法,旨在打破传统全参数微调(full fine-tuning)在视觉识别任务中的性能瓶颈。Mona 方法通过引入多认知视觉滤波器和优化输入分布,仅调整 5% 的骨干网络参数,就能在实例分割、目标检测、旋转目标检测等多个经典视觉任务中超越全参数微调的效果,显著降低了适配和存储成本,为视觉模型的高效微调提供了新的思路。

文章链接

论文地址:论文地址

代码地址:代码地址

基本原理

Mona是由清华大学、国科大、上海交大、阿里巴巴联合提出的新型视觉适配器微调方法,相关论文《5%>100%: Breaking Performance Shackles of Full Fine-Tuning on Visual Recognition Tasks》已被CVPR2025收录,其核心目标是打破传统全参数微调的性能与成本枷锁,为视觉大模型高效微调提供新方案。

一、提出背景

  1. 传统全参数微调的痛点
    • 成本极高:需更新模型全部参数,以早期BERT为例,单卡训练100万数据需5-7小时,万亿级参数模型的微调对硬件和时间要求更苛刻;
    • 存储负担重:多任务场景下需为每个任务保存完整模型副本;
    • 存在过拟合风险:大模型直接微调易因数据分布差异出现性能下降。
  2. 现有PEFT方法的局限 参数高效微调(PEFT)虽能仅调整少量参数实现模型适配,但视觉领域的多数PEFT方法性能仍落后于全参数微调,无法兼顾效率与效果。

二、核心亮点

  1. 参数效率极高:仅调整5%以内的骨干网络参数,远低于传统PEFT方法的参数改动占比,大幅降低适配和存储成本;
  2. 性能突破枷锁:在实例分割、目标检测、图像分类等多类视觉任务中,首次实现小于5%参数成本下超越全参数微调的性能;
  3. 即插即用特性:可便捷嵌入现有视觉模型架构(如Swin-Transformer),无需大规模重构模型。

三、方法架构与核心设计

1. 整体模块结构

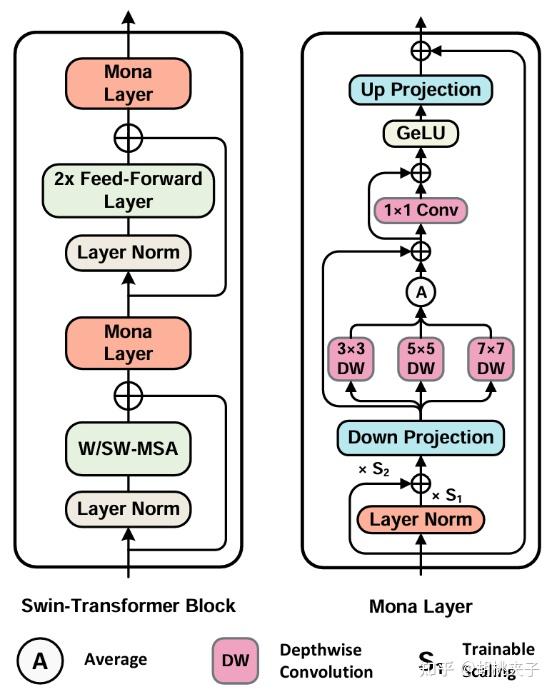
Mona的适配器模块包含降维、多认知视觉滤波器、激活函数、升维等单元,并内置跳跃连接(Skip-Connections),可无缝集成至Swin-Transformer等主流视觉骨干网络,整体流程为:输入特征经LayerNorm处理后,先降维至内部维度,再通过多认知滤波器增强特征表达,经GELU激活和dropout后升维还原,最终与原始特征残差连接输出。

2. 两大核心创新设计

  1. 多认知视觉滤波器 这是Mona的核心模块,通过深度可分离卷积多尺度卷积核(3×3、5×5、7×7)实现对二维视觉信号的精准处理,与传统线性适配器不同,其专门针对视觉任务设计,可完成多尺度特征融合,提升模型对视觉信息的理解能力,具体是将3种尺度卷积的输出均值后与原始特征残差连接,再经1×1卷积投影优化。
  2. 输入分布优化 在适配器前端加入分布适配层(Scaled LayerNorm),通过可学习参数gammagammax调整输入特征分布,使预训练特征更适配适配器的处理逻辑,提升微调效率。
img

核心代码

class Mona(BaseModule):
    def __init__(self,
                 in_dim,
                 factor=4):
        super().__init__()

        self.project1 = nn.Linear(in_dim, 64)
        self.nonlinear = F.gelu
        self.project2 = nn.Linear(64, in_dim)

        self.dropout = nn.Dropout(p=0.1)

        self.adapter_conv = MonaOp(64)

        self.norm = nn.LayerNorm(in_dim)
        self.gamma = nn.Parameter(torch.ones(in_dim) * 1e-6)
        self.gammax = nn.Parameter(torch.ones(in_dim))

    def forward(self, x, hw_shapes=None):
        identity = x

        x = self.norm(x) * self.gamma + x * self.gammax

        project1 = self.project1(x)

        b, n, c = project1.shape
        h, w = hw_shapes
        project1 = project1.reshape(b, h, w, c).permute(0, 3, 1, 2)
        project1 = self.adapter_conv(project1)
        project1 = project1.permute(0, 2, 3, 1).reshape(b, n, c)

        nonlinear = self.nonlinear(project1)
        nonlinear = self.dropout(nonlinear)
        project2 = self.project2(nonlinear)

        return identity + project2

实验

脚本

import warnings
warnings.filterwarnings('ignore')
from ultralytics import YOLO

if __name__ == '__main__':
#     修改为自己的配置文件地址
    model = YOLO('./ultralytics/cfg/models/26/yolo26-C3k2_Mona.yaml')
#     修改为自己的数据集地址
    model.train(data='./ultralytics/cfg/datasets/coco8.yaml',
                cache=False,
                imgsz=640,
                epochs=10,
                single_cls=False,  # 是否是单类别检测
                batch=8,
                close_mosaic=10,
                workers=0,
                # optimizer='MuSGD',  
                optimizer='SGD',
                amp=False,
                project='runs/train',
                name='yolo26-C3k2_Mona',
                )

结果

image-20260124110333346