





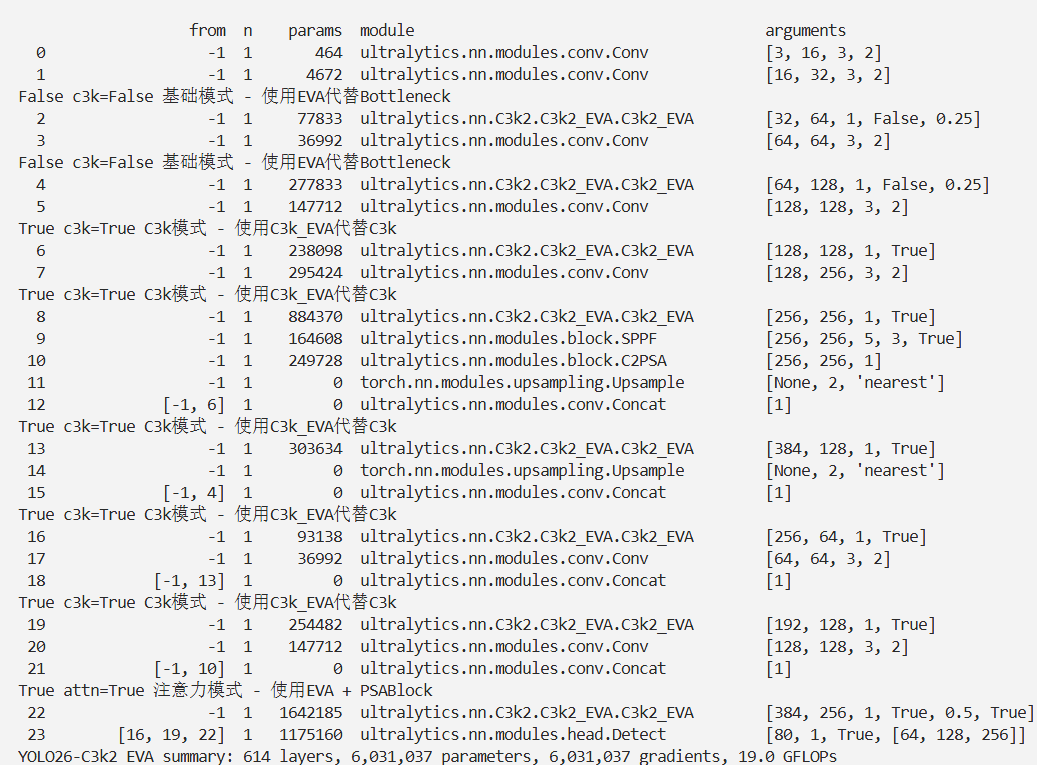
本文介绍了双边高效视觉注意力网络(BEVANet),并将其核心特征提取单元EVA集成进YOLO26。实时语义分割面临捕捉大感受野和细化精细轮廓的挑战,BEVANet通过SDLSKA、CKS、CFFN等模块解决这些问题,扩大感受野、提升性能、丰富上下文特征。我们将EVA相关代码集成到YOLO26中,创建C3k2_EVA模块,并在tasks文件中进行注册。实验证明,YOLO26-C3k2_EVA在目标检测任务中表现良好,实现了实时分割速度和较高的交并比。
文章目录: YOLO26改进大全:卷积层、轻量化、注意力机制、损失函数、Backbone、SPPF、Neck、检测头全方位优化汇总
专栏链接: YOLO26改进专栏
实时语义分割面临双重挑战:需设计高效架构,既要捕捉大感受野以实现语义理解,又要细化精细轮廓。视觉 Transformer(Vision Transformers)能有效建模长程依赖关系,但计算成本高昂。为应对这些挑战,我们提出了大核注意力(Large Kernel Attention, LKA)机制。所设计的双边高效视觉注意力网络(Bilateral Efficient Visual Attention Network, BEVANet)通过稀疏分解大分离核注意力(Sparse Decomposed Large Separable Kernel Attentions, SDLSKA)扩大感受野、捕捉上下文信息,并提取视觉与结构特征。综合核选择(Comprehensive Kernel Selection, CKS)机制可动态调整感受野,进一步提升性能。此外,深层大核金字塔池化模块(Deep Large Kernel Pyramid Pooling Module, DLKPPM)通过协同结合空洞卷积与大核注意力,丰富上下文特征。双边架构促进分支间的频繁交互,而边界引导自适应融合(Boundary Guided Adaptive Fusion, BGAF)模块在边界引导下融合空间特征与语义特征,提升边界描绘精度。BEVANet 实现了 33 帧 / 秒(FPS)的实时分割速度,无预训练时的交并比(mIoU)达 79.3%,经 ImageNet 预训练后在 Cityscapes 数据集上的 mIoU 达 81.0%,展现出最先进的性能。相关代码和模型已开源至:https://github.com/maomao0819/BEVANet。
论文地址:论文地址
代码地址:代码地址
EVA(Efficient Visual Attention Block,高效视觉注意力块)是BEVANet的核心特征提取单元,专为解决实时语义分割中“大感受野捕捉语义上下文”与“细节轮廓精炼”的矛盾而设计,同时通过结构优化控制计算成本,适配实时性需求。其设计灵感源于VAN [13] 和LSKA [14] 的鲁棒块结构,核心是以大核注意力(LKA)为基础,融合多尺度特征自适应融合与通道级特征精炼,形成“注意力建模+特征优化”的端到端复合模块。
SDLSKA(Sparse Decomposed Large Separable Kernel Attention)是EVA模块扩大感受野、降低计算成本的核心,通过“大核稀疏分解+带孔卷积复用”实现高效大核注意力。
传统大核卷积(如31×31、51×51)虽能扩大感受野,但计算量呈平方级增长;SDLSKA借鉴SLaK [12] 的稀疏分组思想和LSKA [14] 的带孔卷积优化,将单一超大核分解为“小核卷积+带孔条带卷积”,在保持等效感受野的同时降低参数复杂度。
CKS(Comprehensive Kernel Selection)是EVA模块实现多尺度特征自适应融合的关键,突破了SKNet [16]、LSKNet [15] 对“通道维度”和“空间维度”的解耦处理局限。
现有核选择机制(如SKNet)仅关注通道维度的权重分配,LSKNet虽引入空间维度,但二者是独立优化(解耦),无法捕捉通道与空间的 interdependence(相互依赖),导致多尺度融合不充分。
CKS通过“通道分支+空间分支+联合权重融合”实现动态适配,结构如图2(c)所示:
CFFN(Convolution Feed-Forward Network)是EVA模块的“特征精炼器”,承接LKA块输出的多尺度融合特征,通过通道级优化消除冗余、提升特征紧凑性。
class EVAN(nn.Module):
    """Implementation of Efficient Visual Attention Network Block."""
    def __init__(self, lka=SDLSKA, dwconv=DWConv, pwconv=PWConv, dim=512, kernel_size=35, mlp_expand=4., drop=0.,drop_path=0., act_layer=nn.GELU):
        super().__init__()
        self.norm1 = nn.BatchNorm2d(dim)
        self.attn = SpatialAttention(lka, dim, kernel_size, dwconv=dwconv, pwconv=pwconv)
        self.drop_path = DropPath(drop_path) if drop_path > 0. else nn.Identity()
        self.norm2 = nn.BatchNorm2d(dim)
        mlp_hidden_dim = int(dim * mlp_expand)
        self.mlp = MLP(in_features=dim, hidden_features=mlp_hidden_dim, act_layer=act_layer, drop=drop)
        layer_scale_init_value = 1e-2
        self.layer_scale_1 = nn.Parameter(
            layer_scale_init_value * torch.ones((dim)), requires_grad=True)
        self.layer_scale_2 = nn.Parameter(
            layer_scale_init_value * torch.ones((dim)), requires_grad=True)

        self.apply(self._init_weights)

    def _init_weights(self, m):
        if isinstance(m, nn.Linear):
            nn.init.trunc_normal_(m.weight, std=.02)
            if m.bias is not None:
                nn.init.constant_(m.bias, 0)
        elif isinstance(m, nn.LayerNorm):
            nn.init.constant_(m.bias, 0)
            nn.init.constant_(m.weight, 1.0)
        elif isinstance(m, nn.Conv2d):
            fan_out = m.kernel_size[0] * m.kernel_size[1] * m.out_channels
            fan_out //= m.groups
            nn.init.normal_(m.weight, 0, math.sqrt(2.0 / fan_out))
            if m.bias is not None:
                nn.init.constant_(m.bias, 0)

    def forward(self, x):
        x = x + self.drop_path(self.layer_scale_1.unsqueeze(-1).unsqueeze(-1) * self.attn(self.norm1(x)))
        x = x + self.drop_path(self.layer_scale_2.unsqueeze(-1).unsqueeze(-1) * self.mlp(self.norm2(x)))
return ximport warnings
warnings.filterwarnings('ignore')
from ultralytics import YOLO
if __name__ == '__main__':
# 修改为自己的配置文件地址
model = YOLO('./ultralytics/cfg/models/26/yolo26-C3k2_EVA.yaml')
# 修改为自己的数据集地址
model.train(data='./ultralytics/cfg/datasets/coco8.yaml',
cache=False,
imgsz=640,
epochs=10,
single_cls=False, # 是否是单类别检测
batch=8,
close_mosaic=10,
workers=0,
optimizer='MuSGD',
# optimizer='SGD',
amp=False,
project='runs/train',
name='yolo26-C3k2_EVA',
)
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。