





惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

WordPress大学
WordPress大学
H
Help Net Security
Jina AI
Jina AI
V
V2EX
G
Google Developers Blog
B
Blog
GbyAI
GbyAI
U
Unit 42
爱范儿
爱范儿
腾讯CDC
Engineering at Meta
Engineering at Meta
酷 壳 – CoolShell
酷 壳 – CoolShell
博客园 - 三生石上(FineUI控件)
宝玉的分享
宝玉的分享
小众软件
小众软件
D
DataBreaches.Net
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
博客园 - Franky
博客园 - 聂微东
The Cloudflare Blog
I
InfoQ
Microsoft Azure Blog
Hugging Face - Blog
Hugging Face - Blog
大猫的无限游戏
大猫的无限游戏

秋码分享

我是如何解决将 c++ 编译成可以在 node.js 中使用的 *.node,中间出现的一大堆问题的(指纹浏览器基石篇) eSIM Plus 爱沙尼亚手机号彻底翻车?“永久有效”悄然变成了一年! 接码平台 SMS-Activate 余额可以转移到新平台使用,截止日期:2026年1月29日 是时候将 hugo-theme-kiwi 主题提交到 themes.gohugo.io 站点上了 Flux2 刚开源就凉了?Z-Image 本地部署狠狠打了个样 声音的未来:Chatterbox —— 用「夸张度旋钮」提升表现力的开源 TTS 向导 还以为那只是换个背景?Qwen-Image-Edit 在 ComfyUI 中能做到更离谱的事 Windows 结合最新版 ComfyUI 部署阿里最新开源的 Qwen-Image 图像大模型 从零样本到跨场景:Seed-VC语音转换技术的革命性突破 大语音模型轻量化革命:MegaTTS3 如何重新定义文本生成语音的技术边界(windows篇) 竞赛级编程大模型OlympicCoder-7B之本地部署(Windows篇) 阿里开源了端到端全模态大模型Qwen-2.5-Omini-7B之本地部署(windows篇) 语音识别之whisper本地部署(实时语音之开篇) 甭管是个人还是企业都能部署的Mistral-Small3.1,远超同级别的模型 文生音乐开源项目DiffRhythm,8G显存本地部署之Windows篇 阿里QwQ-32B本地部署指南:用Ollama轻松运行320亿参数大模型 基于Qwen2.5大模型的Spark-TTS,零样本语音克隆,CPU可运行之本地部署(Windows篇) 智谱开源了文生图CogView4-6B模型,支持中文提示词之本地部署(Windows篇) 基于歌词生成整首歌的开源AI音乐模型,支持中、英、日、韩等多种语言,本地化部署YuE(windows篇) 阿里云开源的文生视频万相 Wan2.1之本地部署Wan2.1-T2V-1.3B模型 互动式开源AI图像编辑神器,Windows11本地部署 MagicQuill 本地部署Qwen2.5-VL-7B-Instruct多模态视觉大模型(Windows篇) 保持角色一致性的绘本生成AI开源项目之Story-Adapter本地部署Windows篇 本地部署 Stable Diffusion 3.5(最新 ComfyUI记录篇) 谁说Win7安装不了Node.js最新版的呢?都2025年,还不更新系统到Win11 vs code远程调试Linux服务器上的php代码 浏览器定制 | Windows11 编译 Chromium 133.0.6885.0(截稿前Chromium最新版之编译篇[一]) 不说是彻底搞懂,至少让你不再惧怕c/c++指针,以及各种奇葩指针变种 解决windows下php8.x及以上版本,在Apache2.4中无法加载CURL扩展的问题 在 Windows8.1 下编译 Chromium (103.0.5060.68 之三)
精确率(召回率)的权衡(Machine Learning 研习十六)
一个游离于山间之上的江湖漫行者。A jungle wanderer who wanders above the mountain · 2024-03-21 · via 秋码分享

精确率(召回率)的权衡

为了理解这种权衡,让我们看看 SGDClassifier 如何做出分类决策。 对于每个实例,它根据决策函数计算分数。 如果该分数大于阈值,则将该实例分配给正类; 否则它会将其分配给负类。 图 3-4 显示了从左侧最低分数到右侧最高分数的几个数字。 假设决策阈值位于中心箭头(两个 5 之间):您会在该阈值右侧发现 4 个真阳性(实际为 5),以及 1 个假阳性(实际上为 6)。 因此,使用该阈值,精度为 80%(5 分之 4)。 但在 6 个实际的 5 中,分类器仅检测到 4 个,因此召回率为 67%(6 中的 4)。 如果提高阈值(将其移动到右侧的箭头),假阳性(6)会变成真阴性,从而提高精度(在本例中高达 100%),但一个真阳性会变成假阴性 ,将召回率降低至 50%。 相反,降低阈值会增加召回率并降低精确度。
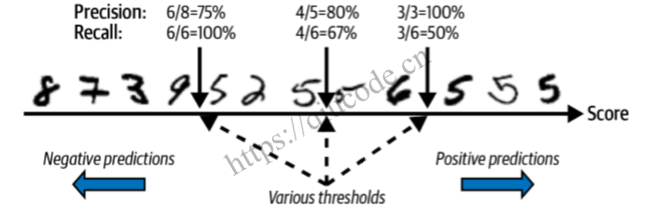
Scikit-Learn 不允许您直接设置阈值,但它允许您访问它用于进行预测的决策分数。 您可以调用其decision_function()方法,而不是调用分类器的predict()方法,该方法返回每个实例的分数,然后使用您想要根据这些分数进行预测的任何阈值:

image-20240321183321905

SGDClassifier 使用等于 0 的阈值,因此前面的代码返回与 Predict() 方法相同的结果(即 True)。 让我们提高门槛:

image-20240321183456796

这证实了提高阈值会降低召回率。 该图像实际上代表的是 5,当阈值为 0 时分类器会检测到它,但当阈值增加到 3,000 时分类器会错过它。

y_scores = cross_val_predict(sgd_clf, X_train, y_train_5, cv=3,              method="decision_function")

有了这些分数,使用 precision_recall_curve() 函数计算所有可能阈值的精度和召回率(该函数添加最后精度 0 和最后召回率 1,对应于无限阈值):

from sklearn.metrics import precision_recall_curve

precisions, recalls, thresholds = precision_recall_curve(y_train_5, y_scores) 

最后,使用 Matplotlib 将精度和召回率绘制为阈值的函数(见下图)。 让我们展示一下我们选择的阈值 3,000:

plt.plot(thresholds, precisions[:-1], "b--", label="Precision", linewidth=2) plt.plot(thresholds, recalls[:-1], "g-", label="Recall", linewidth=2) plt.vlines(threshold, 0, 1.0, "k", "dotted", label="threshold") [...]  # beautify the figure: add grid, legend, axis, labels, and circles plt.show()
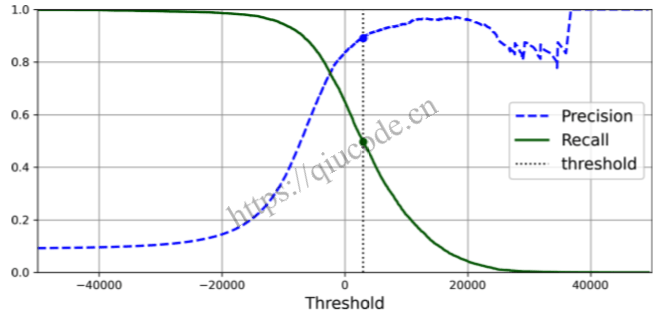
image-20240321192040743

在此阈值下,准确率接近 90%,召回率约为 50%。 选择良好的精度/召回率权衡的另一种方法是直接针对召回率绘制精度图,如图 3-6 所示(显示了相同的阈值):

plt.plot(recalls, precisions, linewidth=2, label="Precision/Recall curve") [...]  # beautify the figure: add labels, grid, legend, arrow, and text plt.show()
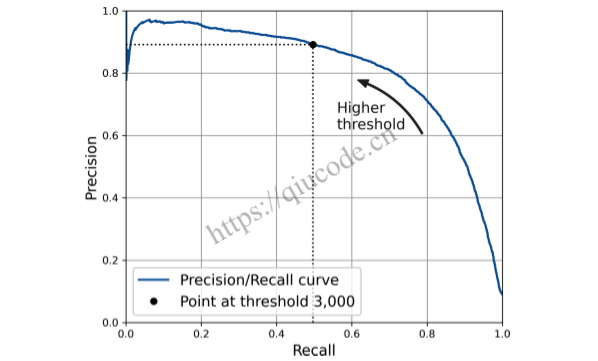
image-20240321192423371

您可以看到,当召回率达到 80% 左右时,准确率确实开始急剧下降。 您可能希望在该下降之前选择精确率/召回率权衡,例如,召回率约为 60%。 但当然,选择取决于您的项目。

假设您决定以 90% 的精度为目标。 您可以使用第一个图来找到需要使用的阈值,但这不是很精确。 或者,您可以搜索可提供至少 90% 精度的最低阈值。 为此,您可以使用 NumPy 数组的 argmax() 方法。 这将返回最大值的第一个索引,在本例中意味着第一个 True 值:

image-20240321192622923

要进行预测(目前在训练集上),您可以运行以下代码,而不是调用分类器的 Predict() 方法:

y_train_pred_90 = (y_scores >= threshold_for_90_precision)

让我们检查这些预测的精确度和召回率:
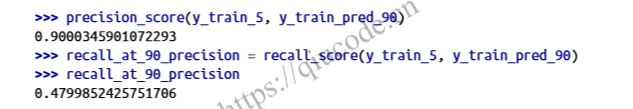
image-20240321193044481

太棒了,你有一个 90% 精度的分类器! 正如您所看到的,创建具有几乎任何您想要的精度的分类器相当容易:只需设置足够高的阈值,就可以了。 但是等等,不要这么快——如果召回率太低,高精度分类器就不是很有用! 对于许多应用程序来说,48% 的召回率根本就不够好。