惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

让小产品的独立变现更简单 - ezindie.com
MyScale Blog
MyScale Blog
U
Unit 42
M
MIT News - Artificial intelligence
小众软件
小众软件
P
Proofpoint News Feed
雷峰网
雷峰网
L
LangChain Blog
S
SegmentFault 最新的问题
腾讯CDC
F
Fortinet All Blogs
A
About on SuperTechFans
WordPress大学
WordPress大学
Vercel News
Vercel News
奇客Solidot–传递最新科技情报
奇客Solidot–传递最新科技情报
G
Google Developers Blog
大猫的无限游戏
大猫的无限游戏
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
D
Docker
N
Netflix TechBlog - Medium
Apple Machine Learning Research
Recent Announcements
D
DataBreaches.Net
Stack Overflow Blog
Stack Overflow Blog

秋码分享

我是如何解决将 c++ 编译成可以在 node.js 中使用的 *.node,中间出现的一大堆问题的(指纹浏览器基石篇) eSIM Plus 爱沙尼亚手机号彻底翻车?“永久有效”悄然变成了一年! 接码平台 SMS-Activate 余额可以转移到新平台使用,截止日期:2026年1月29日 是时候将 hugo-theme-kiwi 主题提交到 themes.gohugo.io 站点上了 Flux2 刚开源就凉了?Z-Image 本地部署狠狠打了个样 声音的未来:Chatterbox —— 用「夸张度旋钮」提升表现力的开源 TTS 向导 还以为那只是换个背景?Qwen-Image-Edit 在 ComfyUI 中能做到更离谱的事 Windows 结合最新版 ComfyUI 部署阿里最新开源的 Qwen-Image 图像大模型 从零样本到跨场景:Seed-VC语音转换技术的革命性突破 大语音模型轻量化革命:MegaTTS3 如何重新定义文本生成语音的技术边界(windows篇) 竞赛级编程大模型OlympicCoder-7B之本地部署(Windows篇) 阿里开源了端到端全模态大模型Qwen-2.5-Omini-7B之本地部署(windows篇) 甭管是个人还是企业都能部署的Mistral-Small3.1,远超同级别的模型 文生音乐开源项目DiffRhythm,8G显存本地部署之Windows篇 阿里QwQ-32B本地部署指南:用Ollama轻松运行320亿参数大模型 基于Qwen2.5大模型的Spark-TTS,零样本语音克隆,CPU可运行之本地部署(Windows篇) 智谱开源了文生图CogView4-6B模型,支持中文提示词之本地部署(Windows篇) 基于歌词生成整首歌的开源AI音乐模型,支持中、英、日、韩等多种语言,本地化部署YuE(windows篇) 阿里云开源的文生视频万相 Wan2.1之本地部署Wan2.1-T2V-1.3B模型 互动式开源AI图像编辑神器,Windows11本地部署 MagicQuill 本地部署Qwen2.5-VL-7B-Instruct多模态视觉大模型(Windows篇) 保持角色一致性的绘本生成AI开源项目之Story-Adapter本地部署Windows篇 本地部署 Stable Diffusion 3.5(最新 ComfyUI记录篇) 谁说Win7安装不了Node.js最新版的呢?都2025年,还不更新系统到Win11 vs code远程调试Linux服务器上的php代码 浏览器定制 | Windows11 编译 Chromium 133.0.6885.0(截稿前Chromium最新版之编译篇[一]) 不说是彻底搞懂,至少让你不再惧怕c/c++指针,以及各种奇葩指针变种 解决windows下php8.x及以上版本,在Apache2.4中无法加载CURL扩展的问题 在 Windows8.1 下编译 Chromium (103.0.5060.68 之三) 安装 depot_tools 和 Windows 10 SDK 为在Windows下构建基于 chromium 的浏览器(103.0.5060.68 之二)
语音识别之whisper本地部署(实时语音之开篇)
一个游离于山间之上的江湖漫行者。A jungle wanderer who wanders above the mountain · 2025-03-25 · via 秋码分享

Whisper是由OpenAI开发的开源语音识别模型,以其多语言支持、高准确率与鲁棒性著称。它通过68万小时的多语言、多任务数据训练,覆盖100+语言,支持语音转录、翻译和语言检测,成为目前最通用的语音识别工具之一。

其核心优势在于:

  1. 端到端训练:直接处理原始音频输入,无需复杂预处理,输出包含标点符号的完整文本。
  2. 噪声鲁棒性:在嘈杂环境、方言口音场景下仍能保持高精度。
  3. 多任务能力:支持语音翻译(如中文转英文)、时间戳标注等复杂任务。

本地安装

我始终使用python3自带的venv来搭建python虚拟环境,当然咯,你也是可以使用anacondaminiconda来构建python虚拟环境

python -m venv whisper-env
cd whisper-env/Scripts
activate
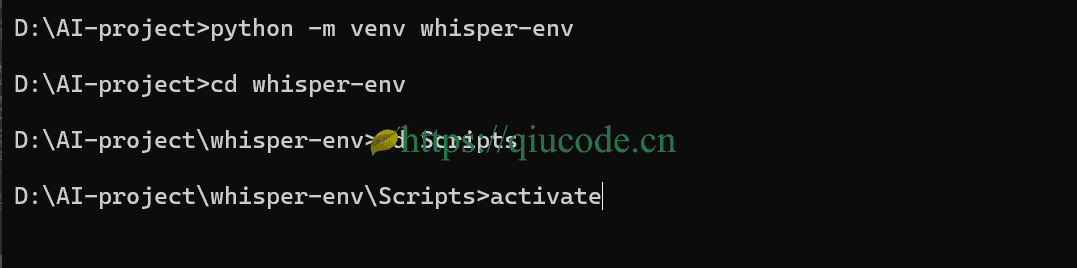
image-20250321204203207

随后,我们安装openai-whisper这个依赖库。

pip install -U openai-whisper

或者直接从github.com仓库获取最新的。

# 或从 GitHub 安装最新版本
pip install git+https://github.com/openai/whisper.git
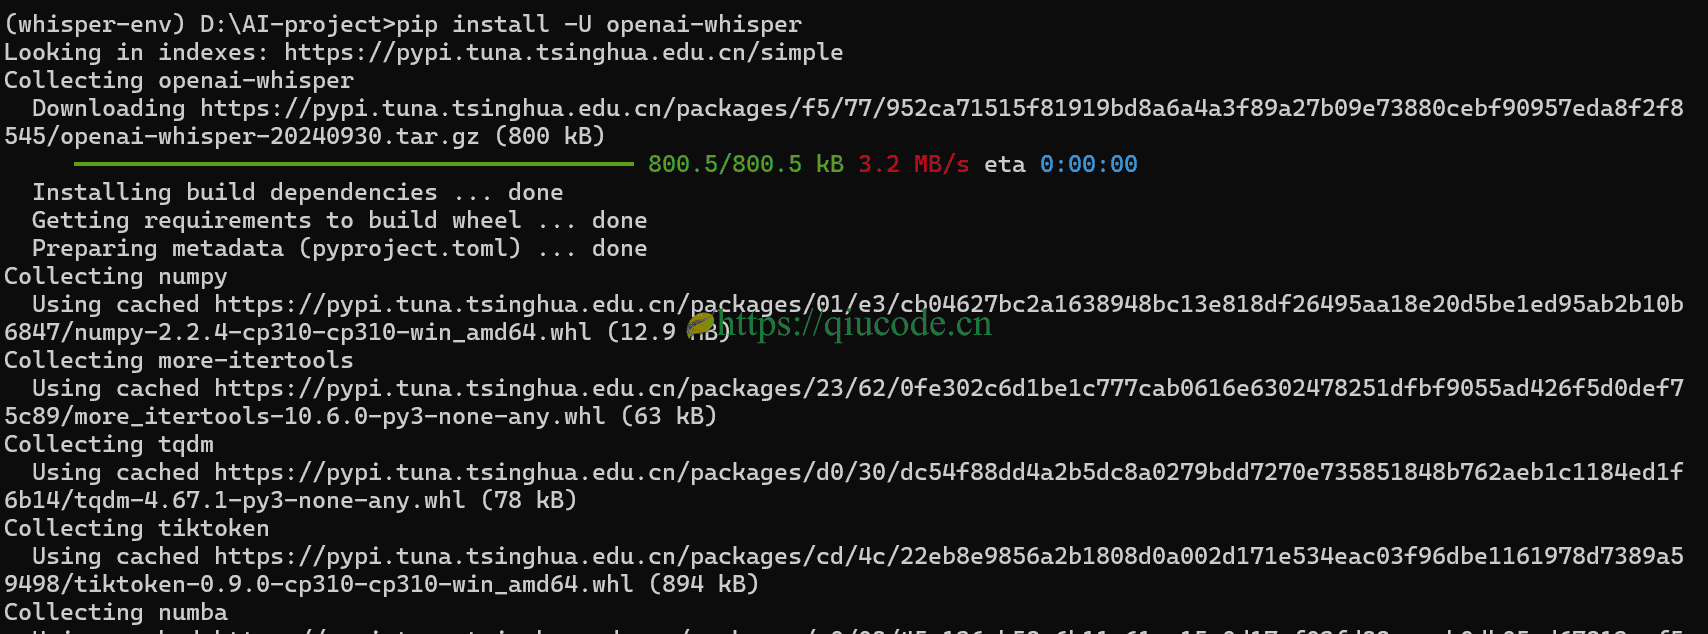
image-20250321204501207

我们可以看到,所安装的依赖库中包含了tiktoken,故而,就不需要在安装了。
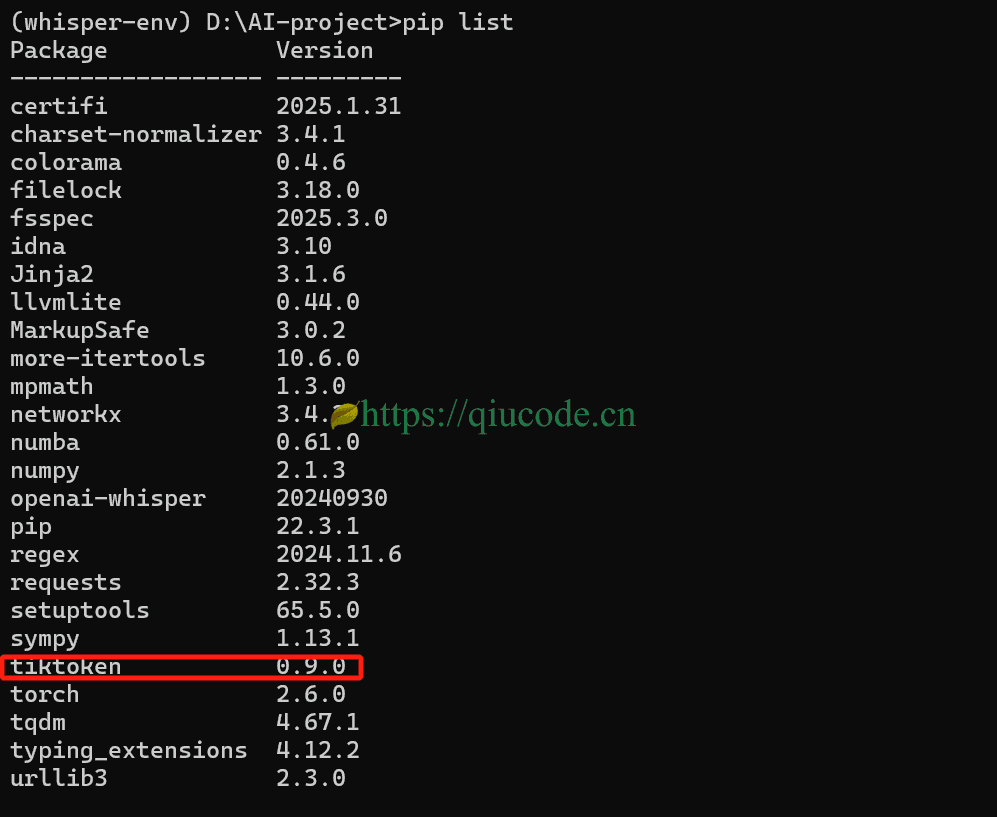
image-20250321205101186

虽然,whisper是可以通过CPU来推理的,但是在电脑设备具有GPU的情况,还是选择torchCUDA版本。

pip uninstall torch
pip install torch --index-url https://download.pytorch.org/whl/cu124
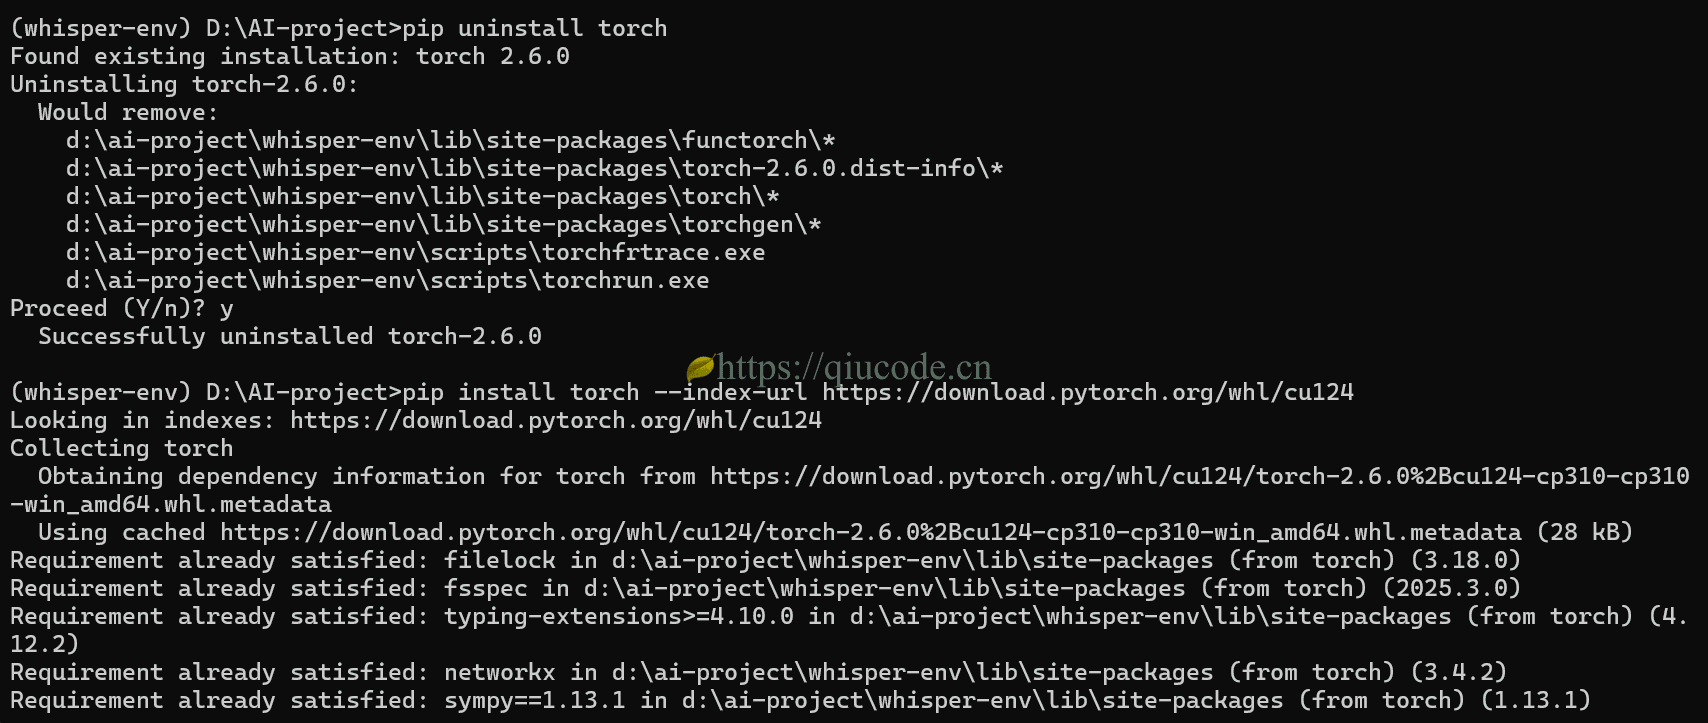
image-20250321205410277

之后,新建一个demo.py文件,写入以下脚本。

import whisper

model = whisper.load_model("turbo")
result = model.transcribe("audio.wav")
print(result["text"])
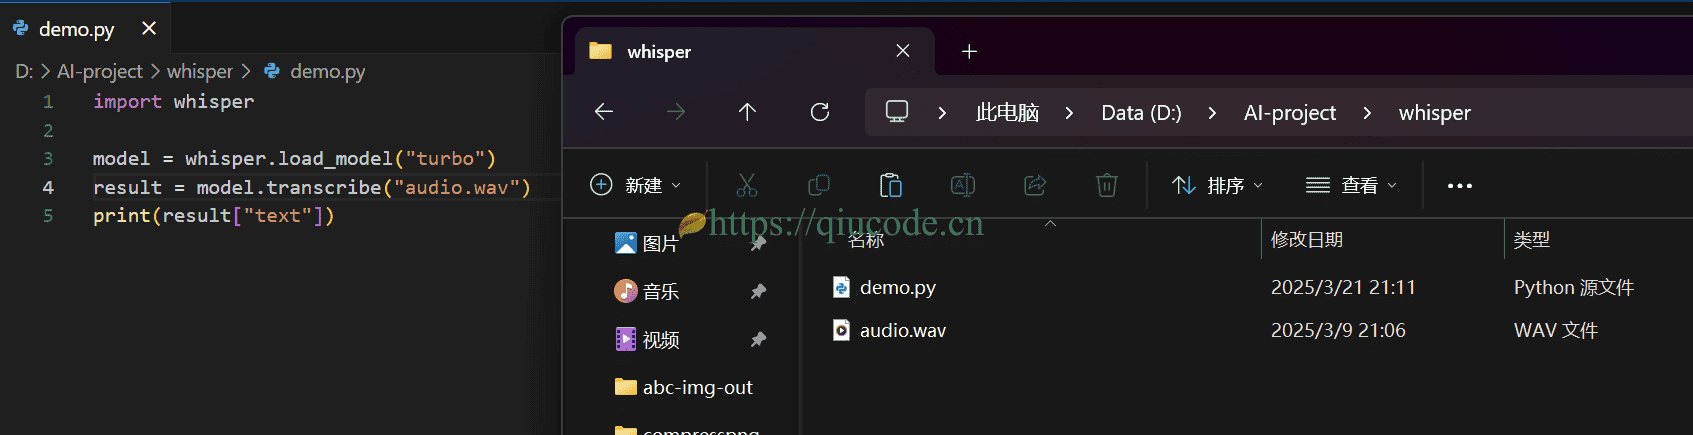
image-20250321211330620

首次运行,会去下载模型,而我使用的是turbo,所以自动下载的便是large-v3-turbo

image-20250325214258337

如果自动下载失败了,那么就手动下载吧。

模型默认加载路径:C:\Users\你电脑的用户名\.cache\whisper

https://www.modelscope.cn/models/iic/Whisper-large-v3-turbo/files
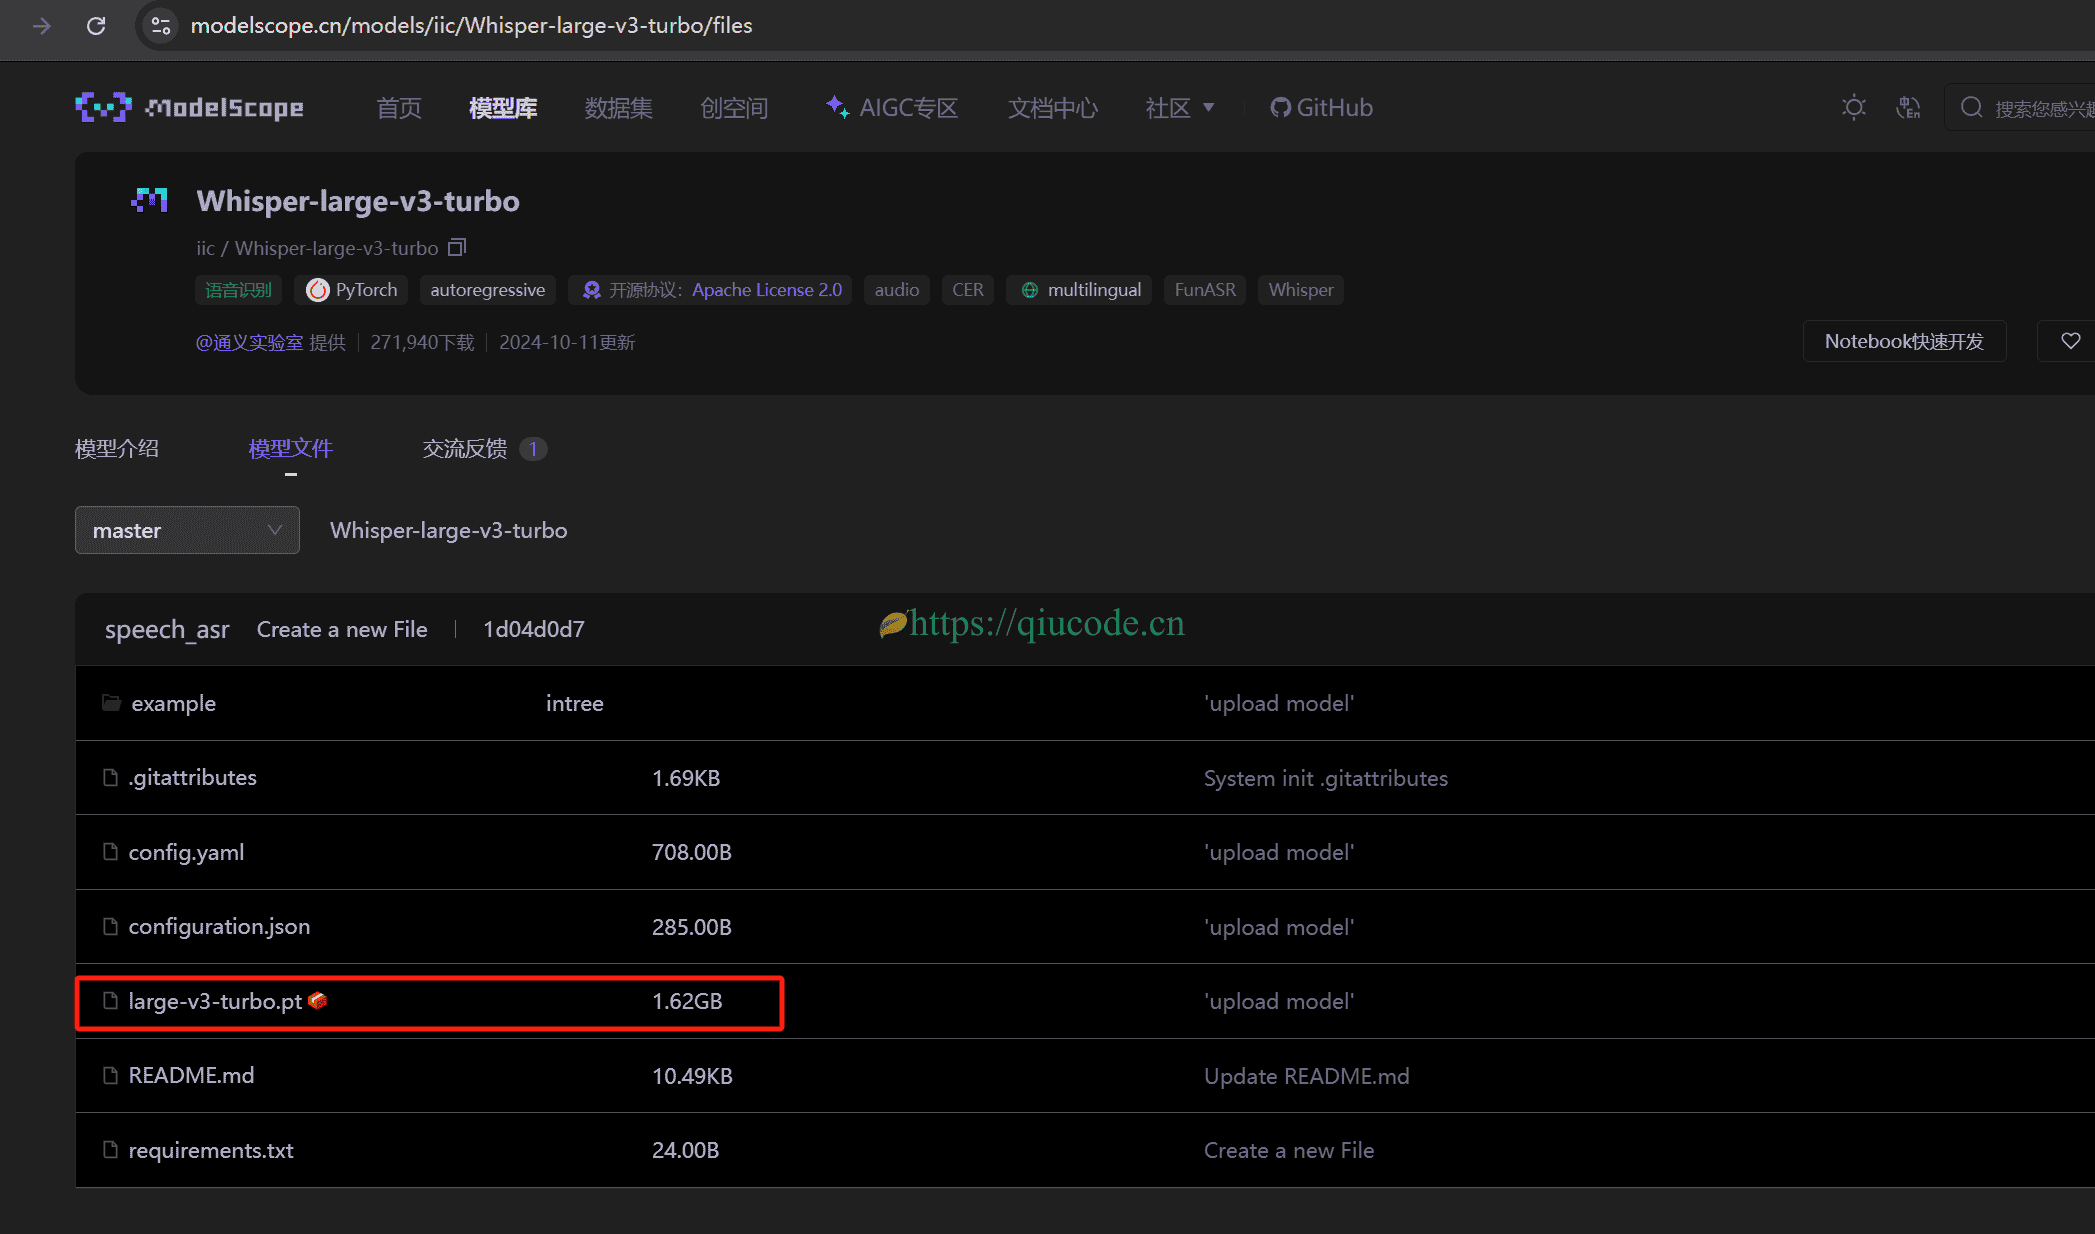
image-20250325214410476