惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

Apple Machine Learning Research
博客园 - 三生石上(FineUI控件)
雷峰网
雷峰网
WordPress大学
WordPress大学
S
SegmentFault 最新的问题
博客园 - 叶小钗
The Cloudflare Blog
T
Tailwind CSS Blog
Hugging Face - Blog
Hugging Face - Blog
让小产品的独立变现更简单 - ezindie.com
freeCodeCamp Programming Tutorials: Python, JavaScript, Git & More
月光博客
月光博客
小众软件
小众软件
罗磊的独立博客
酷 壳 – CoolShell
酷 壳 – CoolShell
大猫的无限游戏
大猫的无限游戏
阮一峰的网络日志
阮一峰的网络日志
V
V2EX
美团技术团队
钛媒体:引领未来商业与生活新知
钛媒体:引领未来商业与生活新知
博客园 - 聂微东
量子位
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
宝玉的分享
宝玉的分享

秋码分享

我是如何解决将 c++ 编译成可以在 node.js 中使用的 *.node,中间出现的一大堆问题的(指纹浏览器基石篇) eSIM Plus 爱沙尼亚手机号彻底翻车?“永久有效”悄然变成了一年! 接码平台 SMS-Activate 余额可以转移到新平台使用,截止日期:2026年1月29日 是时候将 hugo-theme-kiwi 主题提交到 themes.gohugo.io 站点上了 Flux2 刚开源就凉了?Z-Image 本地部署狠狠打了个样 声音的未来:Chatterbox —— 用「夸张度旋钮」提升表现力的开源 TTS 向导 还以为那只是换个背景?Qwen-Image-Edit 在 ComfyUI 中能做到更离谱的事 Windows 结合最新版 ComfyUI 部署阿里最新开源的 Qwen-Image 图像大模型 从零样本到跨场景:Seed-VC语音转换技术的革命性突破 大语音模型轻量化革命:MegaTTS3 如何重新定义文本生成语音的技术边界(windows篇) 竞赛级编程大模型OlympicCoder-7B之本地部署(Windows篇) 阿里开源了端到端全模态大模型Qwen-2.5-Omini-7B之本地部署(windows篇) 语音识别之whisper本地部署(实时语音之开篇) 甭管是个人还是企业都能部署的Mistral-Small3.1,远超同级别的模型 文生音乐开源项目DiffRhythm,8G显存本地部署之Windows篇 阿里QwQ-32B本地部署指南:用Ollama轻松运行320亿参数大模型 基于Qwen2.5大模型的Spark-TTS,零样本语音克隆,CPU可运行之本地部署(Windows篇) 智谱开源了文生图CogView4-6B模型,支持中文提示词之本地部署(Windows篇) 基于歌词生成整首歌的开源AI音乐模型,支持中、英、日、韩等多种语言,本地化部署YuE(windows篇) 阿里云开源的文生视频万相 Wan2.1之本地部署Wan2.1-T2V-1.3B模型 互动式开源AI图像编辑神器,Windows11本地部署 MagicQuill 本地部署Qwen2.5-VL-7B-Instruct多模态视觉大模型(Windows篇) 保持角色一致性的绘本生成AI开源项目之Story-Adapter本地部署Windows篇 本地部署 Stable Diffusion 3.5(最新 ComfyUI记录篇) 谁说Win7安装不了Node.js最新版的呢?都2025年,还不更新系统到Win11 vs code远程调试Linux服务器上的php代码 浏览器定制 | Windows11 编译 Chromium 133.0.6885.0(截稿前Chromium最新版之编译篇[一]) 不说是彻底搞懂,至少让你不再惧怕c/c++指针,以及各种奇葩指针变种 解决windows下php8.x及以上版本,在Apache2.4中无法加载CURL扩展的问题 在 Windows8.1 下编译 Chromium (103.0.5060.68 之三)
多类别分类器(Machine Learning 研习十八)
一个游离于山间之上的江湖漫行者。A jungle wanderer who wanders above the mountain · 2024-04-03 · via 秋码分享

多类别分类器

二元分类器可以区分两个类别,而多类别分类器(也称为多叉分类器)可以区分两个以上的类别。

一些 Scikit-Learn 分类器(如 LogisticRegressionRandomForestClassifier GaussianNB)能够原生处理多个类别。其他分类器则是严格的二进制分类器(如 SGDClassifierSVC)。不过,您可以使用多种策略来使用多个二进制分类器执行多类分类。

要创建一个能将数字图像分为 10 类(从 0 到 9)的系统,一种方法是训练 10 个二进制分类器,每个数字一个(0-检测器、1-检测器、2-检测器,以此类推)。然后,当您想对一幅图像进行分类时,您可以从每个分类器中得到该图像的判定分数,然后选择分类器输出分数最高的类别。这就是所谓的 “以一敌百”(OvR)策略,有时也称为 “以一敌众”(OvA)策略。

另一种策略是为每一对数字训练一个二元分类器:一个用于区分 0 和 1,另一个用于区分 0 和 2,还有一个用于区分 1 和 2,以此类推。这就是所谓的一对一(OvO)策略。如果有 N 个类别,则需要训练 N × (N - 1) / 2 个分类器。对于 MNIST 问题,这意味着要训练 45 个二进制分类器!当你想对一幅图像进行分类时,你必须让图像通过所有 45 个分类器,看看哪个分类器赢得了最多的对决。OvO 的主要优势在于,每个分类器只需在训练集中包含其必须区分的两个类别的部分进行训练。

有些算法(如支持向量机分类器)随训练集的大小而缩放,效果不佳。对于这些算法,OvO 是首选,因为在小训练集上训练多个分类器比在大训练集上训练少数分类器更快。不过,对于大多数二元分类算法来说,OvR 是首选。

Scikit-Learn 会检测你是否尝试在多分类任务中使用二元分类算法,并根据算法自动运行 OvROvO。让我们使用 sklearn.svm.SVC 类支持向量机分类器来尝试一下。我们只对前 2,000 张图像进行训练,否则会耗费很长时间:

from sklearn.svm import SVC

svm_clf = SVC(random_state=42) svm_clf.fit(X_train[:2000], y_train[:2000])  # y_train, not y_train_5

我们使用从 0 到 9 的原始目标类别(y_train),而不是 5 对其余目标类别(y_train_5)来训练 SVC。由于有 10 个类别(即多于 2 个),Scikit-Learn 使用 OvO 策略训练了 45 个二元分类器。现在,让我们对一幅图像进行预测:
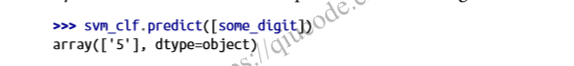
image-20240403151324143

赢得决斗的次数加上或减去一个小调整(最大 ±0.33)以打破平局:没错!这段代码实际上进行了 45 次预测,每对班级一次,并选择了赢得决斗最多的班级。如果你调用 decision_function() 方法,就会看到它为每个实例返回 10 个分数:每个班级一个。根据分类器的得分,每个类得到的分数等于

image-20240403151515505

得分最高的是 9.3 分,确实是 5 级:

image-20240403151626521

训练分类器时,分类器会在 classes_ attribute中存储目标类列表,并按值排序。在 MNIST 的情况下,classes_ array 中每个类的索引很容易与类本身相匹配(例如,索引为 5 的类恰好是 “5 “类),但在一般情况下,你就没那么幸运了;你需要像这样查找类标签:

image-20240403151854514

如果您想强制 Scikit-Learn 使用一对一或一对多,可以使用 OneVsOneClassifier 或 OneVsRestClassifier 类。只需创建一个实例,并向其构造函数传递一个分类器(甚至不必是二进制分类器)。例如,这段代码使用 OvR 策略创建了一个基于 SVC 的多分类器:

from sklearn.multiclass import OneVsRestClassifier

ovr_clf = OneVsRestClassifier(SVC(random_state=42)) ovr_clf.fit(X_train[:2000], y_train[:2000]) 

让我们进行一次预测,并检查已训练分类器的数量:
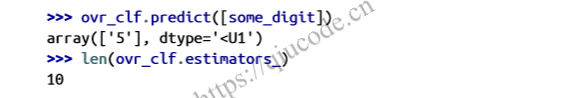
image-20240403152207505

在多类数据集上训练 SGDClassifier 并用它进行预测也同样简单:
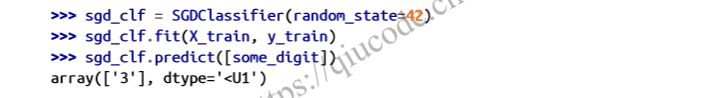
image-20240403152310056

预测错误确实会发生!这次,Scikit-Learn 在引擎盖下使用了 OvR 策略:因为有 10 个类别,所以它训练了 10 个二元分类器。现在,decision_function() 方法会为每个类别返回一个值。让我们看看 SGD 分类器为每个类别分配的分数:

image-20240403152423407

可以看出,分类器对自己的预测不是很有信心:几乎所有的分数都非常负面,而第 3 类的分数为 +1,824 分,第 5 类也不差,为 -1,386 分。当然,你需要在不止一幅图像上对这个分类器进行评估。由于每个类别中的图片数量大致相同,因此准确度指标也没有问题。像往常一样,你可以使用 cross_val_score() 函数来评估模型:

image-20240403152531168

它在所有测试折叠中的准确率超过 85.8%。如果使用随机分类器,准确率会达到 10%,所以这个成绩还不算太差,但还可以做得更好。只需缩放输入(如第 2 章所述),准确率就能提高到 89.1%以上:
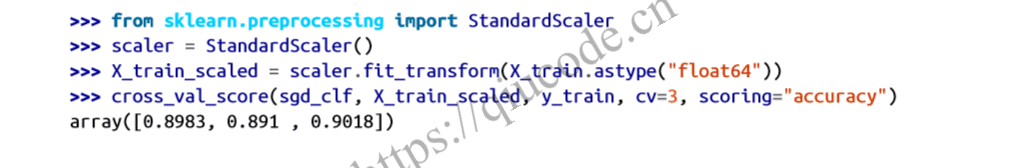
image-20240403152658895