惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

博客园 - 三生石上(FineUI控件)
WordPress大学
WordPress大学
S
SegmentFault 最新的问题
小众软件
小众软件
T
Tailwind CSS Blog
博客园 - 聂微东
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
人人都是产品经理
人人都是产品经理
V
Visual Studio Blog
罗磊的独立博客
有赞技术团队
有赞技术团队
奇客Solidot–传递最新科技情报
奇客Solidot–传递最新科技情报
让小产品的独立变现更简单 - ezindie.com
Jina AI
Jina AI
量子位
云风的 BLOG
云风的 BLOG
Recent Announcements
Hugging Face - Blog
Hugging Face - Blog
P
Proofpoint News Feed
N
Netflix TechBlog - Medium
GbyAI
GbyAI
钛媒体:引领未来商业与生活新知
钛媒体:引领未来商业与生活新知
腾讯CDC
美团技术团队

秋码分享

我是如何解决将 c++ 编译成可以在 node.js 中使用的 *.node,中间出现的一大堆问题的(指纹浏览器基石篇) eSIM Plus 爱沙尼亚手机号彻底翻车?“永久有效”悄然变成了一年! 接码平台 SMS-Activate 余额可以转移到新平台使用,截止日期:2026年1月29日 是时候将 hugo-theme-kiwi 主题提交到 themes.gohugo.io 站点上了 Flux2 刚开源就凉了?Z-Image 本地部署狠狠打了个样 声音的未来:Chatterbox —— 用「夸张度旋钮」提升表现力的开源 TTS 向导 还以为那只是换个背景?Qwen-Image-Edit 在 ComfyUI 中能做到更离谱的事 Windows 结合最新版 ComfyUI 部署阿里最新开源的 Qwen-Image 图像大模型 从零样本到跨场景:Seed-VC语音转换技术的革命性突破 大语音模型轻量化革命:MegaTTS3 如何重新定义文本生成语音的技术边界(windows篇) 竞赛级编程大模型OlympicCoder-7B之本地部署(Windows篇) 阿里开源了端到端全模态大模型Qwen-2.5-Omini-7B之本地部署(windows篇) 语音识别之whisper本地部署(实时语音之开篇) 甭管是个人还是企业都能部署的Mistral-Small3.1,远超同级别的模型 文生音乐开源项目DiffRhythm,8G显存本地部署之Windows篇 阿里QwQ-32B本地部署指南:用Ollama轻松运行320亿参数大模型 基于Qwen2.5大模型的Spark-TTS,零样本语音克隆,CPU可运行之本地部署(Windows篇) 智谱开源了文生图CogView4-6B模型,支持中文提示词之本地部署(Windows篇) 阿里云开源的文生视频万相 Wan2.1之本地部署Wan2.1-T2V-1.3B模型 互动式开源AI图像编辑神器,Windows11本地部署 MagicQuill 本地部署Qwen2.5-VL-7B-Instruct多模态视觉大模型(Windows篇) 保持角色一致性的绘本生成AI开源项目之Story-Adapter本地部署Windows篇 本地部署 Stable Diffusion 3.5(最新 ComfyUI记录篇) 谁说Win7安装不了Node.js最新版的呢?都2025年,还不更新系统到Win11 vs code远程调试Linux服务器上的php代码 浏览器定制 | Windows11 编译 Chromium 133.0.6885.0(截稿前Chromium最新版之编译篇[一]) 不说是彻底搞懂,至少让你不再惧怕c/c++指针,以及各种奇葩指针变种 解决windows下php8.x及以上版本,在Apache2.4中无法加载CURL扩展的问题 在 Windows8.1 下编译 Chromium (103.0.5060.68 之三) 安装 depot_tools 和 Windows 10 SDK 为在Windows下构建基于 chromium 的浏览器(103.0.5060.68 之二)
基于歌词生成整首歌的开源AI音乐模型,支持中、英、日、韩等...
一个游离于山间之上的江湖漫行者。A jungle wanderer who wanders above the mountain · 2025-03-05 · via 秋码分享

说起文生音乐,我们自然会想到suno.ai这个音乐生成式平台,它算是目前市面上音乐生成式比较好的AI项目,虽然它是闭源的。

然而,一款由Multimodal Art Projection(M-A-P)(多模态艺术投影)团队与香港科技大学(HKUST)联合研发的YuE开源了,它是根据歌词生成整首歌的开源AI音乐模型。

YuE的开源,着实在开发者社区掀起了一阵热潮,但也给了AI浪潮中的文生音乐助推了不小波澜。

YuE 是一系列开创性的开源基础模型,专为音乐生成而设计,专门用于将歌词转换成完整的歌曲(lyrics2song)。它可以生成一首完整的歌曲,持续几分钟,包括朗朗上口的声乐曲目和伴奏曲目。YuE 能够模拟多种流派/语言/声乐技巧。请访问演示页面,了解令人惊叹的声乐表演。

概述

YuE项目地址:https://github.com/multimodal-art-projection/YuE

按照官方描述:

YuE 需要大量 GPU 来生成长序列。以下是推荐的配置:

对于具有 24GB 或更少的 GPU:运行最多 2 个会话以避免内存不足 (OOM) 错误。

对于完整的歌曲生成(许多会话,例如 4 个或更多):使用具有至少 80GBGPU。即 H800A100 或具有张量并行的多个 RTX4090

要自定义会话数,界面允许您指定所需的会话数。默认情况下,模型运行 2 个会话(1 节 + 1 合唱)以避免 OOM 问题。

H800 GPU 上,生成 30 秒的音频需要 150 秒。在 RTX 4090 GPU 上,生成 30 秒的音频大约需要 360 秒。

社区提供了对于 GPU 资源有限的人,有 YuE-exllamav2YuEGP。虽然两者都提高了生成速度和连贯性,但它们可能会损害音乐性。

YuEGP github地址:https://github.com/deepbeepmeep/YuEGP

YuE-exllamav2 github地址: https://github.com/sgsdxzy/YuE-exllamav2

本地部署 YuEGP

我先在本地部署社区提供的低显存占用的YuEGP

clone 推理代码

我们我先把推理代码clone下来。

git lfs install
git clone https://github.com/deepbeepmeep/YuEGP/

cd YuEGP/inference/
git clone https://huggingface.co/m-a-p/xcodec_mini_infer
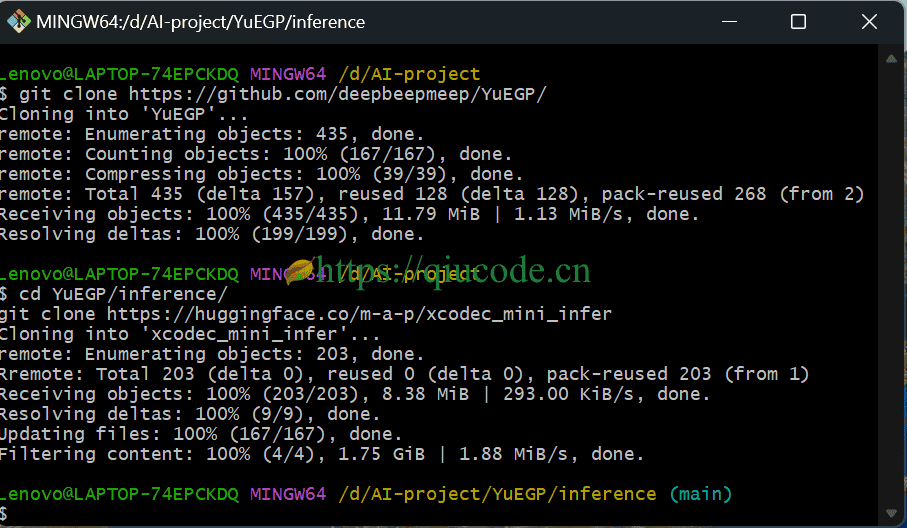
image-20250226210532164

创建虚拟环境

随后,我们使用python3自带的venv来创建虚拟环境,当然咯,你也是可以使用anacondaminiconda来搭建python虚拟环境。

python -m venv YuEGP-env
cd YuEGP-env/Scripts
activate

安装GPU版的torch

设置清华源镜像

pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

安装CUDA对应版本的torch

pip install torch==2.5.1 torchvision torchaudio --index-url https://download.pytorch.org/whl/test/cu124

安装 FlashAttention 2

虽然官方说这个是可选的,但是你不安装这个,是运行不起来的,因为代码中有使用了flashAttention2

在安装flashAttention2之前,你得保证你安装的CUDA版本是在12.4以上。

阿里云开源的文生视频万相 Wan2.1之本地部署Wan2.1-T2V-1.3B模型 中有介绍该如何在windows中安装,如果你是第一次安装的话,可以参考这篇文章,这里就不再赘述了。

安装项目所需的依赖

pip install -r requirements.txt
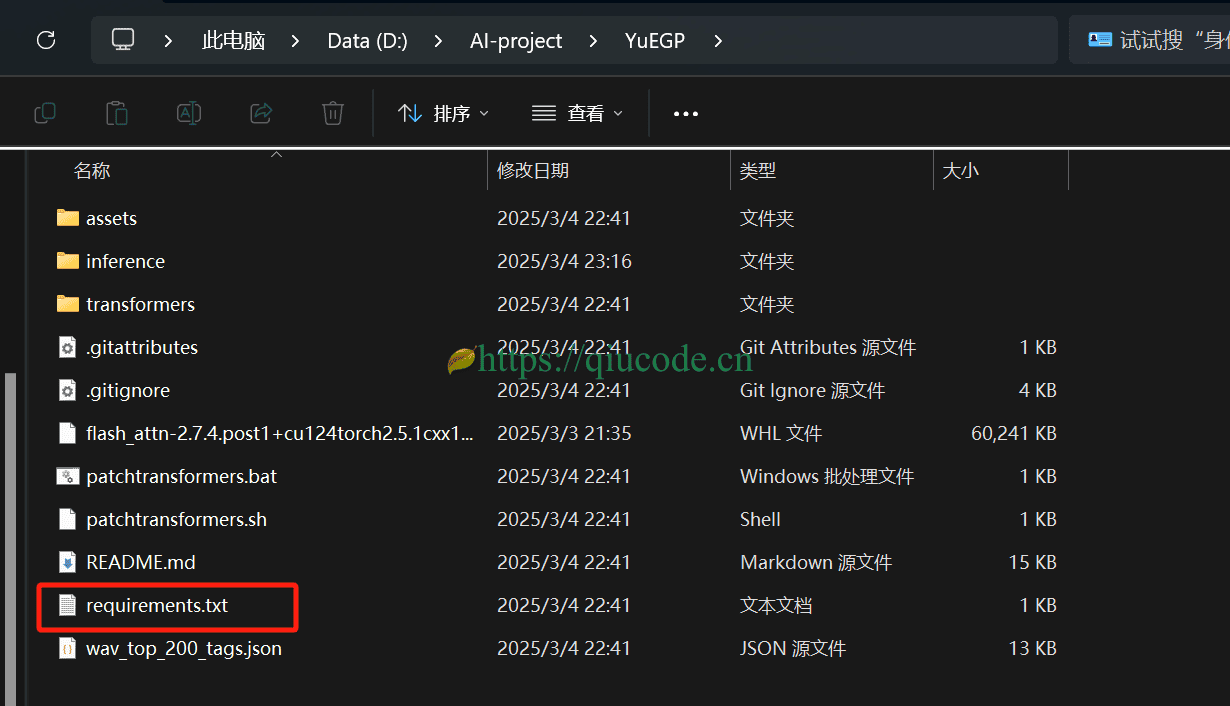
image-20250305212155532

下载模型

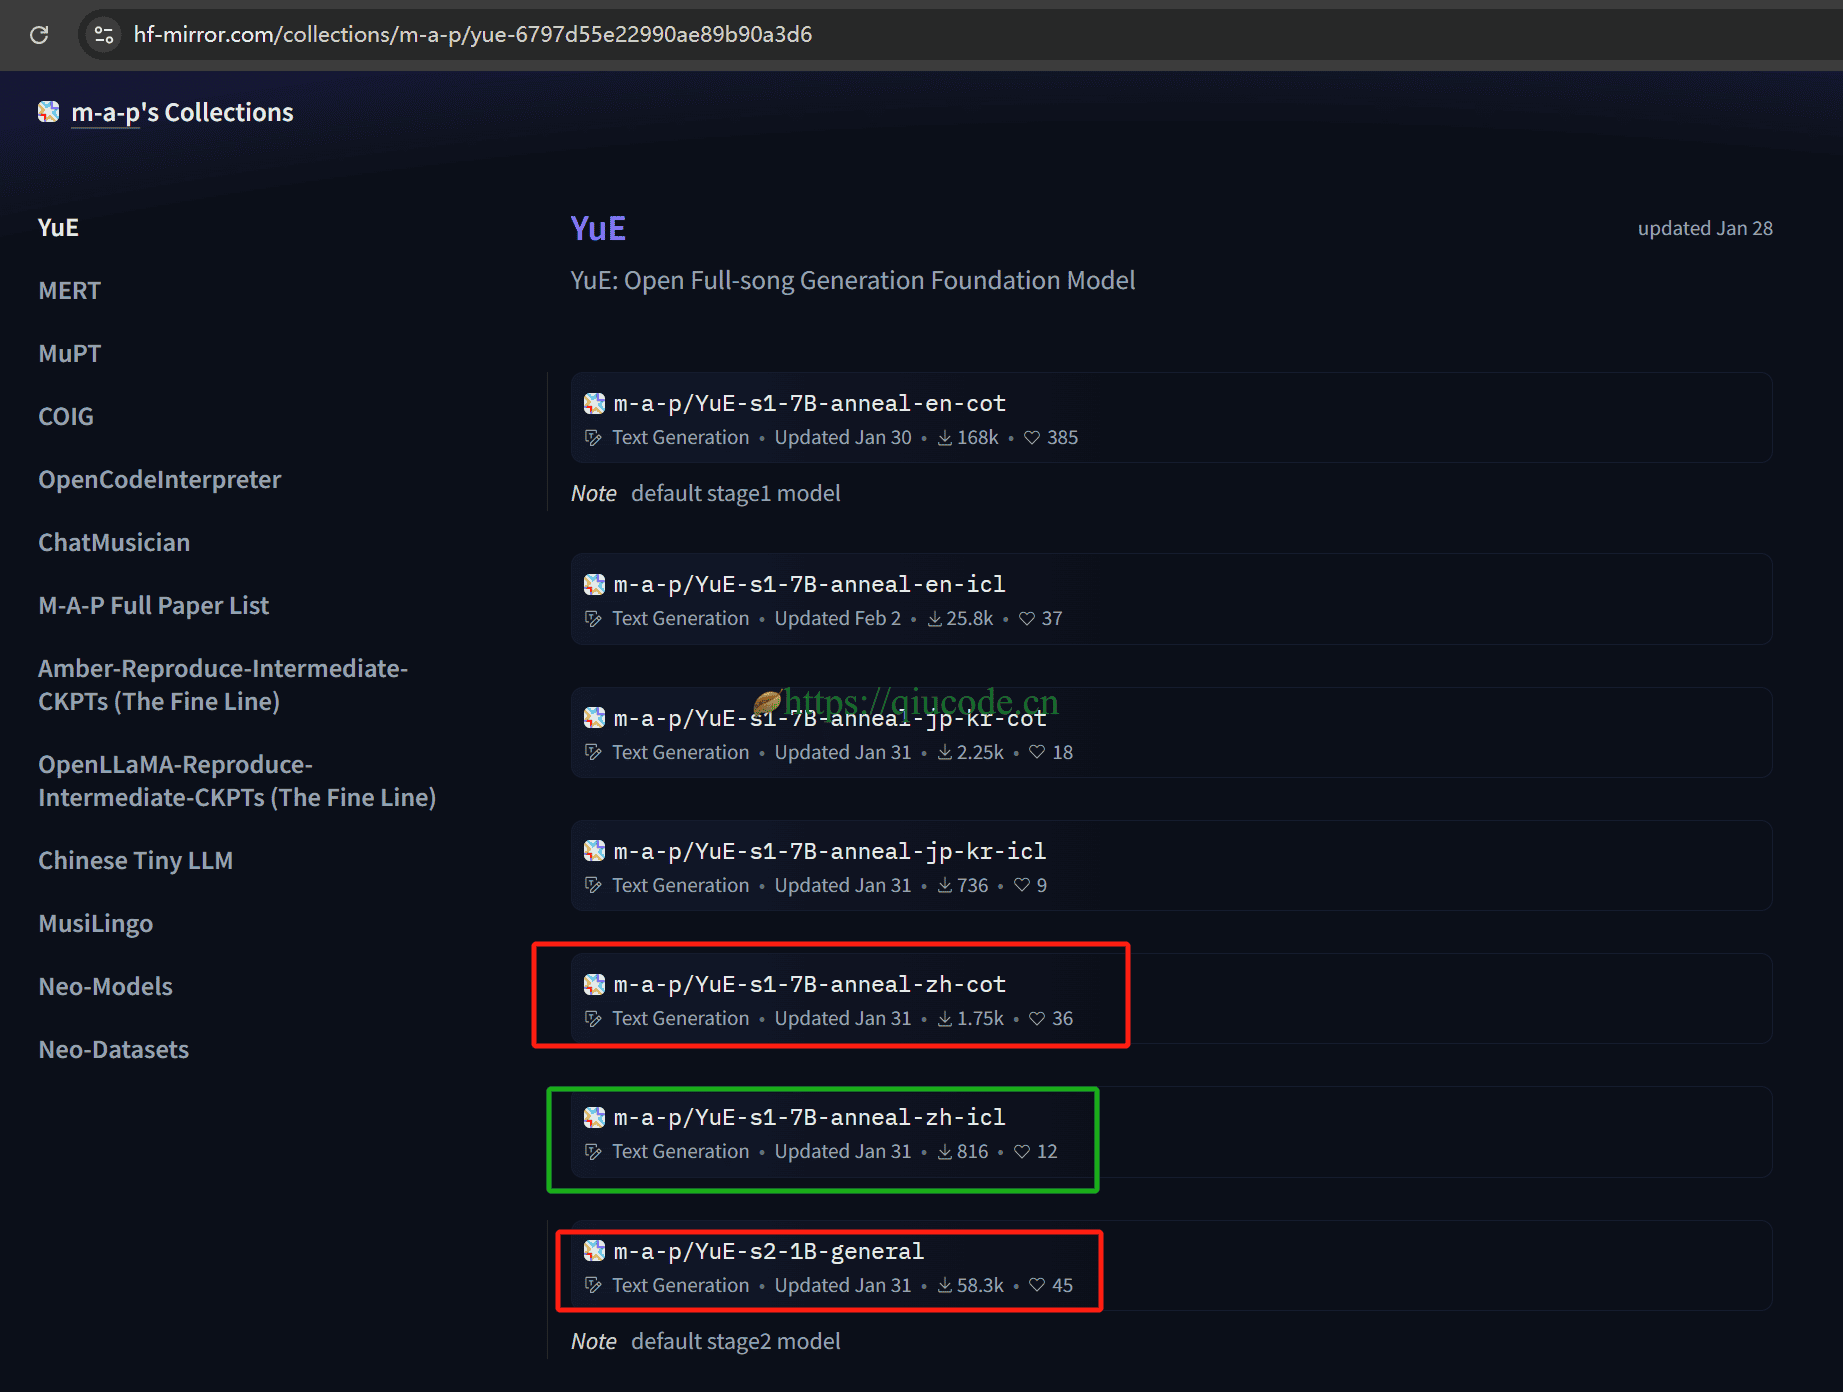
国内可访问的https://hf-mirror.com/collections/m-a-p/yue-6797d55e22990ae89b90a3d6

image-20250305212859714

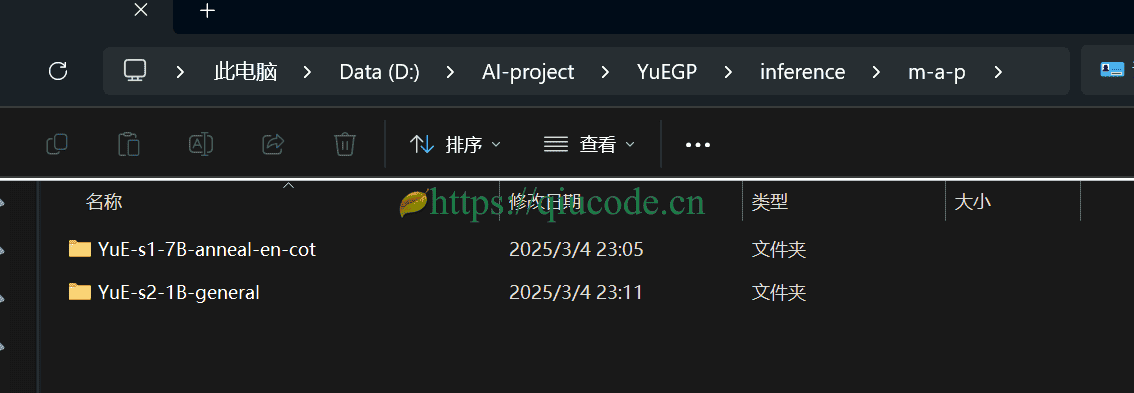
下载的模型存放于inference/m-a-p目录。

image-20250305213202712

运行项目

cd inference
python gradio_server.py
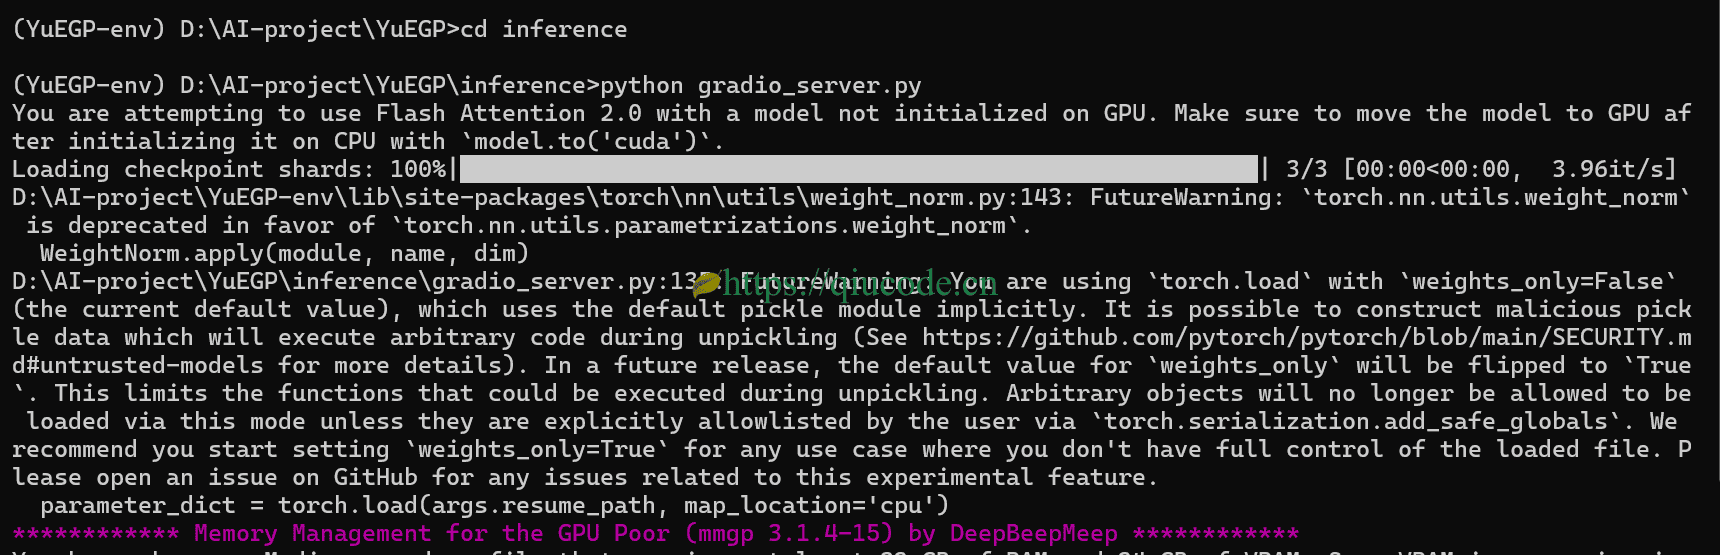
image-20250305213459894

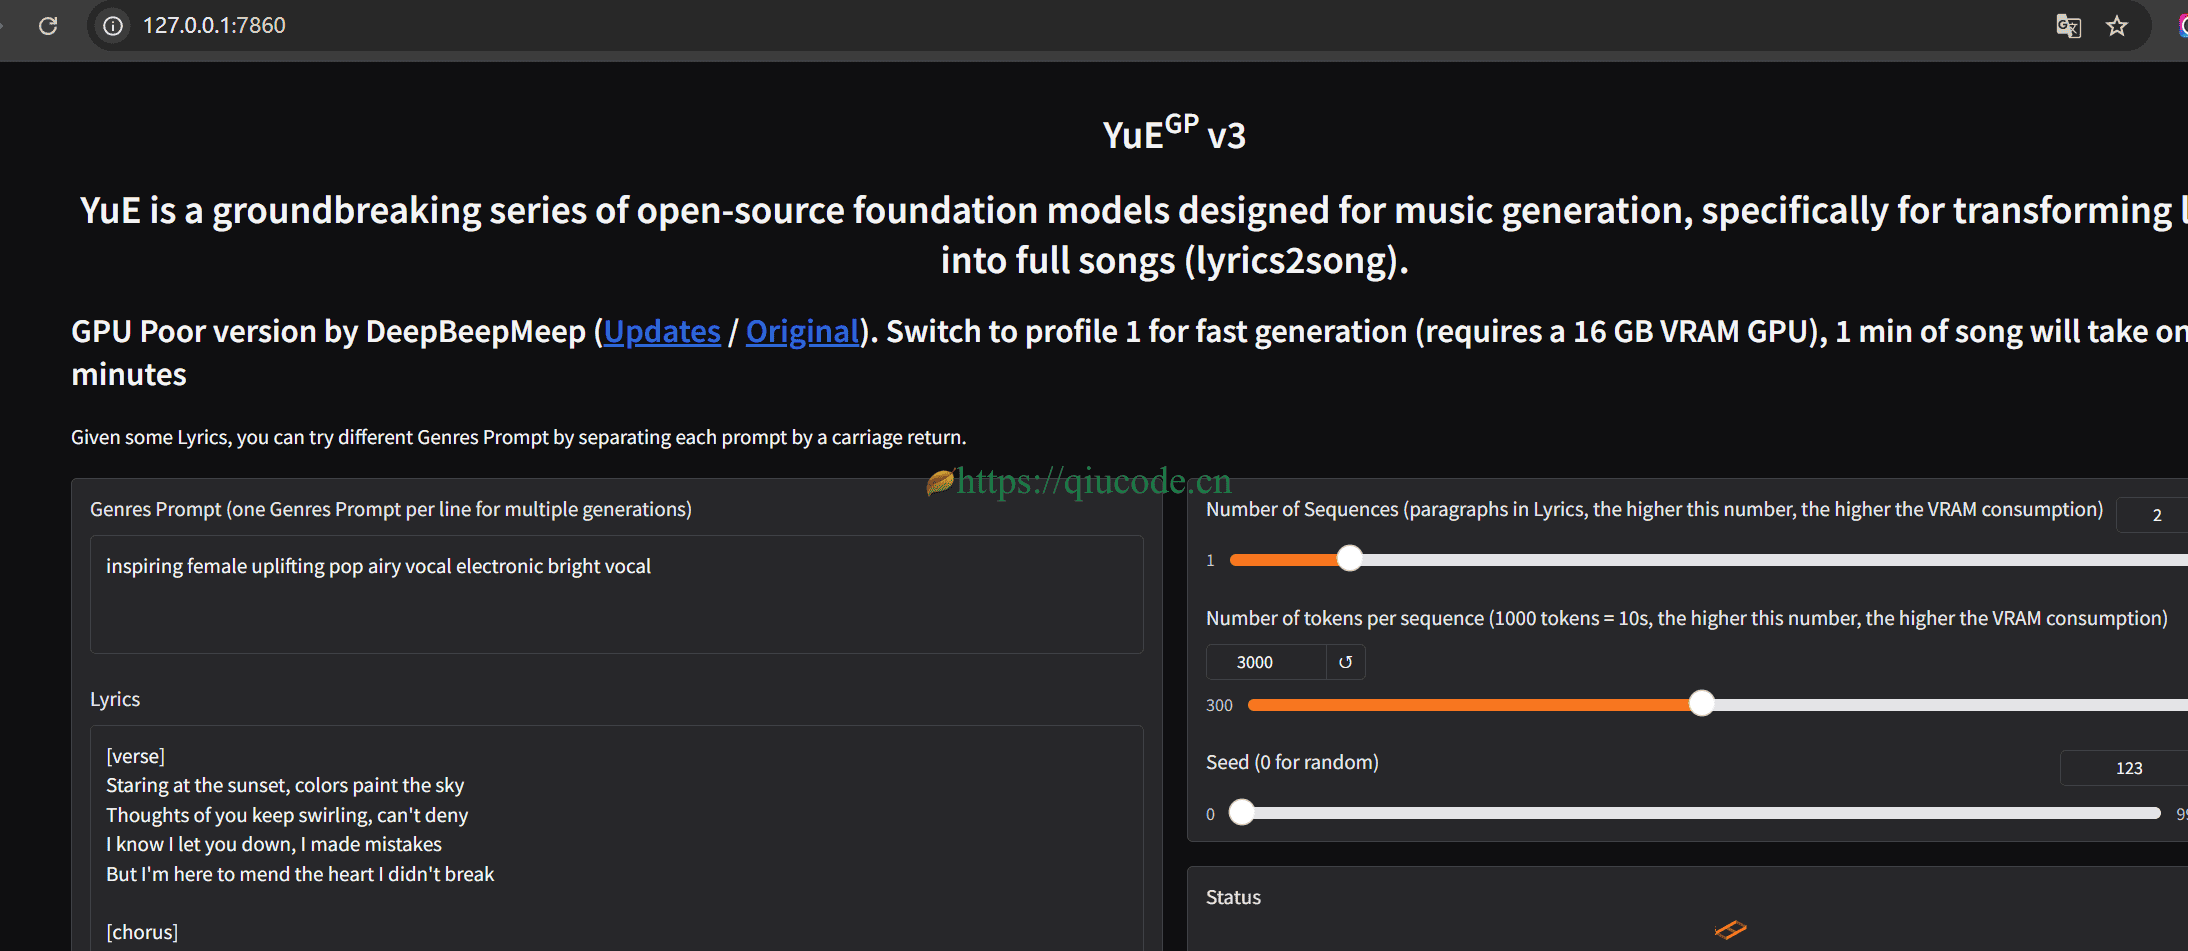
打开你常用的浏览器,在地址栏输入127.0.0.1:7860.

image-20250305213642754

可以调整参数来加速生成。