




错误分析
您将探索数据准备选项,尝试多个模型,筛选出最佳模型,使用 Grid SearchCV微调其超参数,并尽可能实现自动化。在此,我们假设您已经找到了一个有前途的模型,并希望找到改进它的方法。其中一种方法就是分析它所犯的错误类型。
首先,查看混淆矩阵。为此,首先需要使用 cross_val_predict() 函数进行预测;然后可以像之前一样,将标签和预测值传递给 confusion_matrix()函数。不过,由于现在有 10 个类别而不是 2 个,混淆矩阵将包含大量数字,可能难以读取。
混淆矩阵的彩色图更容易分析。要绘制这样的图表,请使用ConfusionMatrixDisplay.from_predictions() 函数,如下所示:
from sklearn.metrics import ConfusionMatrixDisplay

y_train_pred = cross_val_predict(sgd_clf, X_train_scaled, y_train, cv=3) ConfusionMatrixDisplay.from_predictions(y_train, y_train_pred) plt.show()
这就产生了 图1 中的左图。这个混淆矩阵看起来相当不错:大多数图像都在主对角线上,这意味着它们被正确分类了。请注意,对角线上第 5 行第 5 列的单元格看起来比其他数字略暗。这可能是因为模型对 5 的错误较多,也可能是因为数据集中 5 的数量比其他数字少。这就是为什么要对混淆矩阵进行归一化处理,将每个值除以相应(真实)类别中的图像总数(即除以行的总和)。只需设置 normalize="true "即可。我们还可以指定 val ues_format=".0%"参数来显示不带小数点的百分比。下面的代码将生成 图1 右侧的图表:
ConfusionMatrixDisplay.from_predictions(y_train, y_train_pred, normalize="true", values_format=".0%") plt.show()

现在我们不难发现,只有 82% 的 5 图像被正确分类。模型在处理 5 的图像时最常见的错误是将其误判为 8:在所有 5 的图像中,有 10%的图像被误判为 8。但只有 2% 的 8 被误判为 5;混淆矩阵通常不是对称的!如果你仔细观察,就会发现很多数字都被错误地分类为 8,但从这张图上并不能一眼看出。如果想让错误更明显,可以尝试将正确预测的权重设为零。下面的代码就是这样做的,并生成了图2 左侧的图表:
sample_weight = (y_train_pred != y_train) ConfusionMatrixDisplay.from_predictions(y_train, y_train_pred, sample_weight=sample_weight, normalize="true", values_format=".0%") plt.show()

现在你可以更清楚地看到分类器所犯的错误类型了。第 8 类的那一列现在非常明亮,这证明很多图像都被误判为第 8 类。事实上,这几乎是所有类别中最常见的错误分类。但是,在解释图表中的百分比时一定要小心:请记住,我们已经排除了正确的预测结果。例如,第 7 行第 9 列中的 36% 并不意味着所有 7 的图像中有 36% 被错误分类为 9。而是指模型对 7 的图像所做的错误分类中,有 36% 被误判为 9。实际上,只有 3% 的 7 图像被错误分类为 9,如图 1 右图所示。
也可以按列而不是按行对混淆矩阵进行归一化处理:如果设置 normalize="pred",就会得到 图2 右侧的图表。例如,您可以看到 56% 被误判的 7 其实是 9。
分析混淆矩阵通常能让你深入了解改进分类器的方法。通过观察这些图,您似乎应该把精力花在减少错误的 8 上。例如,你可以尝试收集更多看起来像 8 但不是 8 的数字的训练数据,这样分类器就能学会将它们与真正的 8 区分开来。或者,你也可以设计新的特征来帮助分类器–例如,编写一种算法来计算闭合循环的数量(例如,8 有两个,6 有一个,5 没有)。或者,你也可以对图像进行预处理(例如,使用 Scikit-Image、Pillow 或 OpenCV),使某些模式(如闭合循环)更加突出。
分析单个错误也是深入了解分类器工作情况和失败原因的好方法。例如,让我们以混淆矩阵的形式绘制 3 和 5 的示例(图 3):
cl_a, cl_b = '3', '5'
X_aa = X_train[(y_train == cl_a) & (y_train_pred == cl_a)]
X_ab = X_train[(y_train == cl_a) & (y_train_pred == cl_b)]
X_ba = X_train[(y_train == cl_b) & (y_train_pred == cl_a)]
X_bb = X_train[(y_train == cl_b) & (y_train_pred == cl_b)]
[...]  # plot all images in X_aa, X_ab, X_ba, X_bb in a confusion matrix style
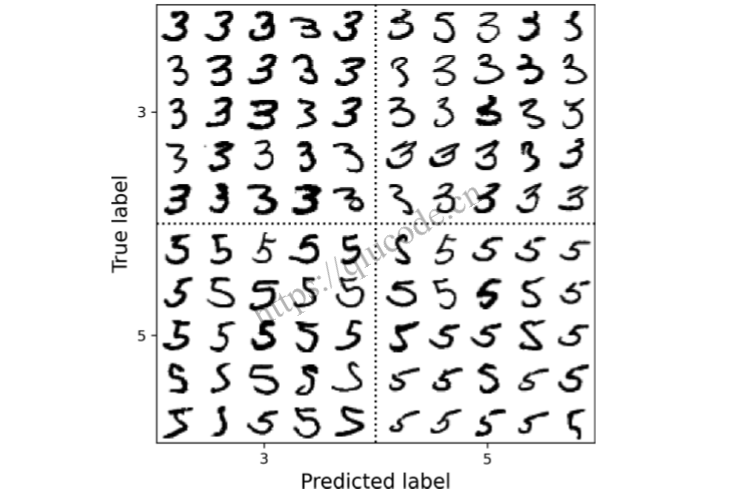
正如您所看到的,分类器弄错的一些数字(即左下角和右上角的数字块)写得非常糟糕,甚至连人都很难对它们进行分类。不过,大多数分类错误的图像在我们看来都是显而易见的错误。我们可能很难理解分类器为什么会犯这样的错误,但请记住,人脑是一个神奇的模式识别系统,我们的视觉系统会在任何信息到达我们的意识之前进行大量复杂的预处理。因此,这项任务感觉简单并不意味着它就是简单的。回想一下,我们使用的是一个简单的 SGDClassifier,它只是一个线性模型:它所做的只是为每个像素分配一个类别权重,当它看到一个新图像时,它只是将加权像素强度相加,得到每个类别的分数。由于 3 和 5 只相差几个像素,这个模型很容易将它们混淆。
3 和 5 的主要区别在于连接顶线和底弧的小线的位置。如果您画的 3 的交界处稍微向左移动,分类器可能会将其归类为 5,反之亦然。换句话说,这种分类器对图像移动和旋转相当敏感。减少 3/5 混淆的一种方法是对图像进行预处理,以确保图像居中且没有过度旋转。然而,这并不容易,因为这需要预测每幅图像的正确旋转。一种简单得多的方法是用训练图像的轻微移动和旋转变体来增加训练集。这将迫使模型学会对这种变化有更大的容忍度。这就是所谓的数据增强。