惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

M
MIT News - Artificial intelligence
雷峰网
雷峰网
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
Last Week in AI
Last Week in AI
奇客Solidot–传递最新科技情报
奇客Solidot–传递最新科技情报
阮一峰的网络日志
阮一峰的网络日志
月光博客
月光博客
博客园 - Franky
腾讯CDC
T
Tailwind CSS Blog
Recent Announcements
V
V2EX
N
Netflix TechBlog - Medium
量子位
Jina AI
Jina AI
Y
Y Combinator Blog
The GitHub Blog
The GitHub Blog
G
Google Developers Blog
爱范儿
爱范儿
博客园 - 叶小钗
D
Docker
MongoDB | Blog
MongoDB | Blog
D
DataBreaches.Net
T
The Blog of Author Tim Ferriss

秋码分享

我是如何解决将 c++ 编译成可以在 node.js 中使用的 *.node,中间出现的一大堆问题的(指纹浏览器基石篇) eSIM Plus 爱沙尼亚手机号彻底翻车?“永久有效”悄然变成了一年! 接码平台 SMS-Activate 余额可以转移到新平台使用,截止日期:2026年1月29日 是时候将 hugo-theme-kiwi 主题提交到 themes.gohugo.io 站点上了 Flux2 刚开源就凉了?Z-Image 本地部署狠狠打了个样 声音的未来:Chatterbox —— 用「夸张度旋钮」提升表现力的开源 TTS 向导 还以为那只是换个背景?Qwen-Image-Edit 在 ComfyUI 中能做到更离谱的事 Windows 结合最新版 ComfyUI 部署阿里最新开源的 Qwen-Image 图像大模型 从零样本到跨场景:Seed-VC语音转换技术的革命性突破 大语音模型轻量化革命:MegaTTS3 如何重新定义文本生成语音的技术边界(windows篇) 阿里开源了端到端全模态大模型Qwen-2.5-Omini-7B之本地部署(windows篇) 语音识别之whisper本地部署(实时语音之开篇) 甭管是个人还是企业都能部署的Mistral-Small3.1,远超同级别的模型 文生音乐开源项目DiffRhythm,8G显存本地部署之Windows篇 阿里QwQ-32B本地部署指南:用Ollama轻松运行320亿参数大模型 基于Qwen2.5大模型的Spark-TTS,零样本语音克隆,CPU可运行之本地部署(Windows篇) 智谱开源了文生图CogView4-6B模型,支持中文提示词之本地部署(Windows篇) 基于歌词生成整首歌的开源AI音乐模型,支持中、英、日、韩等多种语言,本地化部署YuE(windows篇) 阿里云开源的文生视频万相 Wan2.1之本地部署Wan2.1-T2V-1.3B模型 互动式开源AI图像编辑神器,Windows11本地部署 MagicQuill 本地部署Qwen2.5-VL-7B-Instruct多模态视觉大模型(Windows篇) 保持角色一致性的绘本生成AI开源项目之Story-Adapter本地部署Windows篇 本地部署 Stable Diffusion 3.5(最新 ComfyUI记录篇) 谁说Win7安装不了Node.js最新版的呢?都2025年,还不更新系统到Win11 vs code远程调试Linux服务器上的php代码 浏览器定制 | Windows11 编译 Chromium 133.0.6885.0(截稿前Chromium最新版之编译篇[一]) 不说是彻底搞懂,至少让你不再惧怕c/c++指针,以及各种奇葩指针变种 解决windows下php8.x及以上版本,在Apache2.4中无法加载CURL扩展的问题 在 Windows8.1 下编译 Chromium (103.0.5060.68 之三) 安装 depot_tools 和 Windows 10 SDK 为在Windows下构建基于 chromium 的浏览器(103.0.5060.68 之二)
竞赛级编程大模型OlympicCoder-7B之本地部署(Windows篇)
一个游离于山间之上的江湖漫行者。A jungle wanderer who wanders above the mountain · 2025-04-01 · via 秋码分享

一、核心定位与技术亮点

  1. 竞赛级代码推理能力 OlympicCoder-7B 针对编程竞赛(如国际信息学奥林匹克竞赛 IOI)需求设计,通过 CodeForces-CoTs 数据集(包含 10 万高质量思维链样本)进行训练,覆盖 C++ Python 语言的算法实现。该模型在 IOI 挑战赛中表现出色,生成代码的通过率和效率显著优于同规模模型 。

  2. 真实竞赛场景优化 模型模拟了竞赛中的提交策略优化机制,例如在严格的时限内生成代码并通过测试用例验证,确保生成结果的正确性和效率。其训练数据整合了 CodeForcesDeepMind CodeContests 等竞赛平台的问题及官方解题思路,强化了算法逻辑的精准性 。

  3. 轻量化与高效部署 作为 7B 参数量的模型,OlympicCoder-7B 在保证性能的同时降低了硬件门槛,可在消费级 GPU 上运行,适合开发者和教育机构本地化部署。量化版本(如 Q4_K_M)内存占用仅约 5GB,生成速度可达 45 tokens/s 。

二、性能对比与实测表现

  1. 算法竞赛任务 在 CodeForces 和 IOI 题型测试中,OlympicCoder-7B 的代码生成准确率接近 32B 版本(如 OlympicCoder-32B),且在贪吃蛇游戏等复杂编程任务中生成代码的可执行性显著优于同规模模型 。

  2. 跨模型对比 与同属代码生成领域的 aiXcoder-7B(北大开源)相比,OlympicCoder-7B 在竞赛题目上的表现更优,但 aiXcoder 在长上下文补全(支持 32k 上下文)和企业级开发场景中更具优势 。而与 Magicoder-7B(UIUC/清华联合开发)相比,OlympicCoder 更专注于算法优化而非通用代码生成 。

三、应用场景与局限性

  1. 适用场景
    • 算法竞赛训练:为选手提供代码思路和解题参考。
    • 编程教育工具:辅助学生理解复杂算法实现逻辑。
    • 自动化评测系统:生成测试用例或验证代码正确性。
  2. 局限性
    • 领域专注性:在通用软件开发场景(如 Web 开发)中表现不及专用模型。
    • 数据时效性:需定期更新竞赛题库以保持模型对最新题型的适应能力。

四、本地部署

首先,我们使用python3自带的venv模块来搭建python 虚拟环境。当然,你也可以使用anaconda或者miniconda来构建python 虚拟环境

python -m venv OlympicCoder-env
cd OlympicCoder/Scripts
activate
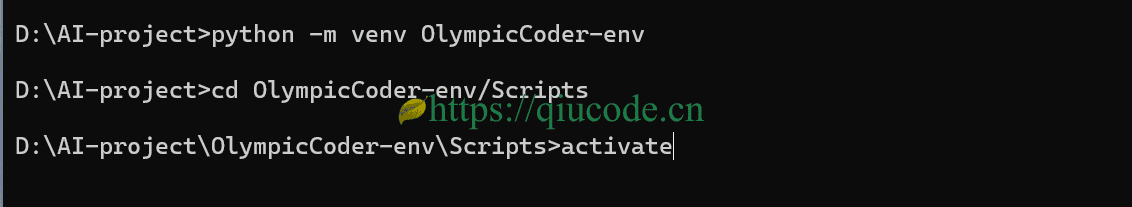
image-20250331202518195

安装CUDA版本的torch依赖库。

pip install torch --index-url https://download.pytorch.org/whl/cu124

image-20250331203114568

随后,我们安装huggingface开源的transformers

pip install git+https://github.com/huggingface/transformers

image-20250331203939498

再者,安装依旧来自huggingface开源的用于加速推理的accelerate依赖库。

pip install git+https://github.com/huggingface/accelerate
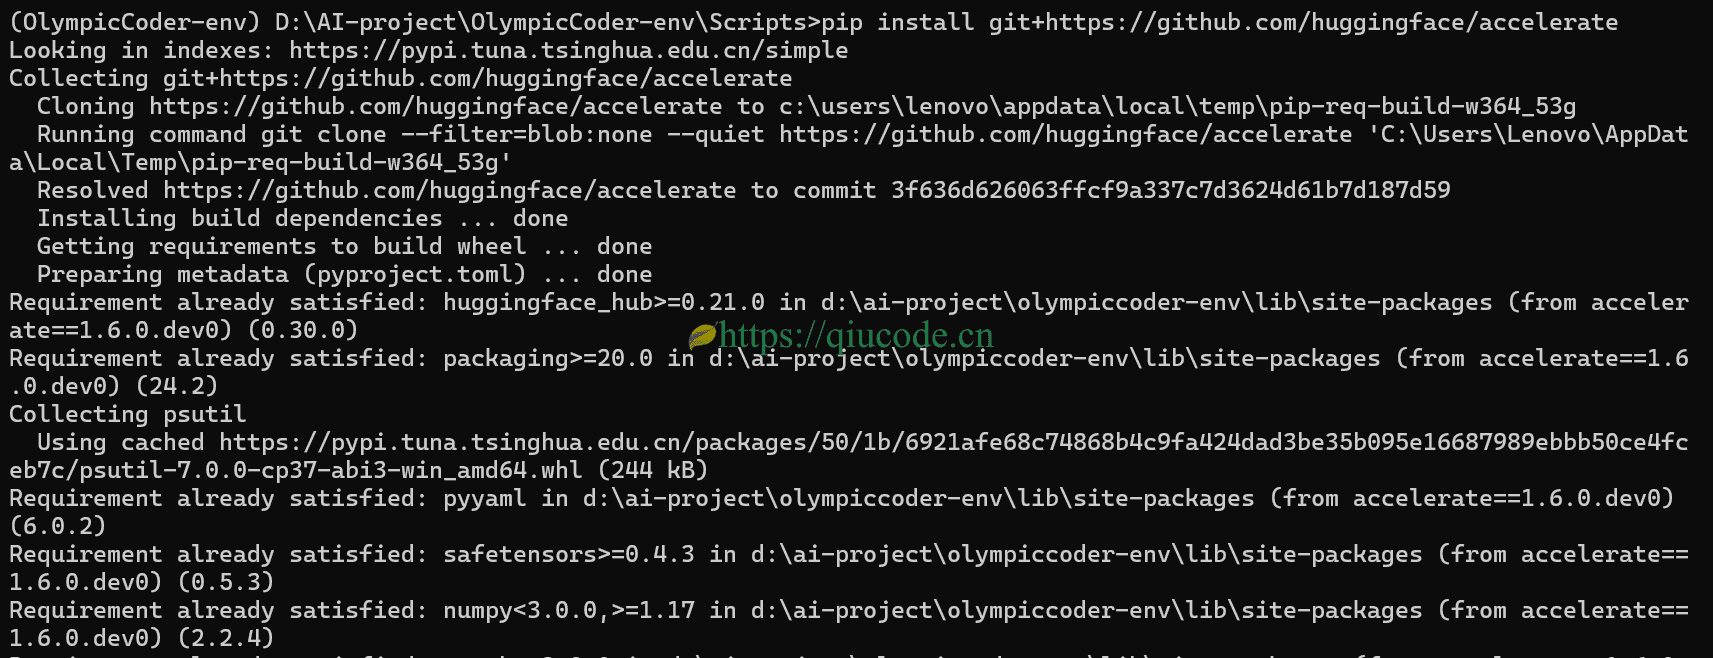
image-20250331204311565

接着,安装huggingface_hub是用于下载模型的。

pip install huggingface_hub
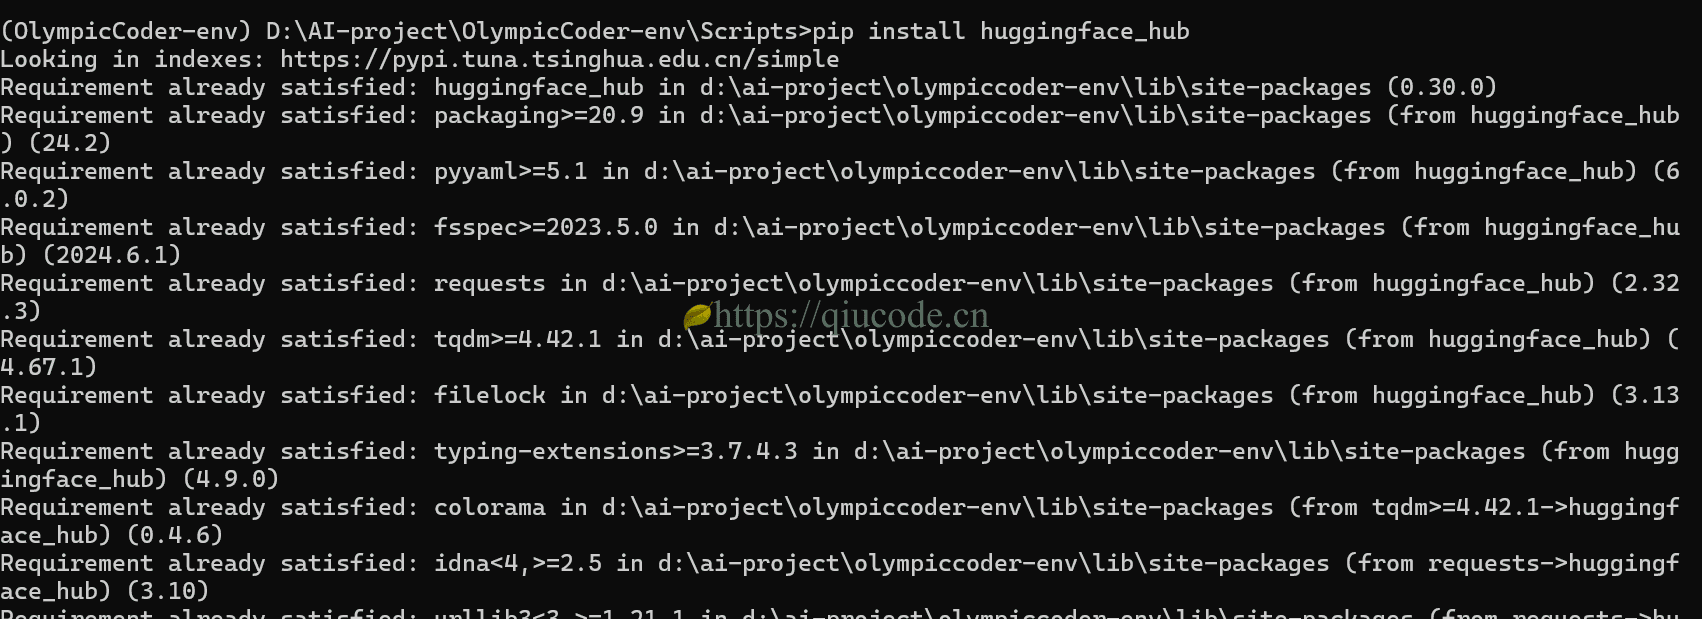
image-20250331204559469

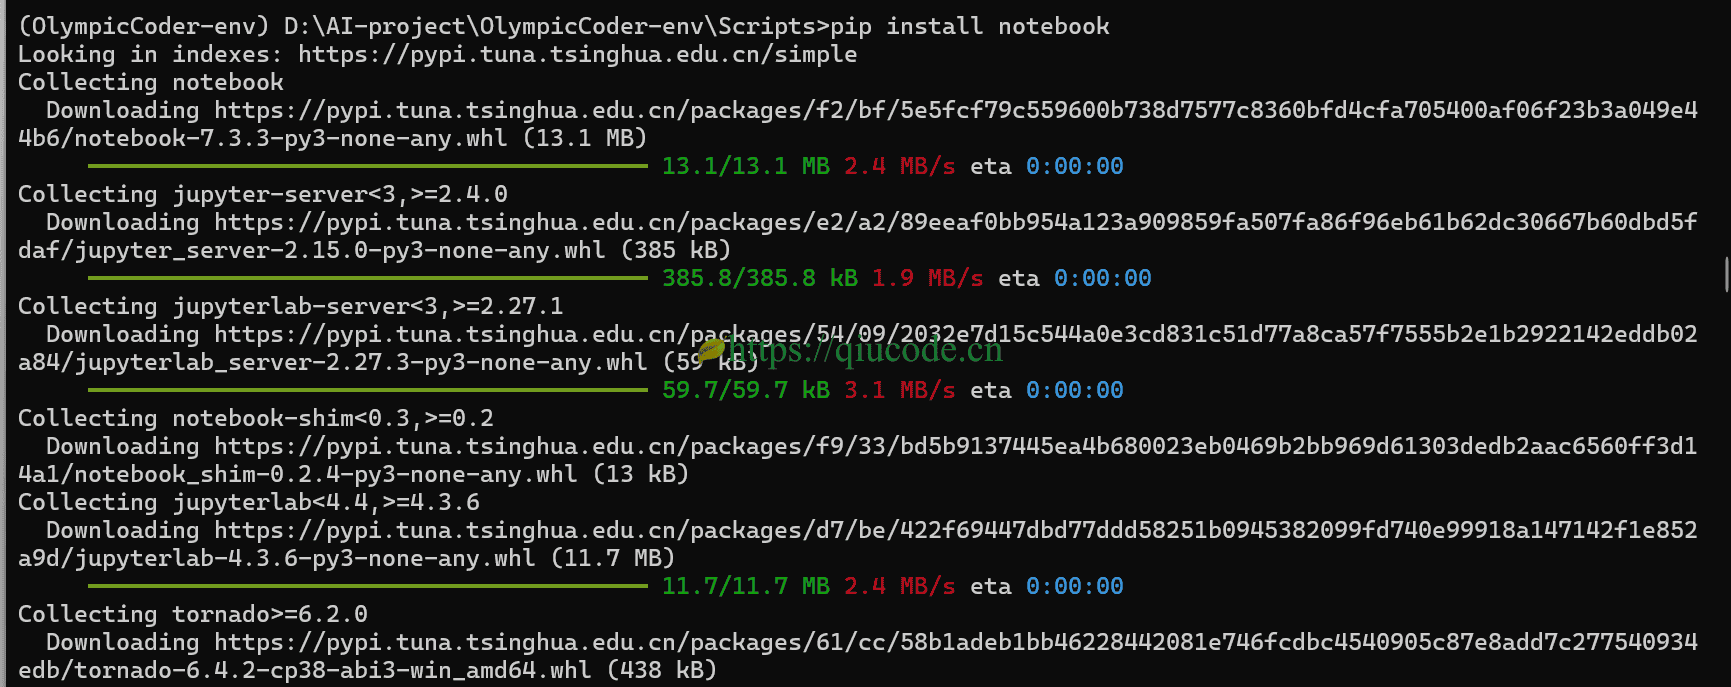
至于notebook这个依赖库是可选的。

image-20250331210023329

使用以下命令,为我们在浏览器中打开一个标签页,供我们编写ipynb文件。

import torch
import transformers
from IPython.display import Markdown, display

model_id = "open-r1/OlympicCoder-7B"

# 正确使用 pipeline
pipeline = transformers.pipeline(
    "text-generation",
    model=model_id,
    model_kwargs={"torch_dtype": torch.bfloat16},
    device_map="auto"
)
prompt="""
Write a python program to calculate the 10th Fibonacci number
"""

messages = [
    {"role": "system","content": "You are helpful assistant!"},
    {"role": "user","content": prompt}
]

outputs = pipeline(messages,max_new_tokens=1024,)
output_text = outputs[0]["generated_text"][-1]['content']
display(Markdown(output_text))
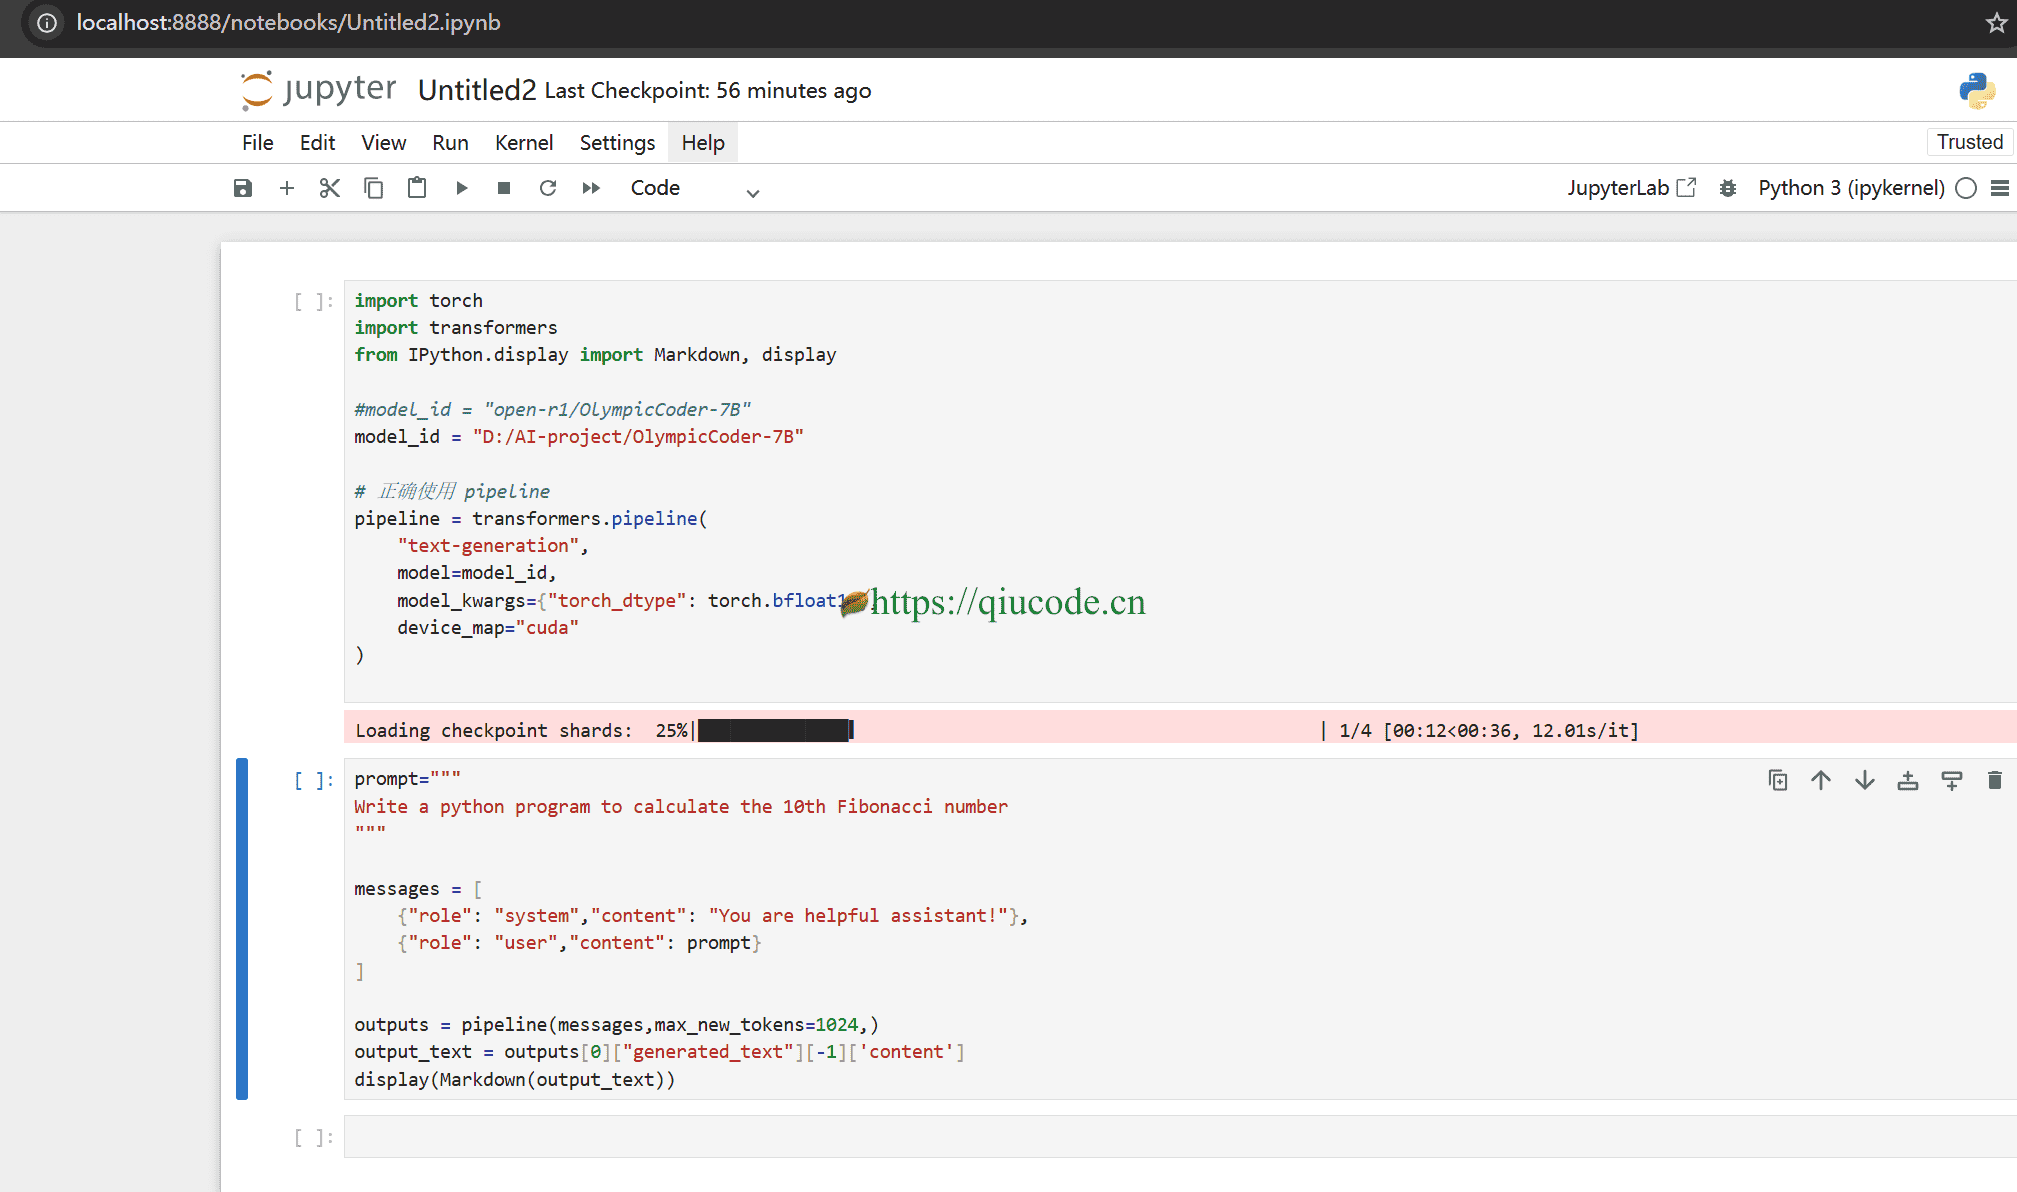
image-20250401224630834