惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

雷峰网
雷峰网
Y
Y Combinator Blog
酷 壳 – CoolShell
酷 壳 – CoolShell
The Cloudflare Blog
博客园_首页
J
Java Code Geeks
A
About on SuperTechFans
人人都是产品经理
人人都是产品经理
量子位
C
Check Point Blog
让小产品的独立变现更简单 - ezindie.com
博客园 - 三生石上(FineUI控件)
L
LangChain Blog
N
Netflix TechBlog - Medium
Hugging Face - Blog
Hugging Face - Blog
B
Blog
美团技术团队
Microsoft Security Blog
P
Proofpoint News Feed
freeCodeCamp Programming Tutorials: Python, JavaScript, Git & More
宝玉的分享
宝玉的分享
罗磊的独立博客
MongoDB | Blog
MongoDB | Blog
Last Week in AI
Last Week in AI

木鸟杂记

工程中的经典“意象”(一):滑动窗口 一个大模型从业者的 Vibe Coding 一些一线经验 大模型的损失函数为什么是交叉熵 Why Is the Loss Function of Large Models Cross-Entropy 20260120 B 站直播 —— 转行大模型文字精要 20260120 Bilibili Live — Key Takeaways on Switching to LLMs 2025 Year-End Summary — Inward Growth 2025 年终总结——向内生长 深入理解大模型 1:Transformer,大模型的基石 Deep Dive Into Large Models 1: Transformer, the Foundation of Large Models 在云上进行大规模数据处理的一些实践 Some Practices for Large-Scale Data Processing on the Cloud A Data Visualization Powerhouse — the Interesting Philosophy of Streamlit 从“丰巢”快递柜看 Jemalloc 的内存管理 Understanding Jemalloc's Memory Management Through "Hive Box" Parcel Lockers Snowflake:云原生数仓的开创者 'Snowflake: The Pioneer of Cloud-Native Data Warehouses' 人生是旷野 —— 罗素《幸福之路》 Life Is a Wilderness —— Bertrand Russell's "The Conquest of Happiness" 使用 ray.data 进行大规模数据处理(二):全局视角 'Large-Scale Data Processing With ray.data (Part 2): A Global Perspective' 有趣的线性代数(一):矩阵乘法 Infra 面试之数据结构五:顺序组装 关于如何在晴天卖出 250 把雨伞这件事 螺蛳壳里做道场:实现一个256KB的迷你文件系统 MemGraph 背后论文《基于内存和MVCC 的高速可串行化》详细解析(一) 2023 年终总结——穷则思变 Y Combinator 2024 年关注 20 个创业领域 使用“隐喻”的方式帮你建立对 Raft 的直觉 构建和维护星球最强对象存储系统的一点微小经验
数据可视化利器—— Streamlit 的有趣哲学
青藤木鸟 (qtmuniao) · 2025-03-18 · via 木鸟杂记

streamlit 是一款可以快速进行简单网页开发的 Python 库,其 slogan 是:

A faster way to build and share data apps

即“一种快速构建、分享数据应用的方法”。其在机器学习、数据科学,甚至当今大模型领域非常流行。其优点非常突出:

  1. 使用上述领域开发者最喜欢的语言:Python。不用写前端,pip 安装就能用。
  2. 简单几行代码就能快速攒出一个数据可视化、打标等小工具的网页。
  3. 还支持丰富的第三方组件扩展,比如社区开发的 code_editor

当然,如果你还想要低延迟、高并发、深度定制等需求,那对不起,这是 streamlit 被 tradeoff 出去的那一部分。但对于面向内部少数人使用的小工具来说,streamlit 简直是利器。可以说这个小生态位被它卡的太好了,所以能在 2022 年以 8 亿美金卖给 Snowflake。

本文我们就一块来看看其基本设计哲学和一些简单实践。

设计哲学

其基本设计哲学可以概括为:

  1. 用后端语言写前端
  2. 收到新事件会重新构建
  3. 支持会话级别的缓存

作者:木鸟杂记 https://www.qtmuniao.com/2025/03/18/streamlit/ 转载请注明出处

上面三点是依次递进的设计:由于是用后端语言写前端,因此每次响应用户请求都会全部重新执行一遍代码,当然也就不支持局部刷新;为了避免每次全部执行带来的不必要的数据加载,引入了细粒度(每次用户主动刷新页面会丢失)的缓存,从而达到了类似局部刷新的目标——不需要刷新的部分缓存起来复用就好了。

总结成一句话就是:顺序执行以保持简洁,按需缓存来提高效率。

看个例子

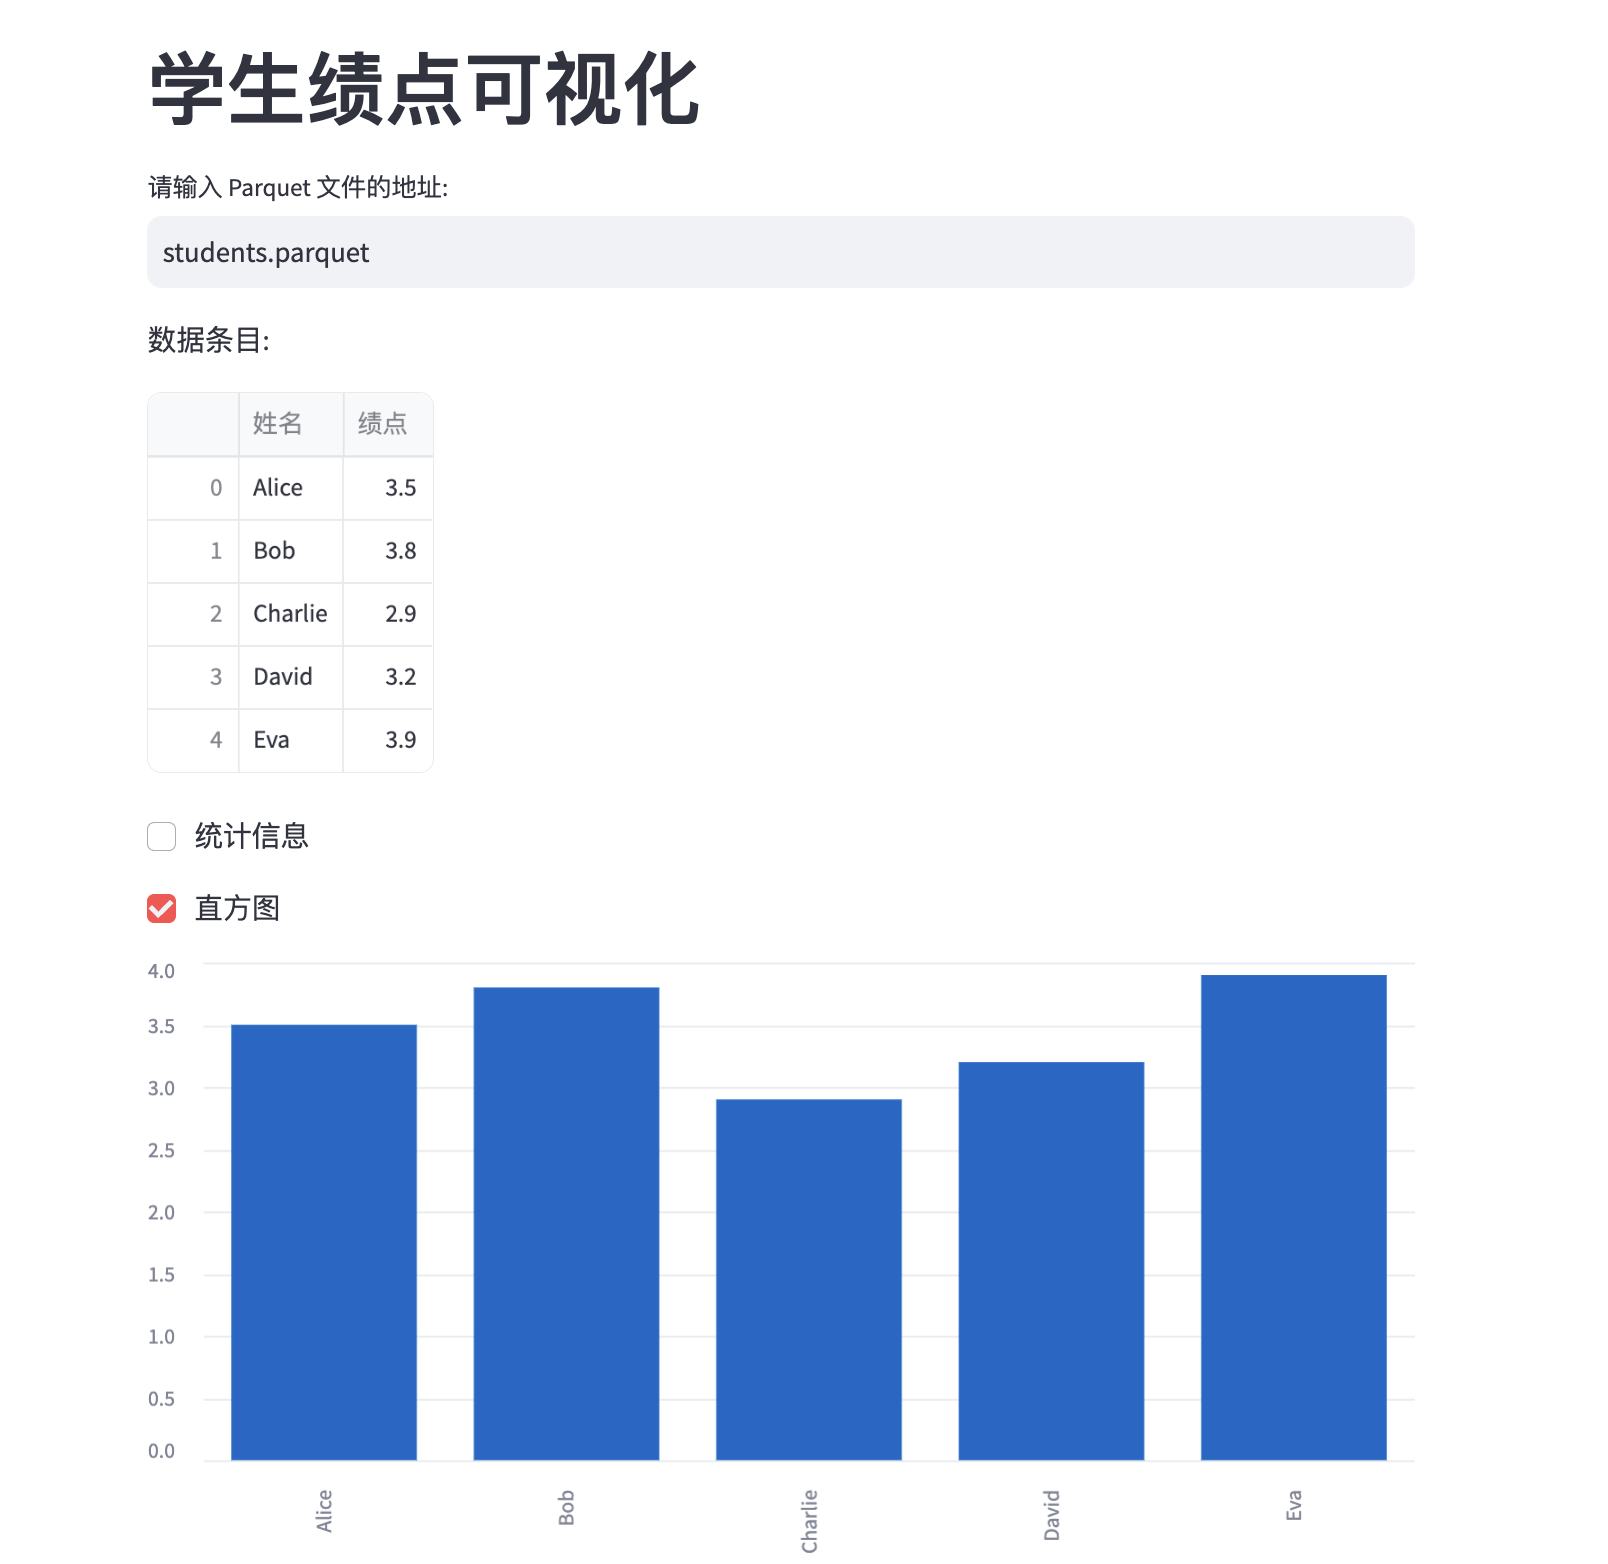
我们把功能搞简单一点:用户输入一个 parquet 格式本地路径,我们将其读出展示可视化。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31


import streamlit as st
import pandas as pd
import pyarrow.parquet as pq
import os


def load_parquet(file_path):
return pq.read_table(file_path).to_pandas()

st.title("学生绩点可视化")

file_path = st.text_input("请输入 Parquet 文件的地址:", value="students.parquet")


if os.path.exists(file_path):

data = load_parquet(file_path)
st.write("数据预览:")
st.dataframe(data)


if st.checkbox("统计信息"):
st.write(data.describe())


if st.checkbox("直方图"):
st.bar_chart(data.set_index('姓名')['绩点']
else:
st.error("输入的文件路径不存在,请检查后再试。")

简单构造了包括学生名和绩点两列的数据,存在 parquet 文件中(构造代码会放在附录中)。运行以下命令:

1
streamlit run app.py

然后访问 http://localhost:8501 即可看到页面:

streamlit-example.pngstreamlit-example.png

从该例子可以大致看出 streamlit 的语法相当简洁:

  1. 组件构造:通过 st.title,st.dataframe,st.checkbox 等接口就可以快速构造很多标准组件,而不用在意其样式。
  2. 顺序执行:和 js 事件驱动不同,streamlit 的代码就是自上而下顺序执行的,非常容易理解和调试。每次重新输入路径、重新点击复选框后整个页面都会重新渲染。

缓存

那么问题来了,如果学生表的数据量很大,每次重新输入路径后都会全部重新执行、重新加载,岂不是冗余且很慢?为此,我们可以通过 streamlit 的缓存机制,将数据缓存下来。

可以使用 st.session_state 显式的进行缓存:

1
st.session_state[file_path] = data

也可以通过在加载数据上的函数增加注解 st.cache_data进行缓存,此时缓存的 key 就是函数的输入参数,本例中也是 file_path

1
2
3
@st.cache_data
def load_parquet(file_path):
return pq.read_table(file_path).to_pandas()

但其实,在 streamlit 中,我们不仅可以缓存数据,也可以缓存组件(widget)。比如说 st.dataframe,如果我们不想其每次都重新渲染怎么办?给其一个 key!

1
st.dataframe(data, key=f"df-{file_path}")

这样,只要 key 不变,该 dataframe 就不会重新渲染。

至此,我们大概从感性上明白了 streamlit 的哲学:通过顺序执行来保持简洁、通过按需缓存来保持效率。下面用一张图来概括下:
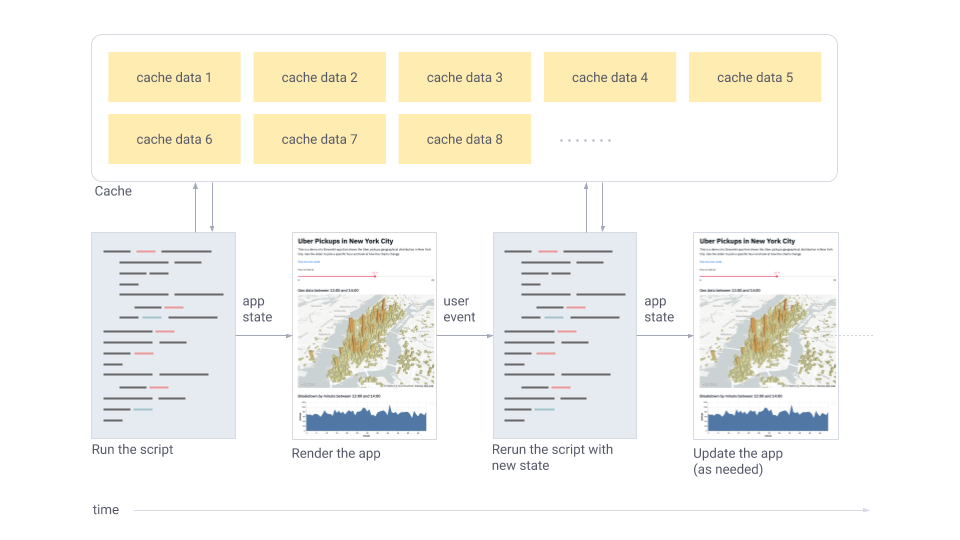
streamlit-architecture.pngstreamlit-architecture.png

小结

本文非常浅显的通过一个小例子来分析了下 streamlit 的设计哲学,帮助大家建立一个感性的认识,如果有类似面向团队内部的可 GUI 需求,不妨一试。

但囿于篇幅,并没有剖析其背后是如何实现的,也没有讲更多的进阶使用,如果大家对这些东西感兴趣,欢迎留言告诉我。

参考资料

官方文档:https://docs.streamlit.io/get-started/fundamentals/advanced-concepts

附录

需要安装的库:

1
pip install streamlit pyarrow pandas

构造数据的代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
import pandas as pd


data = {
'姓名': ['Alice', 'Bob', 'Charlie', 'David', 'Eva'],
'绩点': [3.5, 3.8, 2.9, 3.2, 3.9]
}


df = pd.DataFrame(data)


df.to_parquet('students.parquet', index=False)

print("学生数据已写入 students.parquet 文件。")

我是青藤木鸟,一个喜欢摄影、专注大规模数据系统的程序员,欢迎关注我的公众号:“木鸟杂记”,有更多的分布式系统、存储和数据库相关的文章,欢迎关注。 关注公众号后,回复“资料”可以获取我总结一份分布式数据库学习资料。 回复“优惠券”可以获取我的大规模数据系统付费专栏《系统日知录》的八折优惠券。

我们还有相关的分布式系统和数据库的群,可以添加我的微信号:qtmuniao,我拉你入群。加我时记得备注:“分布式系统群”。 另外,如果你不想加群,还有一个分布式系统和数据库的论坛(点这里),欢迎来玩耍。

wx-distributed-system-s.jpg