












随着大模型在国内这片土壤生根发芽,企业对相关人才的争夺也愈发激烈,在招聘软件上我们不难看到,不少企业甚至开出高年薪以抢夺算法、深度学习等高级技术人才。不过,在人才的争夺之外,还有那些问题是大模型落地过程中急需解决的?一起来看看作者的解读。
大模型越来越火,抢人大战愈演愈烈。
在AIGC、ChatGPT的带动下,大模型概念开始被广泛讨论。2023年还未过半,就已经有包括百度、阿里、腾讯、商汤、京东、科大讯飞等多家互联网、AI公司陆续宣布对大模型展开探索。
诚然,在大模型的技术和商业化进程上,国内相较于国外仍有一定差距。因此,大厂们毫不吝啬地开出百万年薪来争夺算法、深度学习等高级技术人才。
除此之外,大模型在中国这片土壤上要如何生长,其商业化进程又需要突破哪些瓶颈呢?
AIGC和ChatGPT等热词带动下,大模型概念逐渐被关注。不过,大模型到底是什么,又能做什么,对很多人来说,这个问题的答案似乎很模糊。
一位中国传媒大学计算机技术硕士,在知乎上这样描述了大模型:如果说模型是一个盒子,那么普通模型就是一个小盒子,因为容量有限,所以其处理和存储的数据、信息也有限。因此,普通模型可以完成分类、预测、生成等简单任务;相较之下,大模型就是一个超级大仓库,往往需要数十亿,甚至上百亿个参数组成,可以完成更高级的思考和决策。比如,自然语言理解、语音识别、图像识别等。
而这个大模型,到底有多“大”?举例来说,GPT-4使用了1750亿规模的参数,微软推出的Turing-NLG有1000亿参数,谷歌则推出号称有1.6万亿模型参数的switch transformer。作为对照,我们日常使用的智能语音通常只有几个亿的参数。
虽然,在模型参数的规模上,国内产品似乎仍落后一步——例如,率先推出文心一言的百度有100亿参数、华为盘古大模型使用1000亿参数。不过,过去的几个月,陆续加速布局大模型的国内公司却如雨后春笋,其中包括阿里的通义大模型、腾讯的混元大模型、科大讯飞的讯飞星火、京东的ChatJD等等。
从目前国内推出的几款大模型产品来看,我们似乎仍在等待和寻找自己的“iPhone时刻”。无论是百度的文心一言、华为的盘古大模型,还是科大讯飞的讯飞星火,似乎仍停留在从自己原本的优势入手的“集大成者”,相对缺少更多的创新。
像是以搜索引擎为所长的百度,推出了类似GPT-3这样具备搜索属性的文心一言。
华为的盘古大模型则更加专注于自己比较有优势的TO B业务。在发布会上,华为也表示,在过去的2022年,华为盘古大模型主要是AI for Industry(AI赋能产业),为煤矿、水泥、电力、金融、农业等行业创造了更多产业价值,其中CV大模型早就有了许多用武之地。
比如在与能源公司合作的盘古矿山大模型案例中,矿井现场是一个40米长的采掘机,宽度仅2米左右,传统相机很难一下子捕捉到全部画面,只能用图中的九宫格视频画面。而通过5G+AI全景视频拼接综采画面卷,传输到地面,地面工作人员将来可以实现地面控制机器进行采矿,实现矿下无人、少人安全作业。
科大讯飞则是在深度神经网络算法方面拥有丰富经验,尤其在语音识别和图文识别方面水平过硬,其讯飞火星的体验页面,就包含语音合成、听写、翻译、文字识别等功能。

图源:讯飞星火体验页面
艾瑞咨询曾在报告《ChatGPT浪潮下,看中国大语言模型产业发展》中讨论过中外大模型研发的差距,其中表示,“对百度等国内大厂而言,则在数据、算力、工程化能力等关键要素上存在短板,短期内难以对国外领先大模型实现赶超,为跟随者角色,长期更需要国内AI全产业链整体进化。”
要补充短板,一个重要的因素,就是人才。因此,大厂也都纷纷行动起来。
BOSS直聘上,百度、腾讯、阿里、蚂蚁集团等纷纷发布了相关岗位的招聘信息。其中,百度以25-40k/月招聘AI大模型算法工程师、20-40k/月招聘模型构架工程师;蚂蚁集团以45-75k/月招聘深度学习大模型GPT工程师;阿里以40-70k/月招聘大模型训练及算法工程师;腾讯则以30-60k/月招聘大模型预训练方向的工程师… …
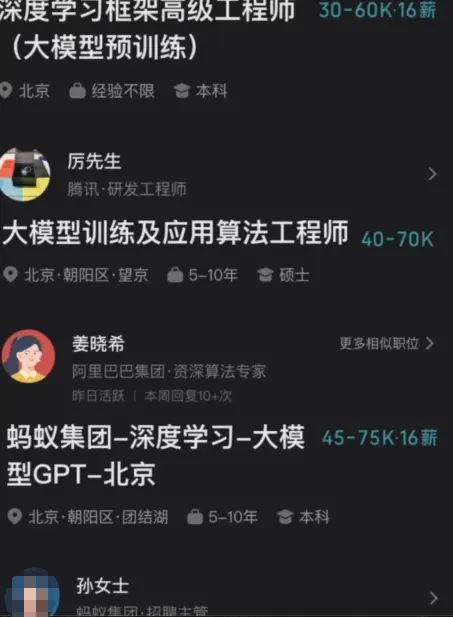
部分大模型招聘信息。图源:BOSS直聘
值得注意的是,这些岗位几乎都在一日内被回复了超过10次,负责招聘的联络人也几乎都是“正在活跃”的状态。由此可见,求职者对于大模型相关岗位充满信心,且招聘者也正在如火如荼地争夺人才。
而从脉脉发布的《AIGC⼈才趋势报告》中可以看出,自Open AI推出的2021年以来,对于AIGC相关的人才争夺就已经开始了。2021年1-2月,AIGC相关岗位招聘同比上升281.88%,而后的2022年和今年的1-2月,招聘数量分别保持了76.74%和31.3%的同比增幅。

图源:脉脉《AIGC⼈才趋势报告》
这些招聘中,纯互联网大厂占比超过33%,处于人才争夺的主导位置。而且,大厂并不吝啬给钱,图像识别、深度学习、算法研究工程师的平均年薪超过了100万元人民币。
不过,在具体的岗位需求上,目前国内大模型相关人才的供需出现了部分偏差。从招聘者的角度而言,大厂们最紧缺的是算法工程师、自然语言处理、算法研究员等技术人员;而从求职者角度而言,大家投递最多的简历倾向于产品经理、用户运营等后端岗位。这能从侧面反应两个问题:其一,目前大模型技术相关人员仍是供不应求;其二,目前大厂们对大模型的布局仍侧重于技术研发,而非市场推广。

图源:脉脉《AIGC⼈才趋势报告》
此外,相较国外,目前国内大模型人才的学术背景似乎也略逊一筹。比如,在AIGC相关人才的学历背景中,本科和硕士占据了几乎90%,博士生占比仅4%。相比之下,由科技情报分析机构AMiner和智谱研究发布的《ChatGPT团队背景研究报告》显示,ChatGPT研发团队中,本科、硕士和博士的占比分别为33%、30%、37%。

图源:脉脉《AIGC⼈才趋势报告》
诚然,人才的争夺只是第一步,对不少大厂来说,积极投入研发的最终意义是赚钱。而大模型目前的商业化分成了C端与B端两个路径方向——对于C端来说,以GPT为例,通过开源方式将用户和数据引进来,再逐渐转化成订阅制;而就B端而言,比如Open AI与微软Azure的合作,间接实现“模型即服务”,小B开发者可以调用其大模型API。
商业模式上,ChatGPT已经明确指向API、订阅制和战略合作(嵌入微软Bing、Office等软件)三种营收方式,且已在用户数据积累、产品布局和生态建设层面充分领先;Google虽有意追赶,但由于聊天机器人这样的产品形态对于其主营的搜索引擎业务的助益有限,因此在与搜索引擎结合方面较为审慎,更希望借助大模型能力开展“模型即服务”范式,开拓其当前市占率较低的云服务业务的市场空间。
国内大厂也几乎是在这两条路上摸索。比如百度的文心一言更倾向于C端市场的探索,而“文心千帆”产品则剑指B端市场,意图进一步带动云服务营收。
不过无论是靠哪一条“腿”走路,想要实现商业化,大模型产品仍需要解决几个紧迫的问题。
比如,信息准确性。科技行业投资观察员林允告诉价值星球:“大模型所输出的内容准确性其实绝大部分取决于其底层数据的质量。我自己在测试了国内某厂推出的类GPT产品后,最大的感触是,底层数据质量还是有一定差距。”林允还补充道,用中文训练模型相较于英文也是没有语言优势的。
但是,消费者不会体会研发者的难处,一旦产品开启订阅制,用户就会对产品输出的内容要求极其严苛。免费使用的时候,用户还能将错误反馈当成吐槽的笑话,但收费之后,这些错误可能就成了投诉的理由。
除此之外,在目前大模型较多应用的文字和图形创作上,如何保证原创性也成了一个关键问题。一位AI从业者就表示,以AIGC为例,目前很多AIGC系统仍缺乏创造力,甚至不能独立生成原创内容,只能根据给定的模板或者指导生成相关内容。而这可能会牵扯原创的道德问题,以及更实际的,涉及版权资金的问题。
最重要的是,大模型由于所需要的数据规模巨大,因此对算法、算力、数据存储空间都有极大的要求,而这些不止是人才可以弥补的,还需要大量的资金。要知道,Open AI的成功也是微软当初用数十亿美金堆出来的。巨大的资金需求,对大厂的研发决心也是一种考验。
但毋庸置疑的是,大模型已经开始改造很多应用场景。林允就表示,“以ChatGPT为例,它将会彻底改变人们工作的方式,所以不论是搜索引擎为主的百度,还是发展云业务的阿里、腾讯、华为,大厂们对大模型的探索是无法阻挡的大势所趋。只是进展和成效如何,要边走边看。”
*文中林允为化名
作者:沙拉酱;编辑:麻吉
来源公众号:价值星球Planet(ID:ValuePlanet),发现公司价值,讲述资本故事
本文由人人都是产品经理合作媒体 @价值星球Planet 授权发布,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。