


当AI能力的竞争从“军备竞赛”转向“效率革命”,一家中国公司正用开源和十倍成本优势,将顶尖AI从“神坛”拉入“寻常百姓家”。这不是一场单纯的技术升级,而是一次对行业商业模式的降维打击
在互联网圈子里混久了,大家对“不可能三角”这个词肯定不陌生。什么“好、快、便宜”你最多只能占两样,这几乎成了做产品的铁律。说实话,这个魔咒在AI领域更邪乎,高性能、高速度、低成本,这三样东西长期以来就像是三座遥遥相望的山峰,谁都想同时登顶,但谁都没做到
大模型的能力越来越强,参数量从千亿卷到万亿,上下文长度从几千token拉到上百万,看起来很美。可你问问哪个开发者,哪个创业公司,心里不是一边流口水一边算账。顶尖模型的推理成本,就像个无底洞,用得越多,烧钱越快。这就导致一个很尴尬的局面:最牛的AI能力,成了少数巨头的专属玩具,我们这些普通开发者和中小企业,只能眼巴巴地看着,或者用一些“丐版”模型凑合
就在大家快要默认这个规则的时候,DeepSeek V3.2突然冒了出来。它扔出的那句话,在我看来简直是往平静的湖里扔了个深水炸弹:“推理能力比肩GPT-5,成本仅为三分之一”。我第一反应是不信,这不科学,怎么可能。这就像有人告诉你,他造了辆跑车,性能堪比法拉利,油耗却跟电动车一样低。这背后到底藏着什么魔法,它又会给整个行业带来什么样的震动,这事儿,值得好好聊聊
聊DeepSeek V3.2,绕不开它的核心技术:DSA,全称DeepSeek Sparse Attention。我知道,一听技术名词很多人就头大,但你别把它想得太复杂。在我看来,这玩意儿的精髓不是炫技,而是从根子上重新定义了“成本”这个概念
以前的注意力机制,就是那个让Transformer模型封神的玩意儿,它有个致命的毛病——太“重”了。它的复杂度是 O(n²) ,n是文本长度。这是什么概念?就是你处理的文本长度翻一倍,计算成本可能就翻四倍,呈指数级飙升。所以你看,为什么处理长文档、分析整个代码库那么贵,根子就在这儿。它就像一个阅读能力超强但有点笨的阅读器,为了理解一句话,非要把整本书每个字都跟其他所有字挨个比对一遍,效率能高才怪
DSA的思路就“巧”多了。它不像老方法那样蛮干,而是模拟了人看书的方式。你想想,你看一篇长文章,是不是先快速扫一眼,找到重点段落,然后再仔细读这些重点。DSA干的也是这个事。它搞了个“闪电索引器”,先用极低的成本对全局信息进行一次快速扫描,识别出哪些部分是关键信息,然后再把计算资源集中火力,精准地聚焦在这些关键部分上。这么一来,复杂度直接从指数级的 O(n²) 降到了线性的 O(n) 。文本长一倍,成本也就增加一倍左右,这一下就把成本的“拦路虎”给搬走了
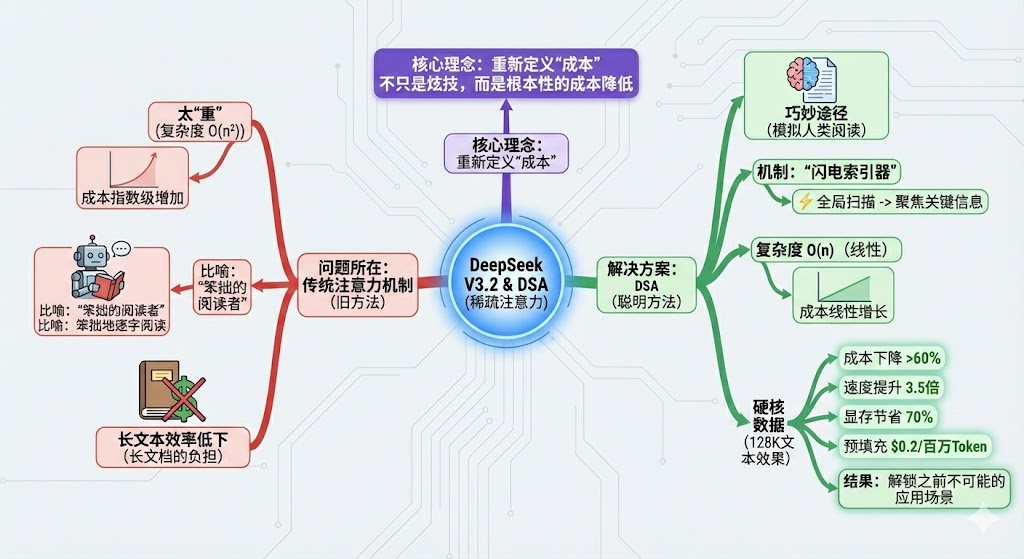
光说理论没意思,咱们看数据。官方给出的数字很硬核:处理128K长度的文本,成本直接下降60%以上,速度提升3.5倍,显存占用节省70%。更吓人的是预填充成本,直接干到了0.2美元/百万token。这些冷冰冰的数字背后,翻译成大白话就是:以前你觉得贵得离谱、想都不敢想的应用场景,现在可能真的玩得起了
技术上的突破,如果不带来商业模式的改变,那它的意义就少了一大半。DSA带来的成本下降,在我看来,正在触发一场“成本裂变”,它会把AI从“算力奢侈品”的位置上,硬生生拽下来,变成像水电煤一样的“AI基础设施”。这个过程,会从三个层面彻底改变游戏规则
先说对我们这些创业者和中小企业。以前搞AI创业,门槛太高了,你得先有钱,很多很多的钱,去买算力,去调用昂贵的API。这导致AI创业成了“资本密集型”的游戏。现在呢?当顶尖模型的调用成本变得跟普通模型差不多,甚至更低的时候,创新的门槛就被夷为平地了。比拼的不再是谁的钱包更鼓,而是谁的创意更好,谁对场景的理解更深。AI创业,正在回归它应有的样子——“创意密集型”
再说对应用层。过去有很多“重度场景”,大家明知道有巨大价值,但就是不敢碰,因为成本算不过来。比如,让AI完整阅读并理解一个几十万行代码的复杂项目,然后帮你定位bug;或者把公司几年的财报、会议纪要、邮件全都喂给它,让它成为一个无所不知的智能助理。这些场景因为成本太高,一直停留在PPT里。现在,成本的枷锁一旦解开,这些“重度应用”就变得经济可行了。我敢说,很快就会有一大批我们以前没见过的新形态SaaS和生产力工具冒出来
最后是对整个市场格局的冲击。DeepSeek V3.2这套“开源+低成本”的组合拳,打得太狠了。它直接把闭源的巨头们逼到了墙角。你要么跟着降价,但这样一来你的高利润就没了;要么你就得拿出更牛的东西来证明你的高价是合理的,这就逼着你加速创新。同时,那些云服务商也坐不住了,他们原来基于闭源模型搭建的AI服务定价体系,可能要被彻底重构。整个市场的竞争逻辑,正在从“我有你无”的资源战,转向“我比你优”的效率战
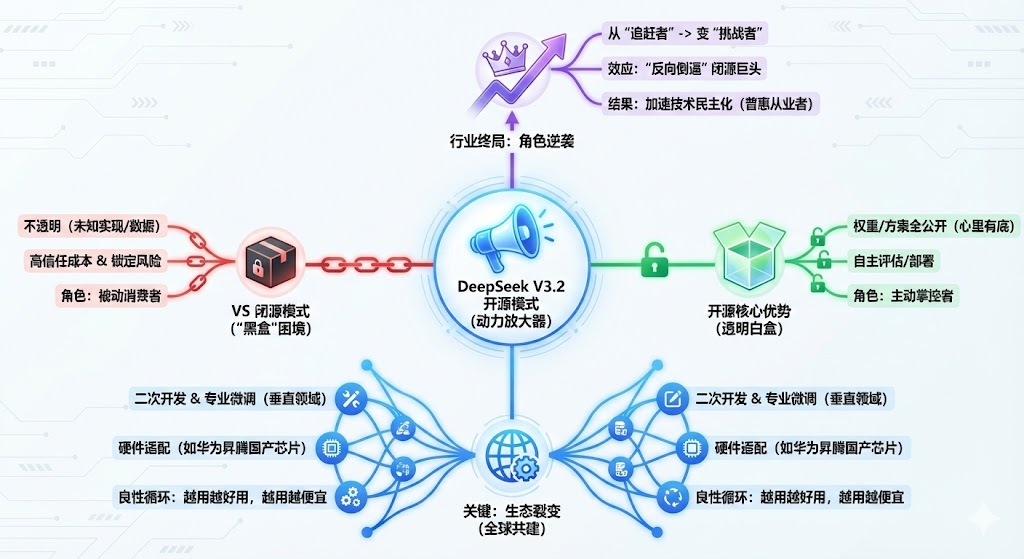
如果说DSA技术是成本革命的引擎,那开源模式就是把这个引擎动力无限放大的“放大器”。没有开源,DeepSeek V3.2的冲击力至少要减掉一半
为什么这么说?你想想,闭源模型是什么?它是个“黑盒”。你只知道它效果好,但它怎么实现的、训练数据是什么、为什么有时候会“发疯”,你一概不知。这种不透明,本身就带来了巨大的“信任成本”和“锁定风险”。你用惯了它的API,万一它哪天涨价或者服务调整,你就很被动
开源就不一样了。它把权重、方案全都给你看,明明白白。企业可以自己拿去评估,自己部署,心里有底。这种透明和信任,是花多少钱都买不来的。它让你从一个被动的API消费者,变成了一个主动的掌控者,这大大降低了被供应商“锁定”的风险
更关键的是生态。一个模型开源之后,它就不再是一家公司的事了,而是全世界开发者的事。全球的开发者会基于V3.2去做各种二次开发,去微调出各种垂直领域的专业模型,去适配各种各样的硬件。就像文档里提到的,对华为昇腾这些国产芯片的适配,社区的力量远比一家公司要强大得多。这个过程,会进一步降低模型在特定场景下的部署和定制成本,形成一个“越用越好用,越用越便宜”的良性循环
所以你看,开源模型正在完成一个角色转变。以前它们是跟在闭源巨头屁股后面的“追赶者”,现在,它们凭借成本和生态优势,变成了发起挑战的“挑战者”。这种“反向倒逼”的效应,正在迫使整个行业不得不加速技术的民主化进程,这对我们每个从业者来说,绝对是好事
聊到这里,感觉AI普惠的时代真的要来了。这扇门一旦打开,机遇是巨大的,但水面之下的暗礁也得看清楚
未来的趋势,我觉得有几个方向很明显。一个是“模型即服务”会慢慢变成“能力即组件”。AI能力会像水电一样,便宜、好用,被无缝地嵌入到各种互联网产品里,你甚至感觉不到它的存在。另一个是边缘AI的崛起。模型成本降下来,体积变小,就更有可能被部署到手机、汽车甚至各种物联网设备上,实现真正的无处不在的智能
当然,最大的机遇,还是会催生一波新的应用创新潮。每一次基础成本的断崖式下跌,都会释放一波巨大的创造力。就像4G和智能手机的普及,催生了移动互联网的黄金十年。现在,AI的成本门槛被打破,开发者们的想象力会被彻底解放,会做出什么样的新东西,我非常期待
不过,挑战也同样现实。首先是可持续性问题。开源项目怎么赚钱,怎么保证团队能长期、高质量地维护和迭代下去,这是一个世界性难题。其次,当基础大模型的能力趋同,而且都变得很便宜之后,竞争的焦点就不再是模型本身了。大家拼的会是什么?是对数据的理解、对垂直场景的深耕、是产品体验和商业模式的创新。这对产品经理和创业者提出了更高的要求
还有一个更宏观的问题,就是AI普及化带来的社会责任。当AI的能力变得如此强大又如此廉价,它可能带来的安全风险、伦理问题、对就业的冲击,都会比我们想象的来得更快、更猛。这些问题,不再是几个科学家或者几家大公司需要思考的,而是整个社会都需要去面对和治理的
说了这么多,回到最初的那个点。DeepSeek V3.2这场“成本革命”,它的里程碑意义,在我看来,不只是证明了中国AI的技术创新能力,更重要的是,它代表了一种新的发展范式——一种以效率、开放和普惠为核心的范式
过去,我们总觉得最强大的AI,就是参数最多、能力最强的那个。但现在,我越来越觉得,一个真正强大的AI,应该是能被最多人使用、能解决最多实际问题、能激发最多创新的AI。从这个角度看,平民化的AI,才是真正强大的AI
对于我们这些身处其中的互联网从业者来说,这意味着一个新时代的开始。那个高高在上、遥不可及的顶尖AI,正在变成我们每个人手中触手可及的新杠杆。如何用好这个杠杆,去撬动我们想要改变的世界,这可能是接下来几年里,最激动人心的一件事。
本文由 @饼屋 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。