


在ChatGPT出现之后,AI人工智能技术的发展又迎来了新的热潮,许多玩家也随后推出了大模型,那么,人类是否已经站在了AGI大门的边缘?未来GPT-5的出现,又可能会给人类和行业带来哪些影响?一起来看看作者的解读。
从ChatGPT问世至今,AI就在以月为单位飞速进化着,其模型之多,迭代之快,让很多人不不禁惊觉:人类似乎真的站在了AGI大门的边缘。
而最近,美国专利商标局 (USPTO) 披露的一份文件显示:OpenAI于7月18日提交了「GPT-5」的商标申请。并且已经被接收。
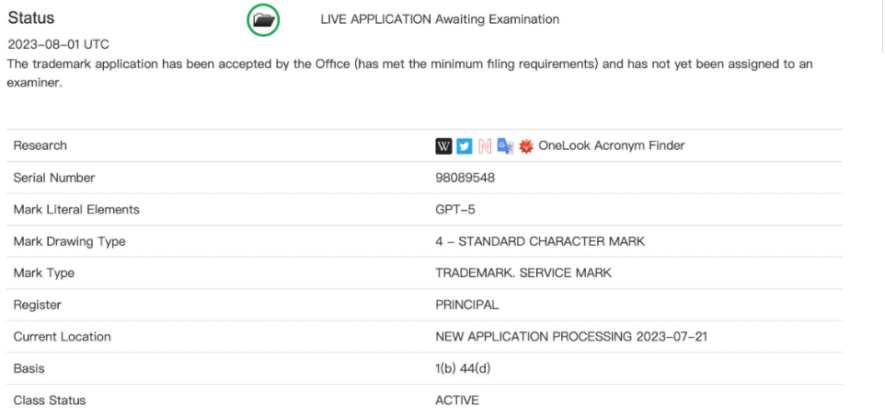
USPTO 文件截图
尽管在今年上半年,各个AI专家、学者已经多次联合发表公开信,呼吁人们重视生成式 AI 的潜在风险,而OpenAI当时也宣布短期内不会有训练GPT-5的计划。
然而,科技的诱惑,终究还是让人类打破了禁忌的边界。
在这次披露的申请书中,OpenAI提到,尚未发布的GPT-5将具备众多GPT-4所没有的能力,而且几乎每一项都剑指AGI。

USPTO 文件截图
那么,这样的改变,对AI和人类而言,又意味着什么?
今天,本文就将尝试从OpenAI的申请文件中披露的有限信息,对GPT-5可能的功能、变化,及所造成的影响,进行一番简单的剖析。
在此次披露的文件中,OpenAI最先提到的一个变化,就是多模态功能的加强。
具体来说,GPT-5 的功能包括把文本或语音从一种语言翻译成另一种语言、语音识别、生成文本和语音等。
虽然在现在的GPT-4中,用户同样可以实现不同语种间的翻译,但既然翻译功能在这里被单独挑出来,想必是重新优化过了。
那OpenAI为何会如此突出GPT-5的翻译能力?
这或许是因为,GPT走向通用的前提之一,就是尽可能缩小不同语言使用大模型的成本差距。
此前,牛津大学的研究成果显示,由于 OpenAI 等服务所采用的服务器成本衡量,和计费的方式的不同,英语输入和输出的费用要比其他语言低得多。
其中简体中文的费用大约是英语的两倍,西班牙语是英语的 1.5 倍,而缅甸的掸语则是英语的 15 倍。
因为像中文这样的语言有着不同、更复杂的结构,导致它们需要更高的词元化率。
例如,根据 OpenAI 的 GPT3 分词器 ,“你的爱意(your affection)” 的词元,在英语中只需要两个词元,但在简体中文中需要八个词元。
这意味着,除了英语之外的其他语言,使用和训练模型要贵得多。
而一旦翻越了“语言障碍”这道槛,无疑会直接地扫清横亘在GPT面前的这条通用性障碍。
除此之外,文件中突出的语音识别功能,看似只是一个不起眼的改动,但从某种程度上说,这也是OpenAI对GPT-5在通往AGI的道路上铺下的又一块路砖。
众所周知,在今后的大模型发展方向上,模型变得边缘化、终端化,已经成了一个愈发明显的趋势。
自从今年7月,高通发布了能在手机上运行的10亿参数大模型后,荣耀、苹果等厂商,也相继宣布要推出自身的“大模型”手机。
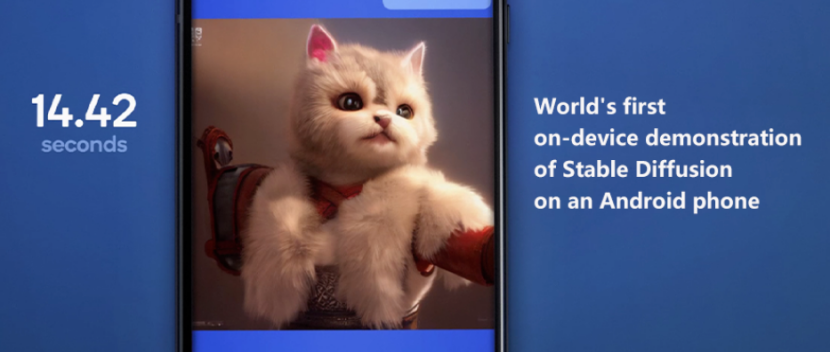
以手机为起点,将来的AI数据,将会越来越多地在摄像头、传感器、自动驾驶等终端侧进行处理。
而在这样的应用场景中,语音识别无疑更便捷、高效。
例如,AI语言模型可以让驾驶员可以通过语音控制车辆行驶。将驾驶员的语音指令转化为可执行的指令,例如启动、停止、加速、刹车等操作。
而类似于SIri那样存在于手机系统中的智能助手,也会优先考虑通过语音指令来进行控制。
由此可见,语音识别并非只是锦上添花,而是GPT-5进入终端侧的“标配”,而通过在这一个个终端设备的下沉,GPT-5也将由此获得更多边缘化的、非语言的数据结构。
毕竟,大模型发展至今,能汲取的文本数据,已经差不多了,要想在通往AGI的路上再上一个台阶,这种“非文本”的数据,就显得至关重要。
除了上述特点外,OpenAI提交的文件中还提到:“GPT-5 可能还具备学习、分析、分类和回应数据的能力”。
从目前人工智能的发展趋势来看,这很可能是指GPT-5具备了类似智能体的主动学习能力。
而这样的能力,将会使GPT-5与以往只能被动地通过人类投喂数据,来学习新知识的模型相比,产生本质的区别。
具体来说,主动学习的能力,是指模型可以根据自身的目标和需求,自主地选择、获取和处理数据,而不是仅仅依赖于人类提供的数据。
这样可以让模型更有效地利用数据中的信息和知识,更灵活地适应不同的数据环境和任务场景,而不只是被动地接收和输出数据。
而这样的能力,在GPT-5面临一些比较陌生、垂直的领域时,就显得尤为重要。
一些特定的领域,比如医学、法律、金融等,通常有着自己特定的术语、规则和知识体系,对于普通的语言模型来说,可能难以理解和处理。
如果GPT-5具备了主动学习的能力,它可以自动地从网络上搜集和更新这些领域的相关数据,分析和分类这些领域的基本概念、重要原理和最新动态,以及回应这些领域的常见问题、典型案例和实际应用。
如此,可以让GPT-5更快地掌握这些领域的专业知识,更准确、高效地完成这些领域的相应任务。
而这一切,正是其迈向真正的通用大模型的关键。
因为如果GPT始终需要接入特定的“专家模型”,才能解决专业任务,那它就谈不上真正的“通用”。
因为这样会导致GPT对于不同领域和场景的智能能力存在差异和依赖,而且也会增加GPT与“专家模型”的沟通和协调成本,而不能保证在任何情况下都能实现高质量的服务。
此前,外媒 Semianalysis 就对今年3月发布的GPT-4进行了揭秘,曝光了OpenAI采用混合专家模型来构建GPT-4。
根据爆料,GPT-4 使用了16个混合专家模型 (mixture of experts),每个有 1110亿个参数,每次前向传递路由经过两个专家模型。
然而,更多的专家模型意味着更难泛化,也更难实现收敛。
这是因为每个专家模型都有自己的参数和策略,往往很难协调一致,进而使得GPT难以平衡和“顾全大局”。
而在具备了主动学习的能力后,GPT-5将有可能利用多模态的理解和推理能力,以及知识图谱和数据库,来分析和理解获取到的数据,并通过聚类算法和分类器,对相关数据进行关联和归纳。
如此,GPT-5就能根据不同的数据环境和任务场景,有效地利用数据中的信息和知识。
如前所述,在扫清了语言障碍,并以便捷的语音识别功能进入终端侧后,GPT-5将通过持续的主动学习能力,不断汲取不同场景、领域和模态下的知识,进而向着AGI的道路高速前行。
可以预见的是,当具备了这样强大“通用性”的GPT-5,开始向各领域扩散后,除了少数具有数据壁垒的行业(如医疗)外,大部分垂直领域的大模型,都将会逐渐黯然失色。
因为说到底,相当一部分专家或垂直大模型,本质上是某些企业算力、数据不足,无法高攀“通用大模型”,而不得不退而求其次的产物(这在国内尤为明显)。
倘若一个通用大模型,凭借强大的学习能力,就能够精通大部分行业,那谁又会愿意繁琐地在不同的模型之间切换,并为不同的模型承担多份训练、使用成本呢?
从这点上来说,专家模型逐渐被通用模型取代,是人类在通往AGI道路上一个不可避免的历史过程。
而与此相伴的另一个现象,则是更多细分的、琐碎的工作被取代。
因为在有了更强大的通用大模型后,人们将会发现,其实很多岗位的工作内容,是可以被合并、被统合的。
产品经理和数据分析师就是一个可能的例子。
例如,在一个新产品开发的项目中,GPT-5可以根据给定的产品概念或需求,从网络上搜索相关的市场调研、竞品分析、用户画像等数据,并下载到自己的内存中。
之后,它会通过自己的多模态的理解和逻辑推理能力,以及知识图谱和数据库,来分析和理解获取到的数据。
在得到了相应的数据,并将其进行分类和组织后,GPT-5就会通过语言理解能力,从对话系统的反馈中学习相关的营销策略、用户反馈等信息,并将其与给定的产品概念或需求进行比较和评估。
如此一来,产品经理和数据分析师这两个岗位,就被高效地“合并”了。
而在通往AGI的未尽之路上,这样被合并和取代的岗位,还有无数种。
因此,一个通用性更强的GPT-5,对人类而言,既是生产力进步的福音,但同时也是行业大地震的前奏。
到了那时,许多尚不具备通用大模型能力,又缺乏行业壁垒的企业,将会如沙子堆起的城堡一样,脆弱地倒下。
而更多普通的个体,面对不断被取代的岗位,将会更深刻地感受到时代的不确定性……
作者:举大名耳
来源公众号:AI新智能(ID:alpAIworks),一个致力于探索人工智能对商业世界和社会影响的平台。
本文由人人都是产品经理合作媒体 @AI新智能 授权发布,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。