


在RAG技术中,检索与召回是关键环节。本文深入剖析了检索的多重机制,包括关键词、向量、知识图谱检索,并探讨了影响RAG系统性能的核心工程指标,助力企业级检索架构的优化。
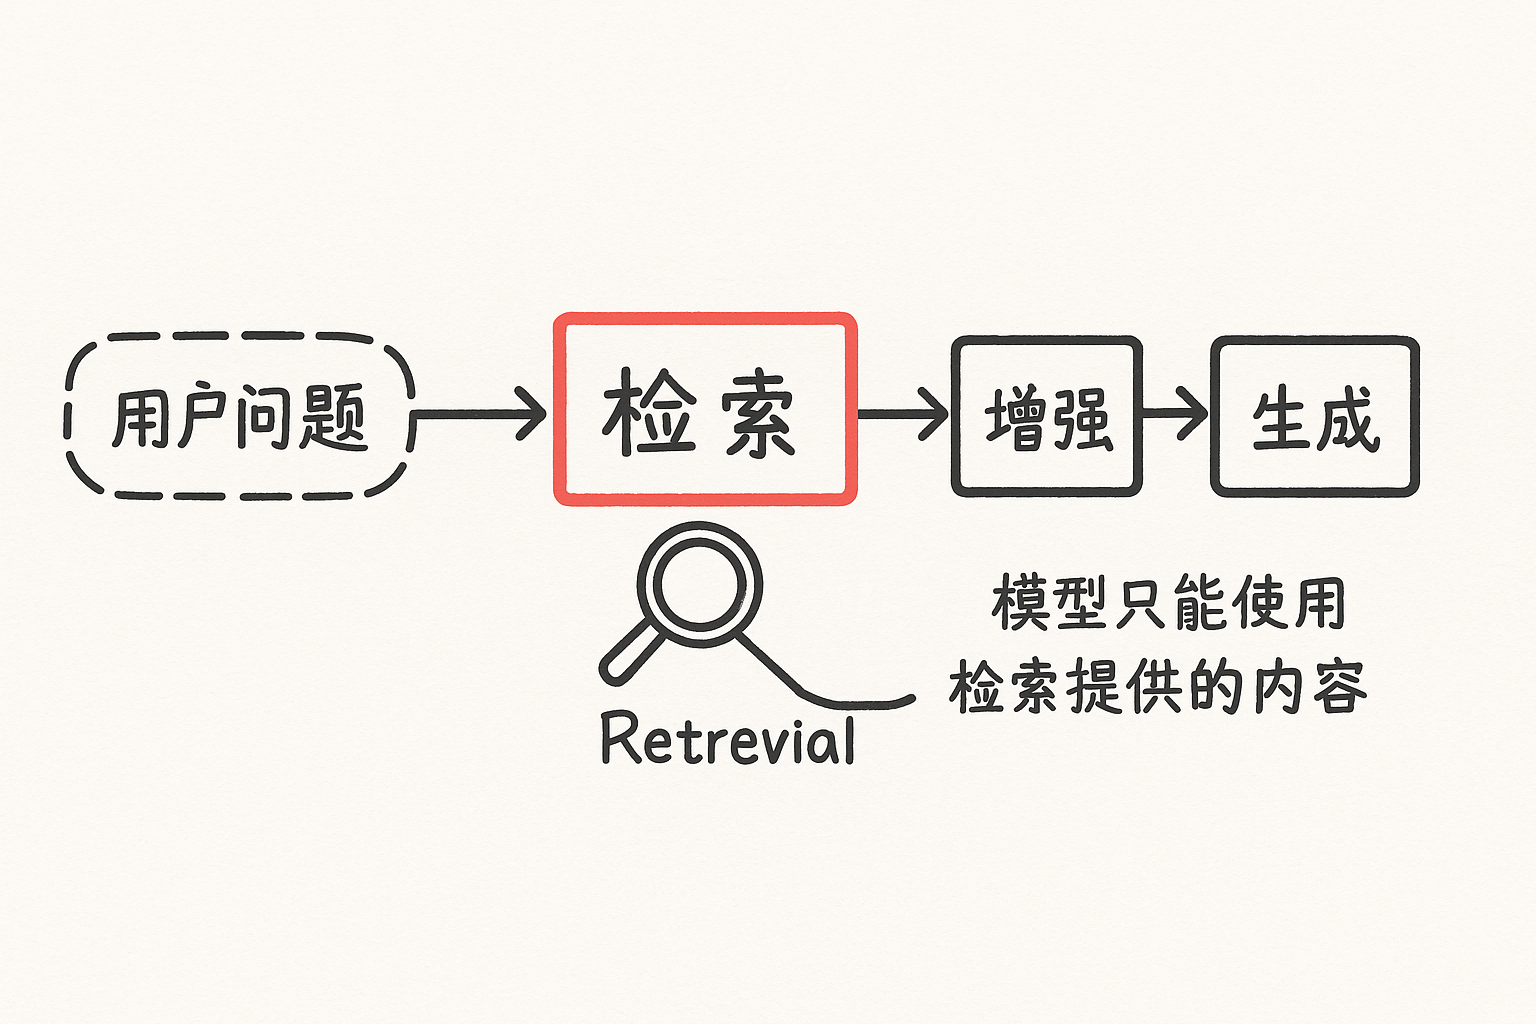
在上一期中,我们拆解了知识库构建的底层逻辑。本篇将进入RAG中最关键、最影响最终结果、也最容易被低估的部分:检索(Retrieval)与召回(Recall)。
在RAG中,模型不是在回答你的问题,而是在回答它所“看到的内容“,而这些“可见内容”完全由检索阶段决定。因此:
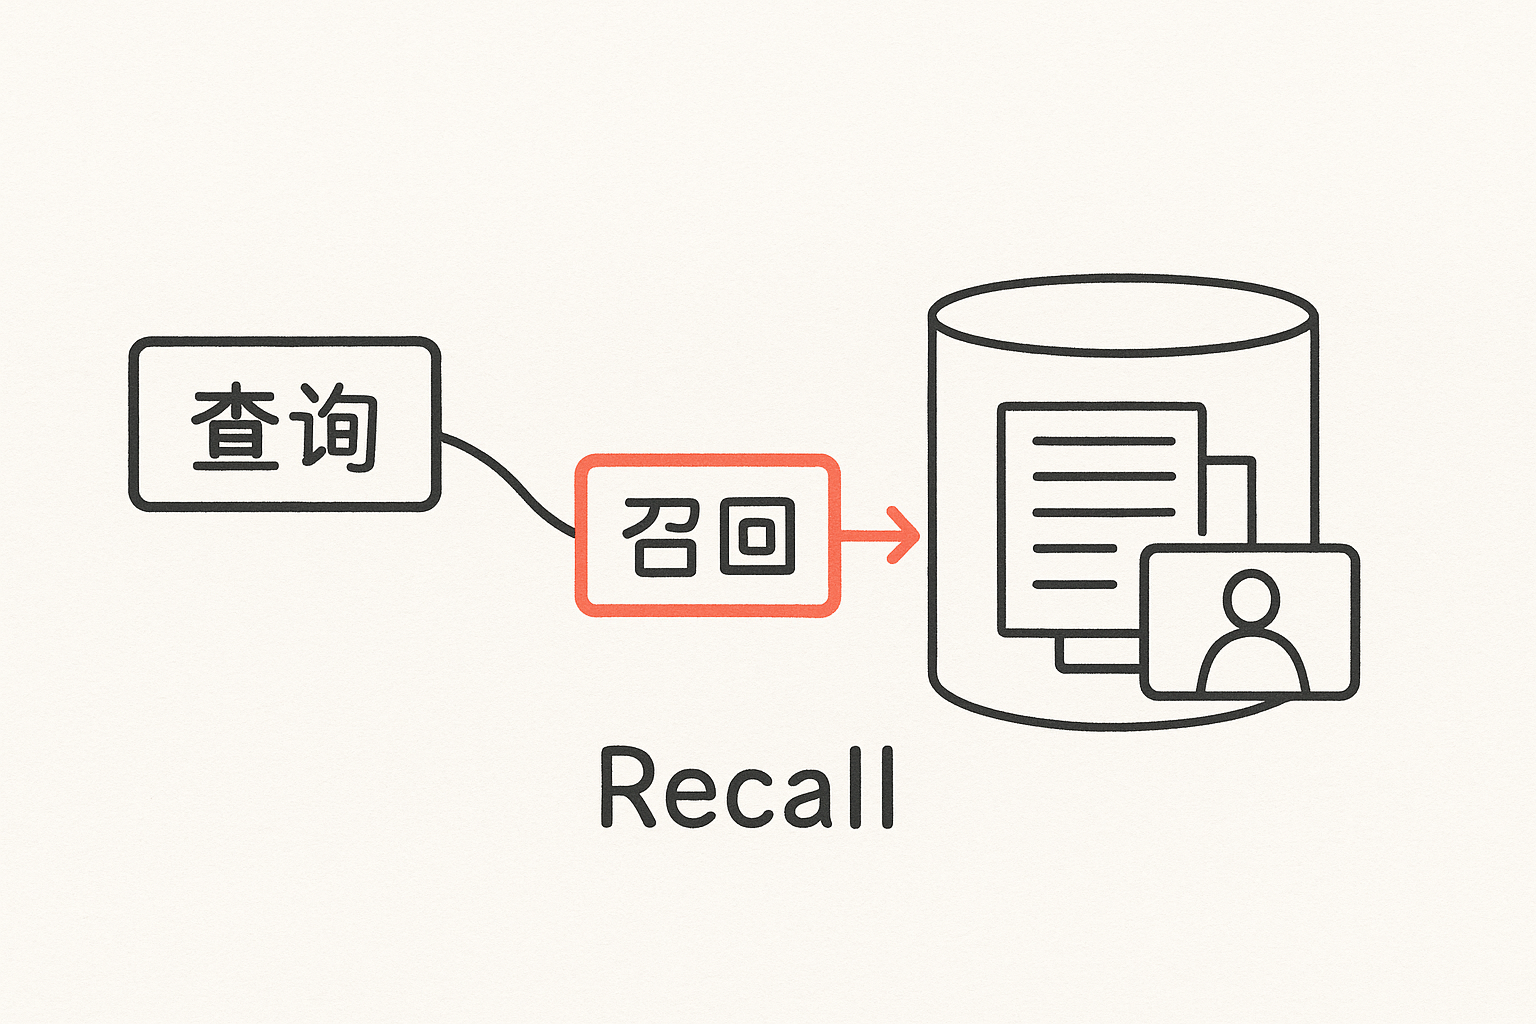
检索不是一个动作,而是一整套召回体系(RecallSystem)。
很多人理解的检索是“向量搜一下”“BM25 匹配一下”,但真实情况远比这复杂。在 RAG 中,检索系统需要同时满足:
检索真正的目标不是找到答案,而是:构建一个“大概率包含答案的候选集合”。
(具体名词解释在第三章)
为了让读者更容易理解,我们统一采用一个示例问题:“RAG 技术如何减少幻觉?”
下面对三种检索方式从“底层机制 → 具象例子 → 失败原因 → 解决方案”做系统讲解。
底层机制
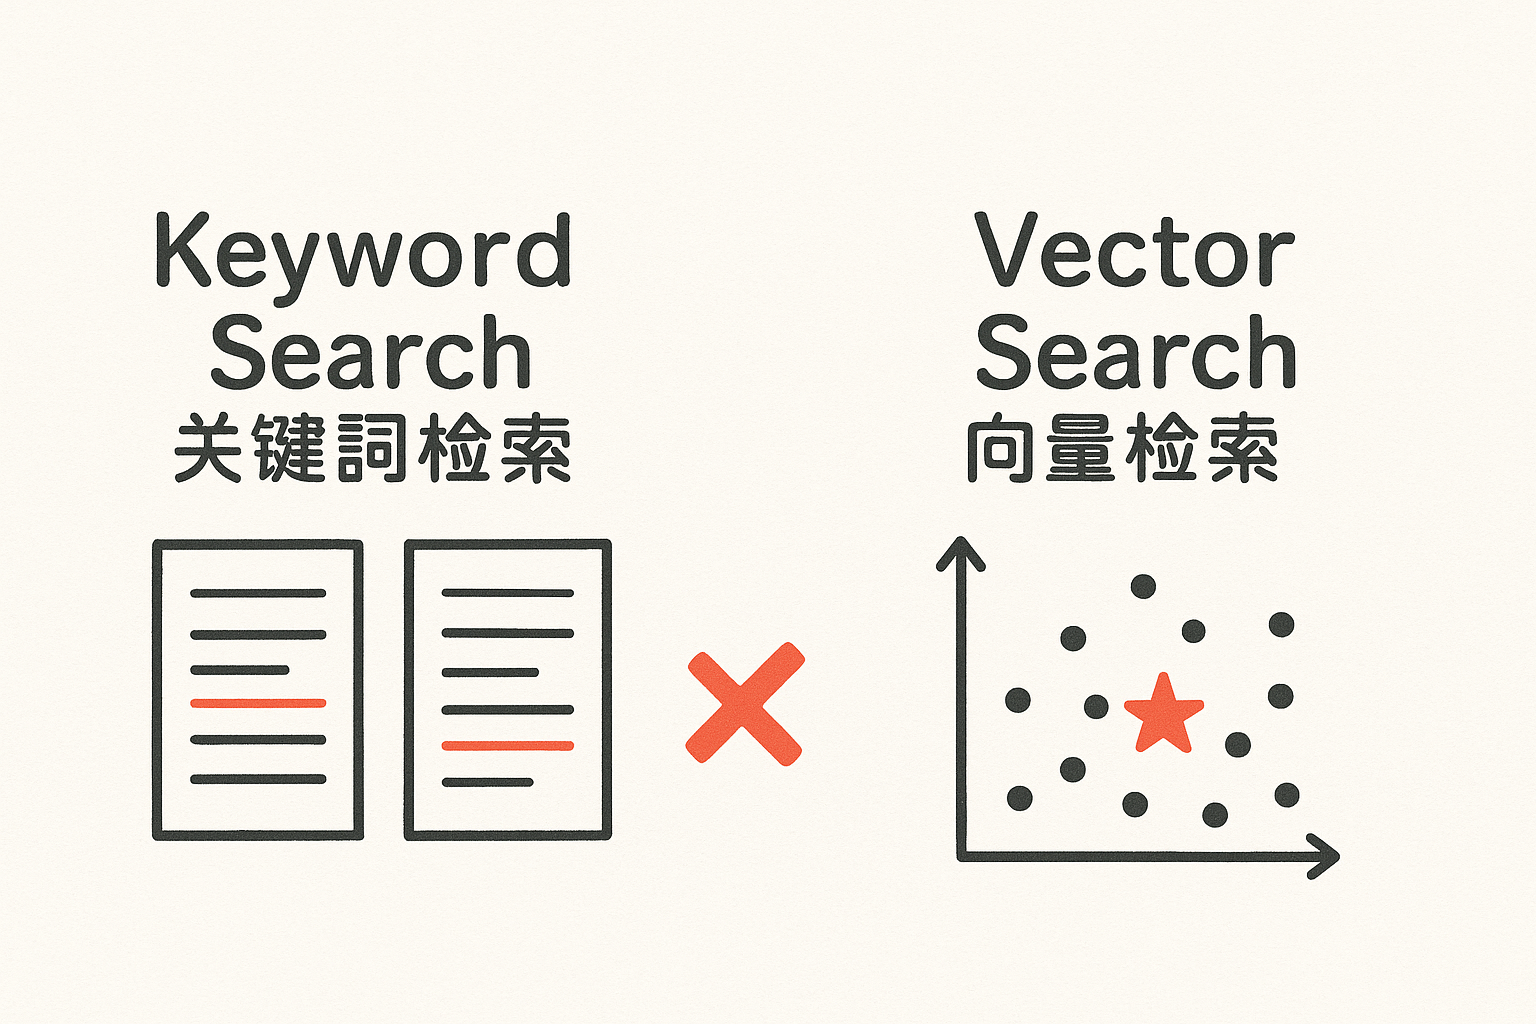
关键词检索(如 BM25)的数学本质是:将文本表示为高维稀疏向量,通过词项重合度与 IDF 进行评分。
它擅长处理:专有名词、技术概念、术语非常明确的领域(法律、API 文档)
例如 BM25 的计算:
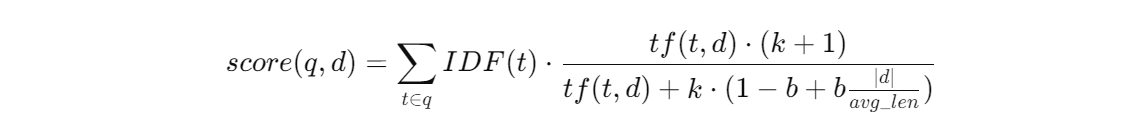
具象示例
用户问:“如何减少模型幻觉?”
文本 A 写:
“RAG 通过知识库降低幻觉风险。”
→ 匹配成功 文本 B 写:“提高事实性可减少错误内容。”
→ 因未出现“幻觉”二字 → 匹配失败
Sparse 检索完全依赖词项重叠,因此表达方式变化会导致召回失败。
为什么会失败?(底层原因)
1. 不理解同义词
2. 不理解语义
3. 用户表达方式与文档表达方式不一致
4. 内容语言风格差异大
解决方案
1. Query Expansion(同义词扩展)
2. Sparse + Dense 混合检索 3. 构建领域术语词典
底层机制
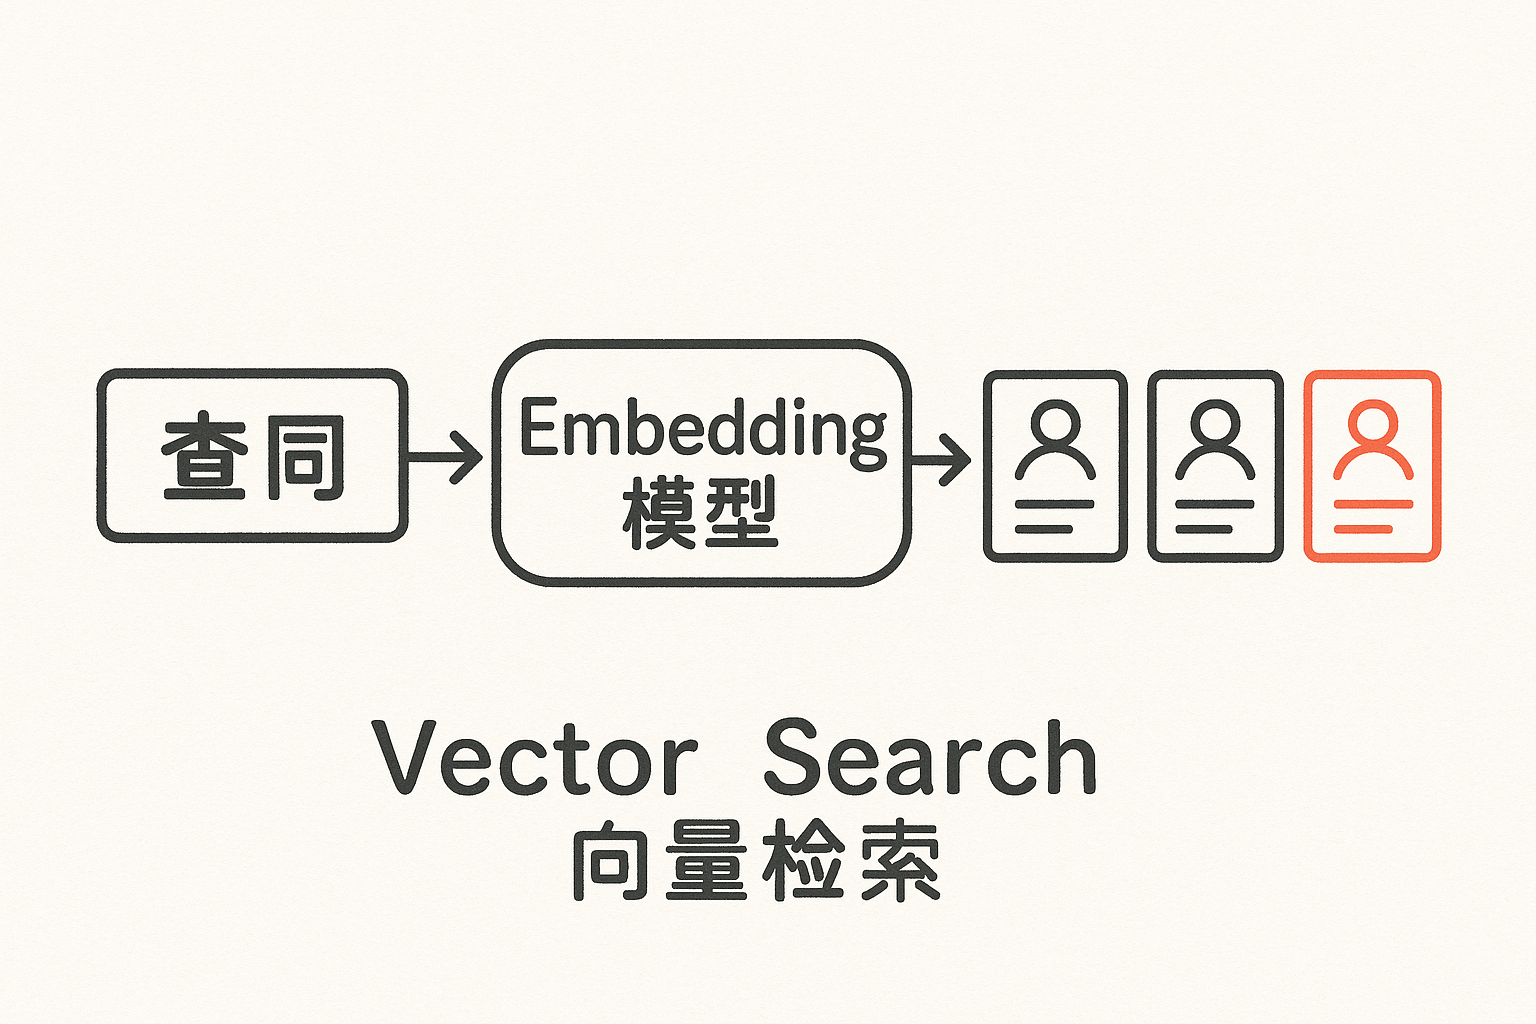
向量检索依赖 embedding 模型将文本压缩为向量:距离近 = 语义相似;距离远 = 语义不同。
embedding 的核心是“语义压缩”,它不看字面,而是看价值密度最高的语义特征。
具象示例
“减少幻觉” embedding ≈ “减少错误内容” embedding → 因为模型认为两者语义接近,因此能召回表达不同但语义相似的内容。
Dense 会失败的根本原因(非常关键)
1. embedding 会稀释关键信息:mean pooling 会把所有词平均化,重要术语的权重被淹没
2. embedding 的优化目标 ≠ RAG 的任务需求:它判断的是“语义是否相似”,不是“能否回答问题”
3. 向量排序不稳定:相似度差距极小 → Top-K 排名可能随机波动,导致关键文本被漏召
解决方案
1. Cross-Encoder rerank
2. Multi-query 扩展
3. 更强 embedding 模型
4. 语义分块(semantic chunking)
5. 增大 Top-K
底层机制
知识图谱由实体、关系、属性构成可计算图结构,支持多跳推理、逻辑链路扩展、邻域检索。
具象示例
图谱中可能存在:RAG → 引入知识库 → 增强事实性 → 减少幻觉
用户问“如何减少幻觉”,图谱检索可直接沿路径返回结果。
为什么图谱强但难落地?
1. NER(实体抽取)成本高
2. RE(关系抽取)难
3. 实体消歧复杂
4. 图谱维护成本高
5. 对领域理解要求高
解决方案
1. 图谱 + Dense 融合
2. 构建局部图谱(Local KG)
3. 半自动关系抽取
RAG 的绝大多数错误都不是模型造成的,而是检索阶段的问题。以下五大指标是系统能否稳定的核心。
为什么 Recall 会低?
1. embedding 忽略关键术语
2. chunk 切得太碎或切断语义
3. Top-K 排序不稳定
4. 用户/文档表达差异大
5. embedding 模型表达能力弱
提升策略
1. Sparse + Dense 融合
2. Query Expansion
3. 提高 Top-K
4. 语义分块
5. 更强 embedding 模型
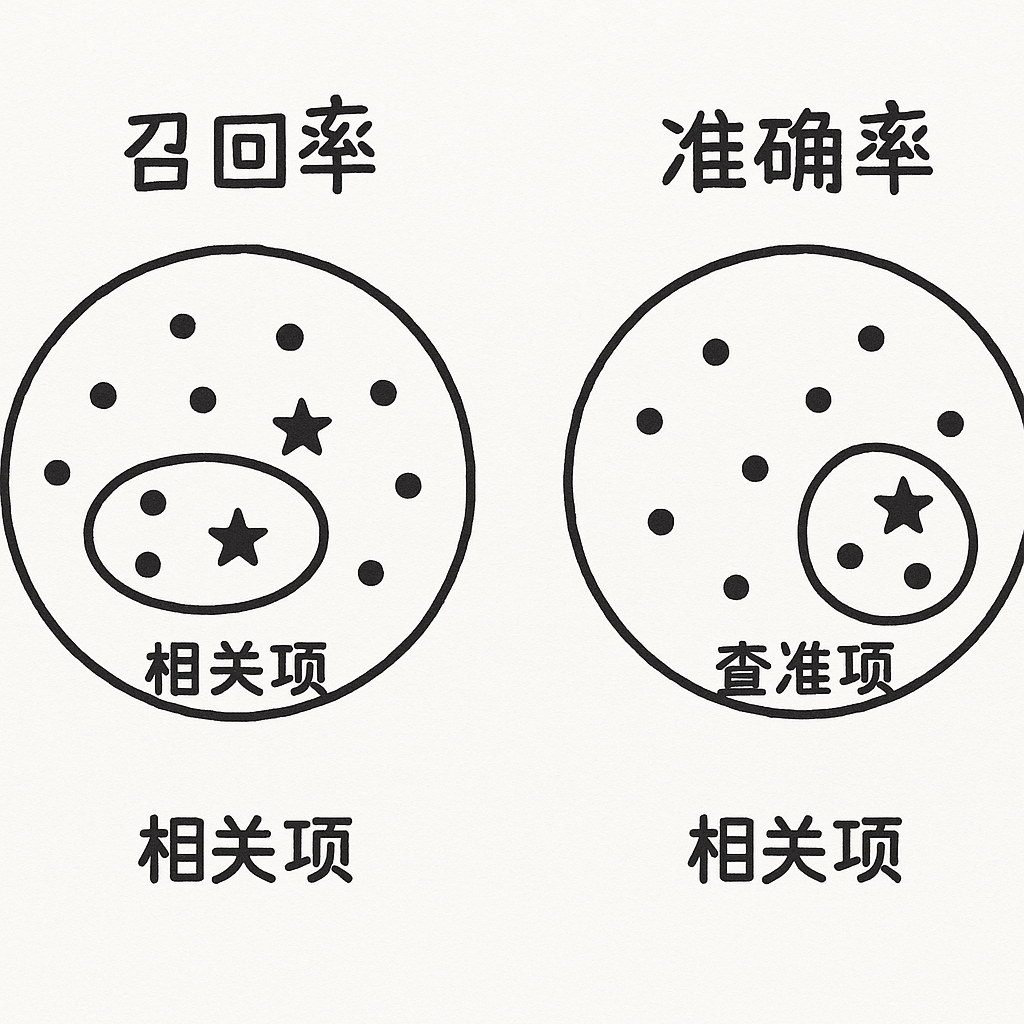
Dense 常召回“看似相关但无用”的段落——典型语义偏差。
Why?
1. 语义相似 ≠ 任务相关
2. Top-K 过大噪声暴增
3. chunk 过碎导致 embedding 歧义
提升策略
1. Cross-Encoder 精排
2. 控制 Top-K
3. 语义 chunking
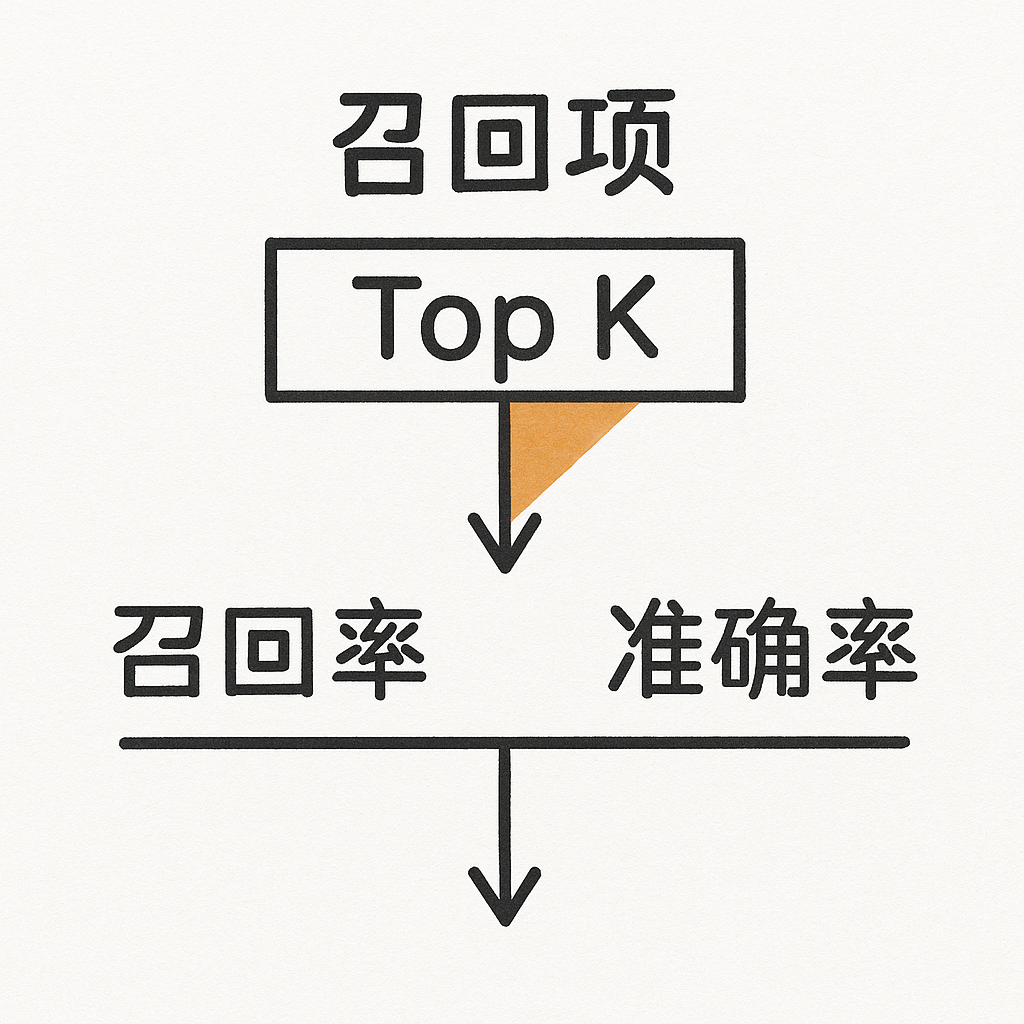
K 太小 → Recall 不够;K 太大 → Precision 崩溃。最佳方法是:“相似度断层法(score gap)”。
延迟来源包括:embedding 推理、ANN 向量搜索、rerank、IO。
优化方式包括:GPU embedding、HNSW 参数调优、缓存策略。
chunk 切错 = 整个 RAG 崩盘。
最佳策略:语义分块(自动分段)、20–30% 重叠、动态 chunk、术语优先策略。
几乎所有成熟产品都采用:
Sparse(术语召回)+ Dense(语义召回)+ Graph(逻辑推理)→ 合并候选 → Cross-Encoder 精排 → Top-K → 增强(Augmentation)→ 生成(Generation)
这是一种“分工明确、互相补足”的架构。
1. 检索不是搜索,而是构建“模型可用的候选集合”。
2. 召回率决定“能不能答对”,准确率决定“会不会答偏”。
3. Sparse / Dense / Graph 构建的是完全不同的相似性空间。
4. Top-K 是 RAG 效果最重要的旋钮。
5. Chunk 质量决定 embedding 上限。
6. 最终方案一定是多检索方式融合 + 精排。
RAG 的成功,70% 取决于检索,20% 取决于增强,10% 取决于模型。
(后续章节:增强/生成 待补充……)
本文由 @cheninx 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。