








AI产品的评测标准究竟应该由谁来定义?本文深度剖析AI客服项目中模型团队与业务方的评测标准之争,揭示现有评测体系的三大致命缺陷,并给出包含12项硬性指标和5大多轮对话维度的全新评测框架。从致命错误一票否决到多轮会话目标达成度,这套让业务能看懂、能扣分、能复现的评测体系,正在重新定义AI产品的成功标准。
一个 AI 功能到底什么时候算”做好了”?做 AI 产品的人,迟早会被这个问题绊一跤。
准确率?92% 听起来很高,但用户问十句答错一句,已经够投诉一整天的了。召回率?88% 看着也行,但漏掉的那 12% 如果全是用户最想问的高频问题呢?F1、BLEU、ROUGE?这些指标在 paper 里很漂亮,落到一个具体的业务功能上,没人能直接告诉你答案。
更扎心的是:模型团队拿着一张评测报告说”指标达标了,可以上线”,业务侧翻几条真实对话,第一反应是”这都能上线?”。两边都觉得对方不讲理,但谁也说服不了谁。
这件事的本质,是评测体系本身有问题——不是模型答得不够好,是这把尺子根本没量在用户真正在意的地方。
而评测体系这把尺子由谁定、量什么、怎么扣分,决定了你这个 AI 产品的天花板。
背景:最近在做 AI 客服项目,下面所有的例子都来自这个场景。但写出来的东西不限定于客服——任何需要”业务判断模型好坏”的 AI 落地项目,逻辑是相通的。
最近一批的标注表(单轮对话),标签TOP 5如下:
1、完美无暇 2、缺乏办理入口 3、答非所问 4、无效反问 5、模型拒答
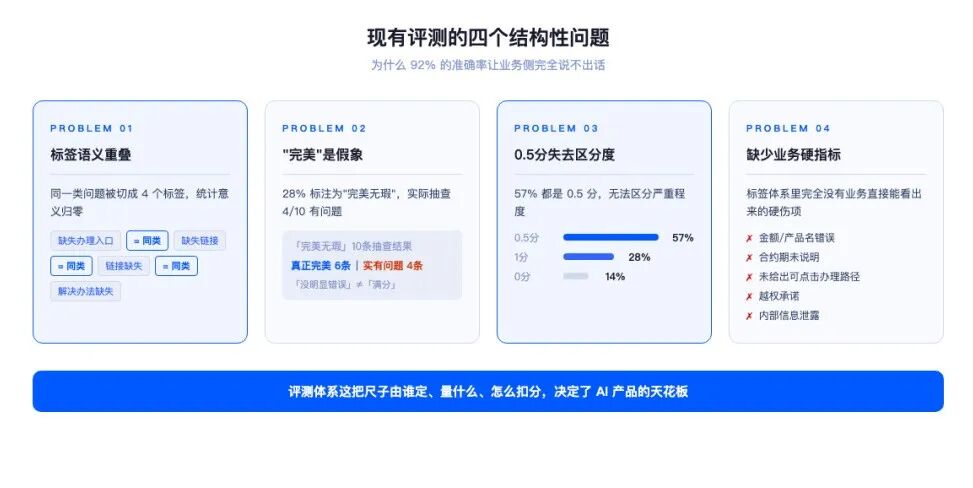
打分分布更夸张:0.5 分占 57%,1 分占 28%,0 分只占 14%。
我把看出的问题列了一下:
一、”完美无瑕” 28% 是假象。
我抽了 10 条所谓完美无瑕,至少 4 条都属于”没明显错误所以打满分”,但里面其实没说办理入口、没确认用户身份、用了”建议联系客服”这种甩锅话术。没扣分不等于满分。
二、0.5 分占 57% 等于失去区分度。
要么是 0.5(小毛病),要么是 0(明显错),评测没法告诉模型团队”哪些 0.5 比另一些 0.5 更严重”。
三、完全没有业务硬指标。
标签里没有 “金额/产品名错误” “合约期未说明” “未给出可点击办理路径” 这种业务一眼能看出来的硬伤项。
更要命的是多轮,整张表只有”回答效果 0/1″+”模型/数据/业务”三个原因桶。没有任何一个字段是多轮对话特有的——上下文继承了没有?指代消解对了没有?用户中途换意图认出来了没有?这些一个都没评。
所以我跟模型团队 battle 时其实很被动:他们说”按现有标准你看准确率多高”,我只能说”我感觉不太行”。“感觉”是赢不了”准确率”的。得换一把尺子。
我重新捋了一下,评测一条 AI 客服回复,本质上是在回答三个问题:
1)它说对了吗?
(事实正确性)
2)它解决问题了吗?
(任务完成度)
3)用户能不能立刻用上?
(可操作性 / 业务闭环)
这三层从下到上,越往上业务侧越在意。模型团队习惯只评第一层,所以才会出现”准确率高但业务不满意”的撕扣。
按照”难度 / 业务场景 / 客户问题 / 评估要点”四列建了一张测试集骨架和示例:
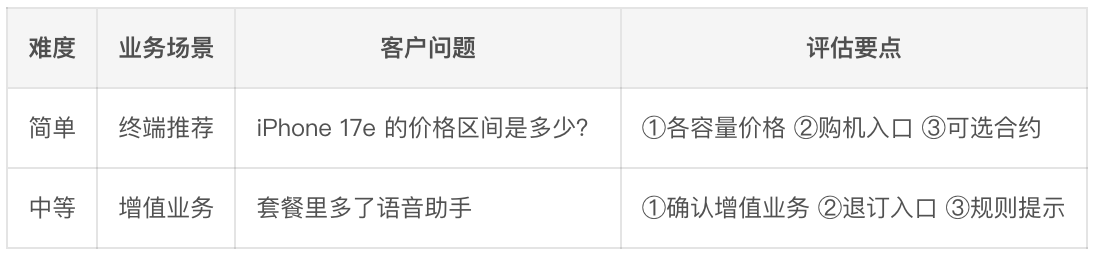
关键点:评估要点是预先定义的、可逐项打钩的。不是评测时再发挥,是出题时就锁死。这样模型团队没法回避——你交付的答案有没有覆盖这 3 个要点,业务一眼能看出来。
在此基础上,我把扣分项重新归并成3 层 12 项:
L1 · 致命错误(直接 0 分,一票否决)
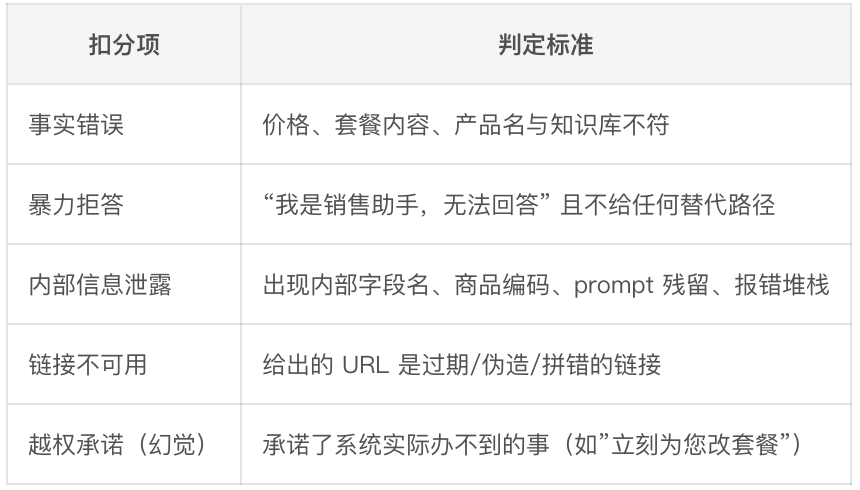
L2 · 严重不达标(扣 0.5 分,需复核能否上线)
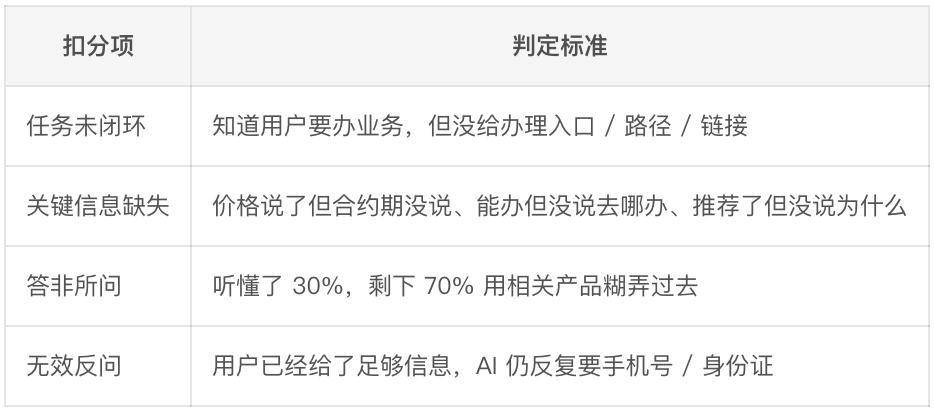
L3 · 体验问题(扣 0.2~0.3 分,可上线但需迭代)
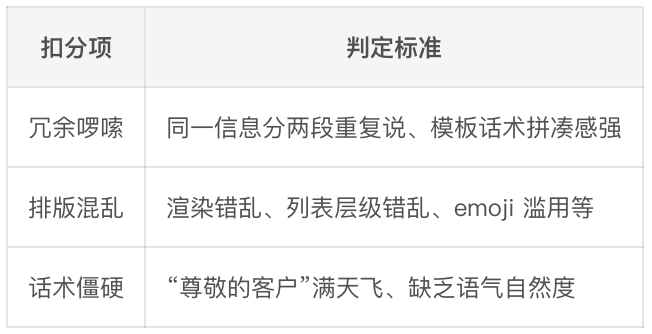
这套维度跟当前评测最大的区别有两个:
L1 是一票否决。
模型团队不能用”100 条里只有 6 条暴力拒答”这种平均数糊过去——只要有 6 条致命错误,这版就不能全量。
L2 / L3 分开记。
L2 是阻塞上线的问题,L3 是迭代项。跟模型 battle 时,我可以说”L1 + L2 加权不达标,上线先停”,比一句”感觉不行”硬气一万倍。
多轮是当前评测的重灾区。我看了那 102 条多轮标注,发现大部分扣分理由都是”答非所问””意图错”——这些指标其实是单轮指标的延伸,没有任何一个评在了”多轮”本身。
多轮对话和单轮的核心区别是:它有历史、有指代、有状态、有切换。我提了 5 个多轮专属维度:
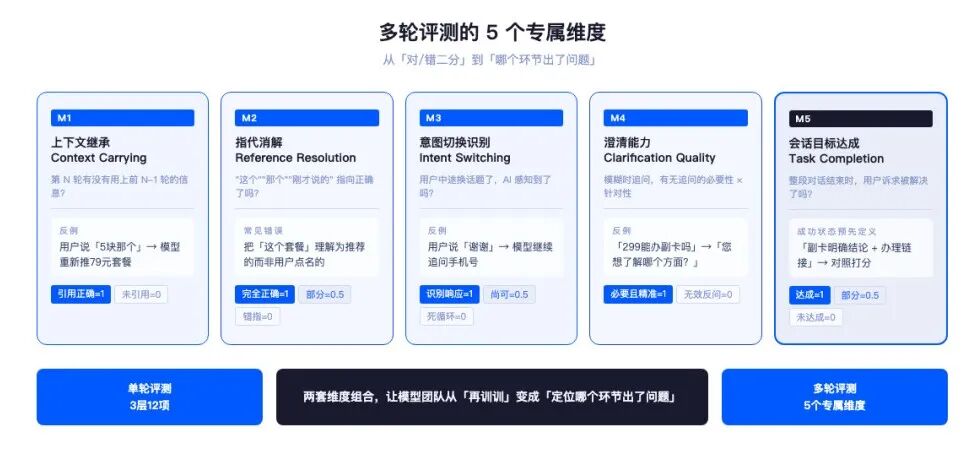
M1 · 上下文继承(Context Carrying)
第 N 轮的回复有没有用上前面 N-1 轮的信息?
举个真实例子(多轮表第 5~7 条,青海):用户先说”你把我套餐改一下”,再说”最便宜的”,再说”5 块那个”——这里指代的是「最便宜的套餐里 5 块那个」。模型如果在第三轮重新推了一遍 79、99 元套餐,上下文继承就是 0 分。
评分方式:第 N 轮的回复中,是否正确引用了前 N-1 轮的至少 1 个关键实体(产品名/号码/金额/时间)。0/1 二分。
M2 · 指代消解(Reference Resolution)
“这个” “那个” “刚才说的那款” 有没有正确对应到具体对象?
模型经常把”这个套餐”理解成上一轮系统推荐的套餐,而不是用户点名的套餐。打分:完全正确 1,部分正确 0.5,错指 0。
M3 · 意图切换识别(Intent Switching)
用户中途换话题了,AI 认出来了吗?
例如多轮表第 13 条(重庆):先报障”连不上网络”,AI 索要手机号;用户下一句”谢谢”。AI 应识别意图已切换为礼貌性结束,而不是继续追问手机号。打分:识别并响应 1,未识别但回复尚可 0.5,仍在原意图死循环 0。
M4 · 澄清能力(Clarification Quality)
用户描述模糊时,AI 问的澄清问题有没有价值?
反例:用户问”299 可以办副卡吗”,AI 反问”请问您是想了解 299 套餐的哪个方面”——这是无效反问,因为用户已经问得很清楚了。打分维度:是否真的需要澄清(必要性)× 澄清问题问得是否精准(针对性)。
M5 · 会话目标达成度(Task Completion)
整段对话结束时,用户的诉求被解决了吗?
这是最终极的指标,也是业务侧最在意但最难量化的。我的做法是:对每一段多轮对话,预先定义”成功状态”——比如”用户得到了办副卡的明确结论 + 办理链接”。会话结束时人工对照成功状态打分(达成 1 / 部分达成 0.5 / 未达成 0)。
这五个维度组合下来,多轮评测的颗粒度直接从原来的”对/错”变成“哪个环节出了问题”。对模型团队来说,他们也终于能定位优化点——是上下文丢了?还是指代错了?还是兜底太死?而不是笼统地”再训训”。
这是我最近补的一条原则,单独拎出来说。
每个扣分案例,模型团队都可以质疑,但必须给出对应规则的解读,而不是”我觉得这条不该扣”。
比如某条被打了”任务未闭环”,模型团队说”这条用户没明说要办理”。OK,那我们坐下来看:评估要点里写了”需给出办理入口”吗?如果写了,扣分成立;如果没写,是出题的人锅。规则有问题就改规则,但不能凭个人感受推翻。
这个机制建立起来之后,battle 的对象从”人对人”变成了”规则对规则”。氛围一下就好了很多。
写到这里其实方法论已经说完了。最后讲点更主观的东西。
第一,评测权在业务手里,不在模型团队手里。模型团队负责把分数搞上去,但”分数衡量什么”这件事的定义权,必须在业务。
第二,AI 产品经理的核心活儿之一就是定义评测。在大模型落地项目里,评测体系的设计能力 > Prompt 能力 > 模型调优能力。Prompt 写得好的人很多,能写出一份让模型团队没法甩锅、让业务能复用的评测表的人,少得多。
第三,”准确率”在业务侧场景里几乎是个伪指标。因为它默认了”每个问题只有一个正确答案”。但真实客服场景里,一个用户问”299 能办副卡吗”,正确答案不是”能”或”不能”——是”能,且这是办理入口,且这是规则提示”。准确率衡量的是单点正确,业务在意的是任务闭环。这两件事在评测里要分开看。
第四,模型永远会拟合你的评测标准。所以评测标准的健壮性,决定了你这个产品的天花板。一份糟糕的评测,会让模型团队把全部精力优化在错的方向上,浪费几个月。
评测框架搭好只是第一步。真正的问题在于:标完了一堆 badcase,然后呢?哪些该改知识库、哪些该训模型、哪些其实是兜底策略的问题?这部分我下一篇接着写。
本文由 @是AD 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自 unsplash,基于CC0协议
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。