





想要AI使用起来更得心应手,首先得需要经过足量的数据训练。因此有人产生了一个想法,用AI生成数据训练AI岂不是更高效?很遗憾,有研究表明,用AI生成数据训练新的AI,最终会让新的AI模型退化以至崩溃。一起来文中一探究竟吧。
人尽皆知:过去的科幻文学家预言了潜艇、卫星、人工智能等后世科技里程碑。然而科幻文学家们的预言中,其实应验的乌鸦嘴不比正面成就少,比如DDOS网络攻击、个人生物信息盗窃、和人工智能模型的退化。
2023年2月,美国华裔科幻文学家特德·姜发表文章称:ChatGPT等大语言模型,实质是对互联网语料库的有损模糊压缩,如同JPEG格式之于原始高清图片。
按特德·姜的观点,用大语言模型生成的文本来训练新的模型,如同反复以JPEG格式存储同一图像,每次都会丢失更多的信息,最终成品质量只会越来越差。大语言模型生成的文本在网络上发布得越多,信息网络本身就变得越发模糊、难以获取有效真实信息。
2023年6月中,牛津、剑桥、伦敦帝国学院、爱丁堡大学、多伦多大学等高校的AI研究者发布的论文预印本《递归之诅咒:用生成数据训练会使模型遗忘》在业界流传开来。论文中用实验结果证明了特德·姜的预言:用AI生成数据训练新的AI,最终会让新的AI模型退化以至崩溃。
这些研究者们发现,在训练新的神经网络AI模型时,使用大语言模型生成的内容作为训练数据集,会导致训练出的模型出现不可逆转的缺陷,即使模型最初的基础架构原始数据来自真实世界的实际数据。研究者们将这一新模型的退化过程与结果称为“模型崩溃”。
按论文所述,不管受训的新模型功能是以文字生成文字还是以图片生成图片,只要使用其他模型生成的内容来训练,这个过程是不可避免的,即使模型处在近乎理想状态的长时间学习条件亦如此。
论文一作伊利亚·苏玛利沃夫(Ilia Shumailov)称,AI生成数据中的错误会极快沉淀,最终导致从生成数据中学习的模型进一步错误地感知现实。
“模型崩溃”分为早期与晚期两种。在早期时,被喂生成数据的AI模型会开始失去原初数据分布的信息;在晚期,被喂生成数据的AI模型会吐出完全不符合现实、不相关原初底层数据的结果。
而且与症状类似的“灾难性遗忘”不同,“模型崩溃”的AI一直保有对之前学习过的原初底层数据的记忆,但极其固执,错误会千篇一律且难以矫正,模型将持续甚至强化将错误结果认为是正确的结论。
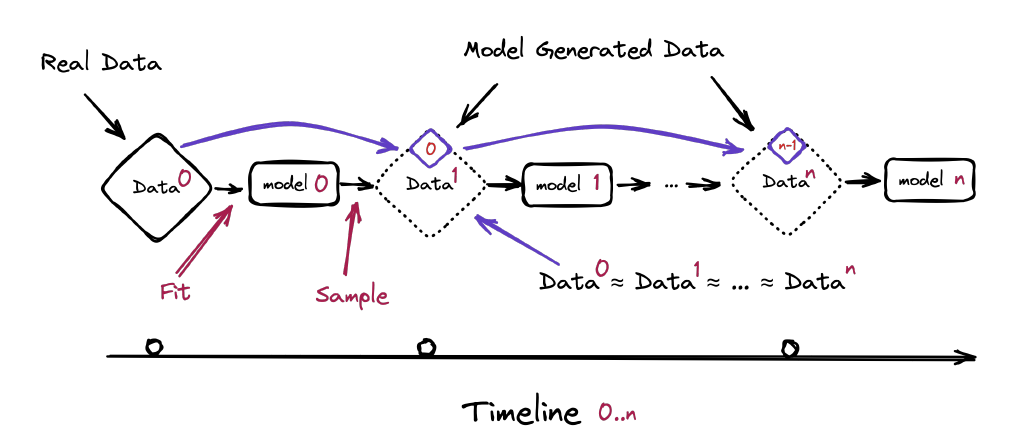
论文中“模型崩溃”过程的示意图
研究者们先用小模型试验起,用相同模型生成的数据训练同一模型。以此方法在高斯混合模型(GMM)上实验,拿AI分辨人工生成的不同正态分布。结果是在如此训练50次后模型开始出错到无法分辨原初底层数据。训练到两千次后,模型的错误结果收敛到每次基本雷同毫无变化。
以同样方法训练变分自编码器(VAE)模型,训练5次后模型开始出错,10次后模型的错误结果开始与原初底层数据无关,20次后错误结果就开始收敛至基本雷同。
以上的小模型的原初数据量小,或许易于迷惑。研究者再用现在商用广泛的OPT-125m文本生成模型实验,此模型由Meta 公司开发,参数量1.25亿。研究者先用有1亿词元的“维基文本库2”数据集喂给模型,跑出同样词元量的生成结果数据集。再用生成结果数据集反复训练OPT-125m模型。
结果是,在研究者输入提示词之后,起初的OPT-125m模型吐出的是带有乱码但大体成文的语句。被如此训练1次的大模型吐出的是带有瞎编内容的幻觉性文本,但仍然成文。被如此训练7次的大模型吐出的是完全与初始提示词无关的文本,9次后大模型的生成文本就是完全不知所云的车轱辘话。
“模型崩溃”的原因其实并不难懂。概言之,与特德·姜、马斯克这些名人们嘲笑生成式AI的说辞很相近:这些大模型本质上是高端统计学应用,离“智能”的实质还差得远。
用AI生成内容来训练AI的话,无可避免就会踩进“统计近似值偏差”的坑里。实质是高端统计程序的神经网络模型们,天然会高估、过于重视大概率的通常值,也会低估、过于忽视小概率的非常值。
这些模型生成的结果无法规避以上缺陷,持续用来再训练新模型,数据的多样性会越来越小、符合真实的正确度会越来越有限、“近似值拟合”会越来越严重。用研究者的话来说,用AI生成数据来训练新的AI,是在毒化模型对真实世界的认知。
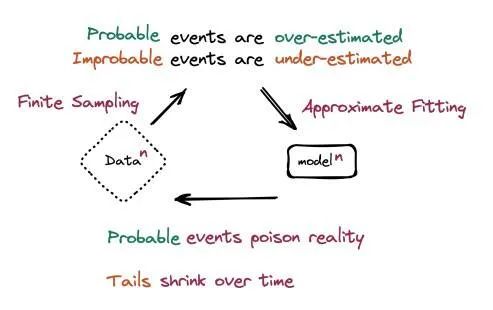
论文中“模型崩溃”成因的示意图
用论文作者之一罗斯·安德森(Ross Anderson)的话说,这就如同用莫扎特作品来训练AI,结果会得出一个风格类似莫扎特但缺乏灵气的“萨列尼”模型。再用“萨列尼”模型的作品训练新的模型,如此反复五六次后,最终模型的音乐作品既不会有莫扎特的风格也不会有莫扎特的灵光。
除了这一主因外,“函数近似值误差”也会为“模型崩溃”推波助澜。任何神经网络AI在本质都算是有限的通用函数近似器,但总会出现函数近似值过度表达或不充分表达带来的结果不精确。
理论上来说,“统计近似值偏差”与“函数近似值误差”并不必然会带来恶果,有少许可能,这些偏差恰好会消除真实数据中的噪音值,让AI模型的生成结果更符合真实数据分布。然而更大的可能是,这些误差会放大、加乘数据噪音。
在罗斯·安德森的个人博客中,有人评论这是热力学中的熵、生物学中的近亲繁殖退化,在AI界的复现。
对于业界,此发现再次凸显了真实人类创造的数据的稀缺性。罗斯·安德森戏称,在海洋布满不可降解塑料垃圾、空气里充满二氧化碳排放物后,互联网以后也会被大语言模型生成的低质量结果污染。反过来说,真实人类创造的数据如同洁净的空气与饮水,是日后生成式AI必须依赖的维生补给。
在如此背景下,不难理解为何推特与Reddit这些用户活跃的社交媒体纷纷取消应用程序接口扒数据的权限。这些社交媒体上的真人互动内容都是以后越来越值钱的不可再生资源,马斯克们是绝不愿继续免费让OpenAI们拿去用的。
数据饥渴的AI公司们,现在两种继续发掘高质量数据的办法都在用。
一是扒完当代互联网数据后,继续扒古旧文本与图像数据。保存了远至两百年前书籍扫描件的“互联网档案馆”,在5月底称网站之前短暂崩溃,是因为托管在亚马逊云服务器上的数十个虚拟接口做出了每秒数万次的数据查询请求,导致网站无法承载。
二是老实花钱买。北京时间6月17日0点,《金融时报》独家报道,称最近数月内,谷歌、OpenAI、微软等公司在与新闻业界的大企业,如新闻集团(News Corp)、纽约时报和卫报在内的出版商接触,寻求AI训练数据材料的持续来源并避免未来的版权纠纷。
虽然商洽还在早期阶段,但信源透露出的信息是AI巨头企业们愿意为作为AI 模型训练数据的新闻内容向媒体巨头们支付定期订阅费用,媒体巨头们开出的价位是年均500-2000万美元。
作者:李熙;编辑:杨博丞
微信公众号:DoNews(ID:ilovedonews),不局限于对互联网行业的追踪与探索,更要向未来、向未知的方向迈进。
本文由人人都是产品经理合作媒体 @DoNews 授权发布,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议。
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。