





随着大模型技术的广泛应用,人们在享受其带来的便利的同时,也面临着隐私保护的新挑战。本文将探讨大模型在数据收集、处理和存储过程中可能引发的隐私泄露风险,分析用户与大模型互动时的数据安全问题,并讨论如何在保护隐私的同时合理利用大模型技术。
“把这份会议速记的观点提炼出来”“优化年终总结”“我要做一份明年工作计划的PPT”……自从有了大模型,筱筱每天都要给文心一言、豆包等安排活计,既提高工作效率,也可以集百家之长,让工作成果更加“出挑”。
但随着对大模型的依赖与日俱增,筱筱的心中也产生了担忧,“经常‘喂’给大模型素材,免不了涉及工作内容和个人信息,这些数据会泄露吗?”对于很多用户来说,他们不清楚数据如何被收集、处理和存储,不确定数据是否被滥用或泄露。
此前,OpenAI被曝在训练时用到个人隐私数据。有报道称,有企业在使用ChatGPT协助办公的一个月内,接连发生三起隐私泄露事件,多家知名公司禁用ChatGPT。
中国科学院院士何积丰曾表示,大模型面临着隐私保护和价值观对齐两大难题。从担心“饭碗”不保到忧虑隐私被侵犯,在大模型带给人们便利的同时,危机感随之增长。
人们能把自己的小秘密告诉大模型吗?
“你目前的训练模型所使用的数据集(包括版权数据)出自哪里?”
《IT时报》记者与通义千问、豆包、文心一言等10余家大模型进行了对话,得到的答复几乎一致,均表示训练数据集涵盖多个领域的文本、图像和多模态数据,包括公开数据集、合作伙伴提供的数据以及互联网爬取的数据,如维基百科、新闻文章、书籍等大规模文本数据集都是常用来源。
除了这些常用来源,用户与大模型在互动过程中所“喂”的信息,也是模型训练的数据来源之一。“你会收集我提供给你的材料进行训练吗”,对于这个问题,所有大模型都给出了否定答案,称“在与用户的交互过程中不会收集、存储或使用用户的对话数据来训练或改进模型”。
然而,矛盾在于,根据大多数大模型的隐私协议,用户和大模型的交互信息是会被记录的。在使用角色智能体功能时,通义千问需要用户提供相关信息用于训练智能体,并提醒用户谨慎上传个人及敏感信息;在豆包和腾讯元宝的使用协议中,均有类似规定:对于通过本软件及相关服务、输入、生成、发布、传播的信息内容之全部或部分,授予公司和/或关联方免费的、全球范围内的、永久的、可转让的、可分许及再许可的使用权,以使公司对该信息内容进行存储、使用、复制、修订、编辑、发布、展示、反义、分发上述生成内容,包括但不限于模型和服务优化、相关研究、品牌推广与宣传、市场营销、用户调研;海螺AI隐私协议提到,每天会收到大量用户上传的内容,并进行改善算法,但会遵循《个人信息保护法》。
在业内人士看来,虽然在预训练阶段已经使用了大量高质量数据,但用户在使用过程中产生的数据也能在一定程度上帮助模型更好地适应不同的场景和用户需求,从而提供更精准、更个性化的服务。
安远AI资深研究经理方亮告诉《IT时报》记者,根据用户的输入,模型会生成更符合用户偏好的内容,这些数据后续也可能被用于模型训练,以更好地满足用户需求。
大模型帮助人们解放了双手,个性化地满足用户需求,数据越丰富,就能更好提升大模型的效果,这无可厚非,关键在于是否根据个人信息使用的“最小化、匿名化、透明化”等原则进行处理。“从当前市面上通用大模型的隐私政策来看,其在保护用户隐私方面的表现存在一定的复杂性,不能简单地认为它们完全保护或不保护用户隐私。”有业内人士向《IT时报》记者表示。
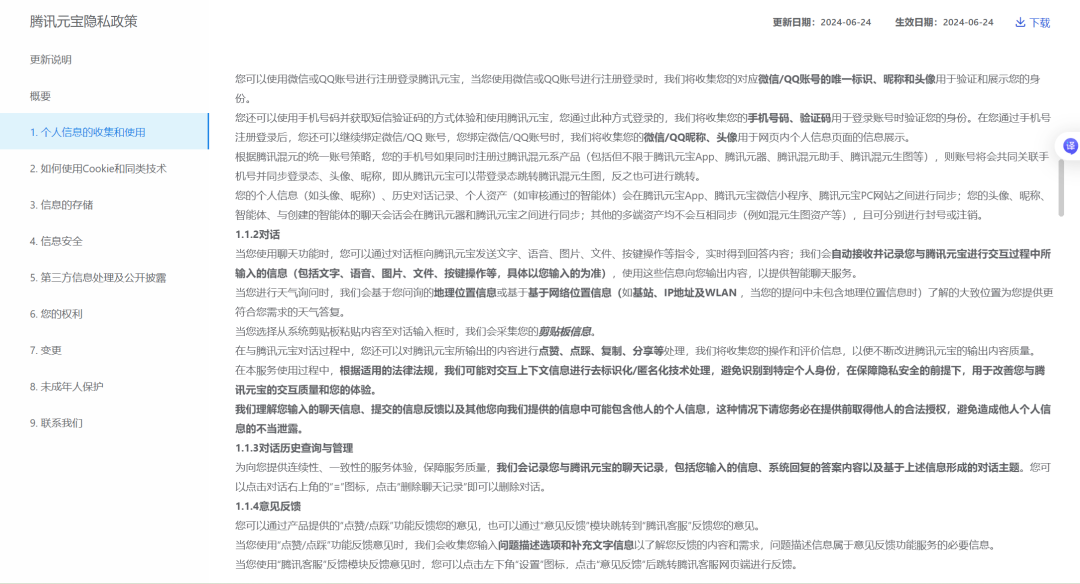
比如豆包在其隐私政策中提到,在经过安全加密技术处理、严格去标识化且无法重新识别特定个人的前提下,可能会把向AI输入的数据、发出的指令以及AI生成的回复等进行分析和用于模型训练。
腾讯元宝的隐私政策表示,在服务过程中,会对交互上下文信息进行去标识化技术处理,避免识别到特定个人身份。元宝中的写真形象馆、百变AI头像等人像类智能体或应用生成内容时,会进行人工智能技术处理但不会留存人脸特征。
但隐私风险依然不可忽视,有业内人士向《IT时报》记者透露,一些模型虽然表示不会直接收集用户的某些敏感信息,但对于用户输入的其他信息,在经过分析和处理后,是否可能间接推断出用户的隐私内容,这是值得关注的问题。此外,部分大模型的隐私政策在信息披露上不够完善。
《IT时报》记者在查阅部分大模型隐私协议时发现,一些特定的交互情况如需要打开地理位置、摄像头、麦克风等授权,在交互结束后,授权可以关闭,但对撤回“投喂”的数据并不那么顺畅。
腾讯元宝、豆包等允许用户在App内通过改变设置,来撤回语音数据。比如豆包表示,如果用户不希望输入或提供的语音信息用于模型训练和优化,可以通过关闭“设置—账号设置—改进语音服务”撤回授权,但如果用户不希望其他信息用于模型训练和优化,需要通过邮件、电话等联系,无法在App上自行设置。
南都数字经济治理研究中心近期发布的报告显示,多数平台并未提供明确选项让用户拒绝其个人数据被用于AI模型训练,对于数据将被用于何种具体用途、会提供给哪些第三方等信息也披露不足,使得用户难以全面了解数据流向和使用情况。
方亮向《IT时报》记者表示,目前在隐私保护方面,大模型企业存在一些改进空间,例如数据收集和使用政策不够透明、用户对数据使用缺乏有效控制、数据存储和传输的安全机制需要加强、缺乏统一的隐私保护标准和规范等。他举例道,“比如在一些情况下,用户可能并不希望提供某些信息,或者希望删除已经提供的数据,但有的大模型没有提供这样的选项,这在一定程度上限制了用户的自主选择权。”方亮说道。
虽然大多数大模型在隐私协议中提到使用不低于行业同行的加密技术、匿名化处理及相关可行的手段保护个人信息,但方亮对这些措施的实际效果仍有担忧。“当用户输入个人信息后,尽管这些信息可能已经去标识化或者脱敏,但关键在于这些处理是否符合相关规定。如果遭到攻击,是否仍可能通过关联或分析技术恢复原始信息,这一点需要特别关注。此外 ,如何平衡好隐私保护、数据利用与模型性能之间的关系,也是亟待解决的问题 。”
《IT时报》记者了解到,有研究表明,能够从模型中获取一定数量的原始语料。
在DARKNAVY深蓝科技研究员肖轩淦看来,在大模型中,用户输入的数据一般被用于实时处理及数据存储。实时处理是由大模型处理用户输入的素材并输出内容返回给用户,即聊天过程,这些数据会上传到云端进行处理,也同样会被存储至云端,用户能够查看与大模型交互的历史记录。“带来的风险是,如果用户输入的内容作为数据集,可能过段时间后当其他人向大模型提问相关的内容,会带来信息泄露,被用于不当目的。”肖轩淦认为。
“大模型的主要训练已经在预训练时期基本完成,用户与大模型之间的普通聊天内容,并不算有效数据,不太会被大模型拿去训练。”不过,也有业内人士向《IT时报》记者表示,训练模型属于前置工作,在已经成型的大模型面前,用户无须过度担心隐私会被泄露。
实际上,在不少安全人士看来,大模型带来的隐私风险并不只有这些。
“大模型在用户隐私数据访问方面有一定问题,与ChatGPT这类只能被动接收用户输入的系统不同,当手机或电脑接入AI应用后,就变成一个‘智能体’,这些应用能够主动访问设备中的大量隐私信息,必须引起高度重视。”肖轩淦向《IT时报》记者解释,比如有的手机AI功能支持叫外卖,这样位置、支付、偏好等信息都会被AI应用悄无声息地读取与记录,增加了个人隐私泄露的风险。
DARKNAVY曾针对手机端的AI应用进行深入研究,发现一些应用已经意识到隐私数据访问的敏感性和重要性。例如,Apple Intelligence就明确表示其云端不会存储用户数据,并采用多种技术手段防止包括Apple自身在内的任何机构获取用户数据,赢得用户信任。
欧洲数据保护委员会(EDPB)近日通过了关于人工智能模型中个人数据处理相关数据保护问题的意见(Opinion 28/2024),其中提到,AI模型的匿名性不能仅靠简单的声明,而需要通过严格的技术论证和持续的监控来保证,同时也强调企业不仅需要证明数据处理的必要性,还要证明所采用侵入性最小的方式。
“未来,针对隐私和版权保护的法规和标准将更加严格,推动企业强化数据保护措施。”方亮建议,大模型企业在收集训练数据前应实施负责任的数据收集,需要考虑适用的监管框架,并尽可能最小化数据收集范围;在使用输入数据训练大模型之前对其进行审核,尝试识别可能产生危险能力、侵犯知识产权或包含敏感个人信息的数据;根据数据审核结果,采取适当的风险缓解措施;促进对训练数据集的外部审查机制。同时,用户应拥有更大的权力来管理和控制其数据。
作者/ IT时报记者 潘少颖 毛宇
编辑/ 钱立富 孙妍
来源/《IT时报》公众号vittimes
本文由人人都是产品经理作者【IT时报】,微信公众号:【IT时报】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自Unsplash,基于 CC0 协议。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。