惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

IT之家
IT之家
T
Tailwind CSS Blog
V
V2EX
阮一峰的网络日志
阮一峰的网络日志
H
Help Net Security
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
腾讯CDC
GbyAI
GbyAI
酷 壳 – CoolShell
酷 壳 – CoolShell
H
Hackread – Cybersecurity News, Data Breaches, AI and More
Last Week in AI
Last Week in AI
A
About on SuperTechFans
L
LangChain Blog
Engineering at Meta
Engineering at Meta
F
Fortinet All Blogs
G
Google Developers Blog
The Cloudflare Blog
云风的 BLOG
云风的 BLOG
D
Docker
博客园 - 聂微东
博客园 - 司徒正美
Recent Announcements
MyScale Blog
MyScale Blog
U
Unit 42

人人都是产品经理

为什么你的产品找不到差异化?90%的失败都卡在第一步上(下) – 人人都是产品经理, 3年从30万到1300万用户、获2200万美元融资,这个AI教育产品用“抽卡”破解了获客难题 – 人人都是产品经理, 园区招商系统怎么做才能真正帮到去化?我加了这一个功能,推广链接转发400次阅读过万 – 人人都是产品经理, AI大事件:OpenAI发完网络安全模型又搞药物研发,小鹏汽车要抓”DeepSeek时刻” – 人人都是产品经理, 电商不是卖货,是一场更残酷的产品经理实战 – 人人都是产品经理, 没想到,活动营销又回来了! – 人人都是产品经理, 为何All-in海外KOC:一场关于AI时代窗口期的豪赌 – 人人都是产品经理, 重新理解企业的内部协作 – 人人都是产品经理, 苹果的 AI 战略到底是什么? – 人人都是产品经理, 医疗智能体·第2讲——合规护城河:等保、PIPL与HIPAA的架构实战 – 人人都是产品经理, 向量知识库五步法:从“答非所问”到“精准回复” – 人人都是产品经理, 鸿蒙PC三方库构建总指挥HPKBUILD(sha)库为例 – 人人都是产品经理, 何时该用LLM?AI产品经理的LLM设计指南 – 人人都是产品经理, 医疗信息领域的需求方、决策方、准入方以及关注点(二) – 人人都是产品经理, 即梦涨价:一场被误读的「傲慢」 – 人人都是产品经理, 面试AI PM必答题:Hermes和OpenClaw的区别,如何讲清楚业务价值 – 人人都是产品经理, AI的下一张船票:世界模型——AI产品经理必须理解的技术拐点 – 人人都是产品经理, 小红书做GEO,怎么让AI信你?记住这 3 个重要信息 – 人人都是产品经理, 5 家印度 AI 初创公司,看看印度 AI 再做什么 – 人人都是产品经理, AI项目跨团队协作:产品技术业务如何不打架 – 人人都是产品经理, Agentic Workflow(智能体工作流):让AI从”答案生成器”变成”数字员工” – 人人都是产品经理, lycium_plusplus 项目全景解读:OpenHarmony 三方库构建的“大管家” – 人人都是产品经理, 从爆单救火到前置履约:两套预采策略,把生鲜大促履约效率拉满 – 人人都是产品经理, 什么时候该补货?我用一轮数据做了一个决定 – 人人都是产品经理, 从“机械兜底”到“动态分流”:AI客服重复进线治理的4大底层逻辑 – 人人都是产品经理, 抖音拼效率,红书拼洞察 – 人人都是产品经理, 全民狂欢与退潮——为什么龙虾这波热潮冷却得如此之快? – 人人都是产品经理, Stripe押注!MPP重塑全球支付 – 人人都是产品经理, 小红书GEO:AI引用你的内容,不是因为你对,而是因为你看起来可信 – 人人都是产品经理, 前百度副总裁押注办公Agent,日韩付费爆发,Manus迎来强劲对手 – 人人都是产品经理,
一篇系统讲清楚Agent的关键[上下文工程管理]
卡萨丁AI · 2026-03-05 · via 人人都是产品经理

AI Agent 的成败往往不取决于模型本身,而在于上下文工程的精妙运用。从 Offload 转移到 Cache 缓存,五大核心策略揭示了如何通过信息熵控制实现推理效率的帕累托最优。本文将深入解析这些技术如何在减少成本的同时提升效能,成为 Agent 时代的操作系统级能力。
多数 AI Agent 的失败,并非模型能力的失败,而是上下文工程的失败

一、Context Engineering 由来

Context Engineering 的概念主要源自 Tobi Lütke 和 Andrej Karpathy 的推特:“It describes the core skill better: the art of providing all the context for the task to be plausibly solvable by the LLM.”(提供所有上下文的艺术,以使任务能够被 LLM 合理地解决)&& “When in every industrial-strength LLM app, context engineering is the delicate art and science of filling the context window with just the right information for the next step.”(上下文工程是一门微妙的艺术与科学,旨在在上下文窗口中填入恰到好处的信息,为下一步推理做准备)

二、上下文工程的核心策略(Context Engineering Core Strategies)

明明只是让 AI 写个简单代码,它却疯狂调用工具,最后消耗 50 万 Token,成本直接飙到 1-2 美元!更糟的是,当上下文长度超过临界值(比如 GPT-4 到 10 万 Token 后),模型推理能力能暴跌 30% 以上…

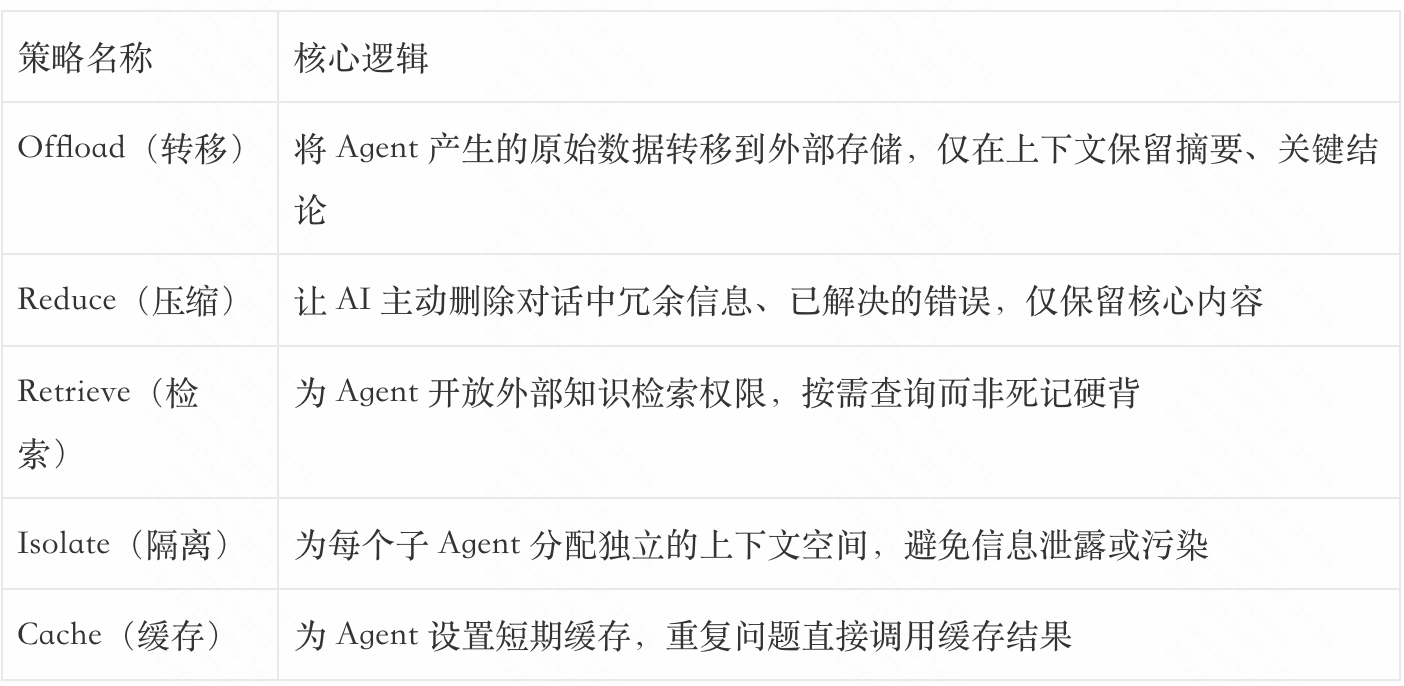
策略一:Offload 转移 —— 给 Agent 的 “大脑” 减减负

想象一下:AI 要做份详细调查报告,但它不把 “所有细节” 硬塞进 “脑子”,而是把 “完整报告” 存进 “文件柜”,只在 “便签” 上记核心结论。这样既记住关键点,又不会因信息过载而混乱。

用技术话说就是:把工具调用产生的原始数据转移到外部存储,只在上下文里保留「摘要 / 关键结论」。

举个例子:

  • Open Deep Search 能把网页内容压缩成 “要点列表”,压缩率高达 90%;
  • 类似 “虚拟机沙盒” 的机制,会把原始执行日志存到磁盘,只传递 “关键状态码”。

这种方法特别适合:

  • 长周期任务(比如持续多日的研究项目);
  • 工具返回数据量超大的场景(比如单次返回超 1 万 Token)。

策略二:Reduce 压缩 —— 让对话 “瘦成闪电”,不啰嗦

这就像 AI 会 “主动忘事”:前几分钟说的废话、犯过的小错误,它会自动删掉,只记住核心对话。

比如:

  • Cloud Code 会自动触发 “对话压缩”,但会 “聪明地” 保留最近 3 次错误日志;
  • 专门的 “游戏 Agent”,会清除因 “幻觉” 导致的错误行动记录。

当然也有技巧:

  • 要设置 “不可删除白名单”(比如用户原始指令、核心目标绝对不能删);
  • 要有 “压缩回滚机制”(能恢复最后两次压缩操作,防止误删)。

策略三:Retrieve 检索 —— 别让 AI “死记硬背”,要会 “查资料”

不是让 AI 把所有知识 “死记硬背”,而是给它一个 “超级图书馆” 的检索权限 —— 需要什么知识点,自己去查!既聪明,又不累。

这需要技术架构支撑,比如 “混合检索架构 + 多元代码库检索系统”。有团队用这套方法,把 “知识准确率” 提升了 40%,还能自动给 Help 仓库生成 “知识图谱”。

但要注意风险控制:

  • 如果检索结果的 “执行置信度” 低于 0.6,要触发人工复核;
  • 单次查询最多扫描 50 个文件,避免 “检索范围过载”。

策略四:Isolate 隔离 —— 多 Agent 协作?给它们 “独立会议室”

如果一个任务需要多个 AI 协作,就像给每个 AI 分配 “独立会议室”:让它们专注自己的事,互不打扰,防止 “信息泄露” 或 “上下文错乱”。

技术上,就是为每个子 Agent 分配 “独立的上下文空间”。比如:

  • 有的 “研究 Agent”,用 12 个子 Agent 并行采集数据,彼此空间完全隔离;
  • 欺诈检测系统里,“支付 Agent” 和 “风控 Agent” 彻底隔离,保护敏感数据。

这种方法特别适合:

  • 多 Agent 协作系统(比如复杂任务分工的 AI 团队);
  • 敏感数据的隐私保护场景(比如金融、医疗领域)。

⚡ 策略五:Cache 缓存 —— 给 AI 装 “短期记忆”,重复问题秒回

相当于给 AI 装了 “短期记忆”:你刚问过的问题,它会记一小会儿,下次再问能立刻回答,不用重新思考。

效果多明显?

  • 生产系统用 “KV 缓存”,直接让 Cloud 成本降了 10 倍;
  • OpenAI 的 “自动缓存”,让重复问题的响应速度提升 8 倍!

但要注意细节:

  • 缓存过期策略:TTL(缓存有效期)别超过 5 分钟,防止 “旧信息误导”;
  • 隐私保护:含个人信息的数据,绝对不能缓存。

三、小结

总结表

未来的看法

长期来看,企业正在从 “把 Agent 嵌入现有流程”,转向“原生重构业务”—— 这直接突破了传统工作流的天花板。核心指标也从 “准确率”,转向 “命中率” 这类 “效能指标”。

而 “上下文工程” 的本质,就是通过 “信息熵控制”,实现模型推理效率的 “帕累托最优”(不损害一方的情况下,优化另一方)。它会成为Agent 时代的 “操作系统级能力”。

本文由 @卡萨丁AI 原创发布于人人都是产品经理。未经作者许可,禁止转载

题图来自Unsplash,基于CC0协议