










在人工智能的世界里,RAG(Retrieval-Augmented Generation)技术正成为提升AI理解和生成能力的关键。本文将带你进入RAG系统的实战篇,从构建一个最小可行性的RAG系统开始,详细介绍如何将这一技术应用于实际场景中。
在《AI大模型实战篇》系列文章中,风叔通过八篇文章,从最经典的ReAct模式开始,沿着规划路线介绍了REWOO、Plan&Execute和LLM Compiler,沿着反思路线介绍了Basic Reflection、Self Discover和Reflexion,并以最强大的设计模式LATS作为收尾。
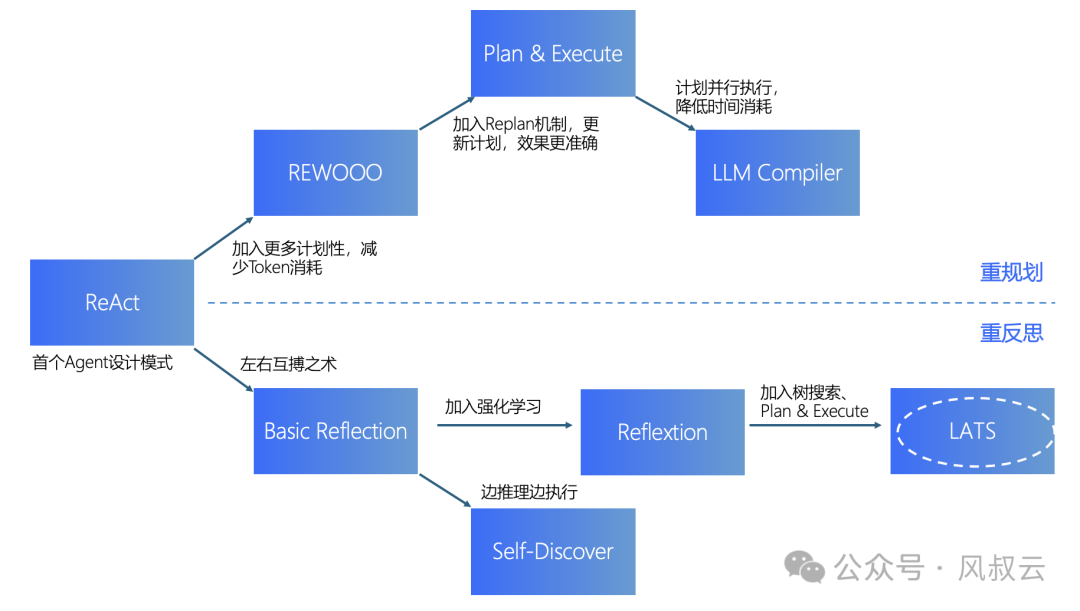
但是,所有的这些设计模式,都只是在告诉AI Agent应该如何规划和思考,且只能依赖于大模型既有的知识储备。而实际应用中,我们往往更希望AI Agent结合我们给定的知识和信息,在更专业的垂直领域内进行规划和思考。
比如我们希望Agent帮我们做论文分析、书籍总结,或者在企业级场景中,让AI Agent写营销计划、内部知识问答、智能客服等等非常多的场景,只靠上面几种Agent设计模式是远远不够的,我们必须给大模型外挂知识库,并且通过工作流进一步约束和规范Agent的思考方向和行为模式。
解决这个问题的最佳方式是利用RAG技术,接下来我们正式开启《RAG实战篇》系列。对于RAG还不太熟悉的朋友,可以先参考下面两篇文章:
我们将基于下图所示的框架,来构建一个完整的RAG系统。
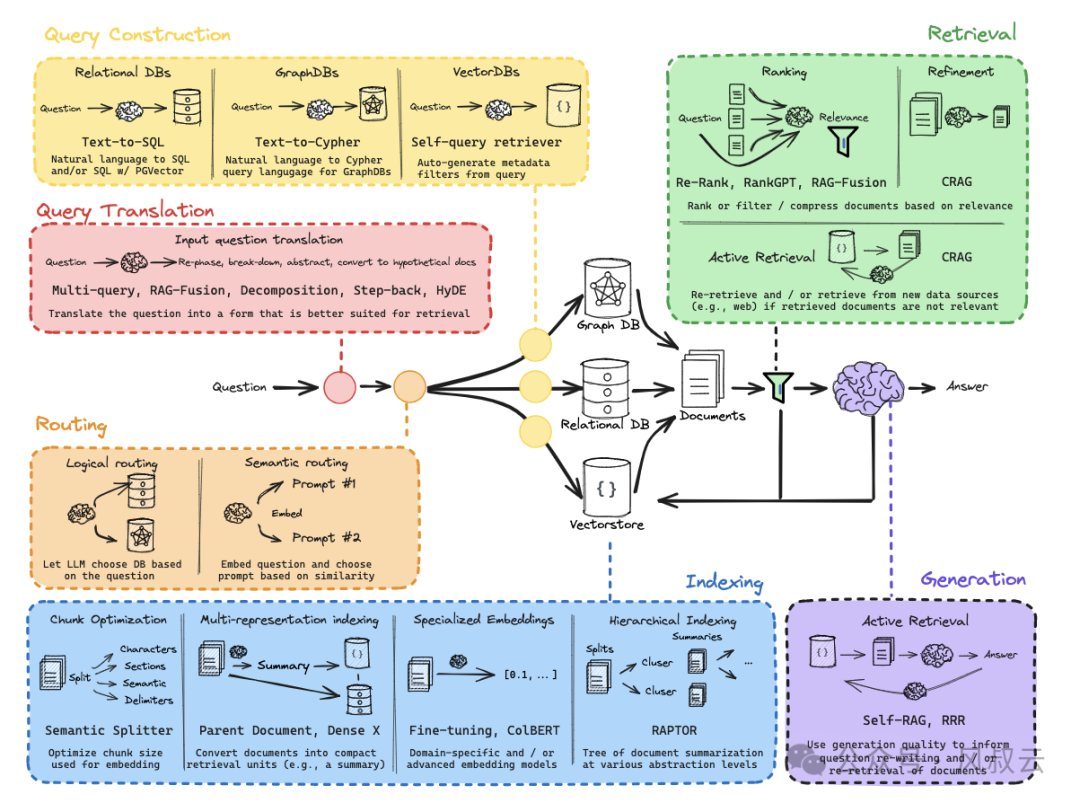
Indexing是任何RAG系统的第一步,在实际应用场景中,文档尺寸可能非常大,因此需要将长篇文档分割成多个文本块,以便更高效地处理和检索信息。
Indexing环节主要面临三个难题:
首先,内容表述不完整,内容块的语义信息受分割方式影响,致使在较长的语境中,重要信息被丢失或被掩盖。
其次,块相似性搜索不准确,随着数据量增多,检索中的噪声增大,导致频繁与错误数据匹配,使得检索系统脆弱且不可靠。
最后,参考轨迹不明晰,检索到的内容块可能来自任何文档,没有引用痕迹,可能出现来自多个不同文档的块,尽管语义相似,但包含的却是完全不同主题的内容。
在这个框架中,我们将在索引环节实现Chunk optimization(块优化)、Multi-representation indexing、Specialized Embeddings(特殊嵌入)和Hierachical Indexing(多级索引)这四种优化方案。
Query Translation主要处理用户的输入。在初始的RAG系统中,往往直接使用原始query进行检索,可能会存在三个问题:
第一,原始query的措辞不当,尤其是涉及到很多专业词汇时,query可能存在概念使用错误的问题;
第二,往往知识库内的数据无法直接回答,需要组合知识才能找到答案;
第三,当query涉及比较多的细节时,由于检索效率有限,大模型往往无法进行高质量的回答。
在这个框架中,我们将在这个环节实现Multi-query(多查询)、Rag-Fusion、Decomposition(查询分解)、Stepback和HYDE这五种优化方案
路由的作用,是为每个Query选择最合适的处理管道,以及依据来自模型的输入或补充的元数据,来确定将启用哪些模块。比如在索引环节引入多重索引技术后,就需要使用多级路由机制,根据Query引导至最合适的父级索引。
在路由环节,我们将实现Logical routing(基于逻辑的路由)和Sematic Routing(基于语义的路由)两种方案。
查询构建主要是为了将自然语言的Query,转化为某种特定机器或软件能理解的语言。因为随着大模型在各行各业的渗透,除文本数据外,诸如表格和图形数据等越来越多的结构化数据正被融入 RAG 系统。
比如在一些ChatBI的场景下,就需要将用户的Query内容,转化为SQL语句,进行数据库查询,这就是Text-to-SQL。再比如工业设计场景下,可能需要将用户的Query转化为设计指令,或者设备控制指令,这就是Text-to-Cypher。
在查询构建环节,我们将实现Text-to-SQL、Text-to-Cypher和Self-Query(让大模型自行构建Query)三种优化方案。
在检索的时候,用户的问题会被输入到嵌入模型中进行向量化处理,然后系统会在向量数据库中搜索与该问题向量语义上相似的知识文本或历史对话记录并返回。
在朴素RAG中,系统会将所有检索到的块直接输入到 LLM生成回答,导致出现中间内容丢失、噪声占比过高、上下文长度限制等问题。
在检索环节,我们将实现Reranking(重排序)、Refinement(压缩)、Corrective Rag(纠正性Rag)等方案。
在生成环节,可能会出现以下问题:
第一,当系统忽略了以特定格式(例如表格或列表)提取信息的指令时,输出可能会出现格式错误;
第二,输出错误或者输出不完整,比如对于一些比较类问题的处理往往不尽人意,以及可能出现的幻觉问题;
第三,可能会输出一些不太符合人类/社会偏好,政治不正确的回答
在生成环节,我们将重点介绍Self-Rag方案。
要覆盖所有上面提到的优化环节,需要较长的内容篇幅,因此风叔会分成几篇文章来写。接下来,我们先从整体上,看看一个最小化的RAG系统是如何实现的。
RAG发展初期,其核心框架由索引、检索和生成构成,这种范式被称作Naive RAG。Naive Rag的原理非常简单,包括以下三个步骤:
索引:这一过程通常在离线状态下进行,将原始文档或数据进行清洗并分块,然后将分块后的知识通过embedding模型生成语义向量,并创建索引。
检索:对用户输入的Query问题,使用相同的embedding模型,计算Query嵌入和文档块嵌入之间的向量相似度,然后选择相似度最高的前N个文档块作为当前问题的增强上下文信息。
生成:将原始Query和相关文档合并为新的提示,然后由大型语言模型基于提供的信息回答问题。如果有历史对话信息,也可以合并到提示中,用于进行多轮对话。
下面,风叔通过实际的源码,详细介绍如何构建一个最小化的Naive Rag系统。
关注公众号【风叔云】,回复关键词【最小Rag系统】,获取Naive Rag设计模式的完整源代码。
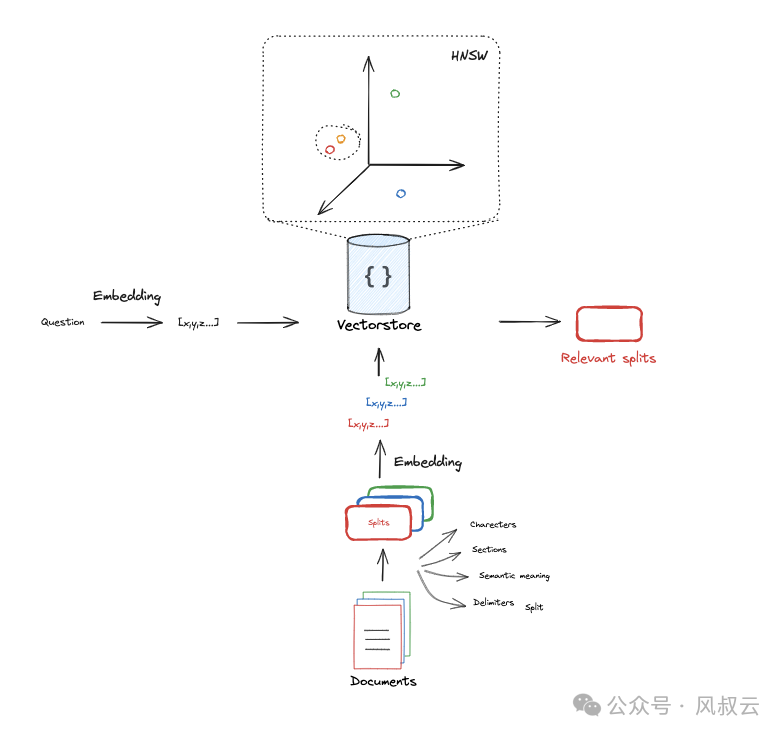
首先,我们导入一些示例Documents,以导入外部博客为例,我们直接使用WebBaseLoader从目标地址读取数据。
import bs4
from langchain_community.document_loaders import WebBaseLoader
loader = WebBaseLoader(
    web_paths=("https://lilianweng.github.io/posts/2023-06-23-agent/",),
    bs_kwargs=dict(
        parse_only=bs4.SoupStrainer(
            class_=("post-content", "post-title", "post-header")
        )
    ),)
blog_docs = loader.load()
然后我们需要对文档进行分块。在这个例子中,我们先把流程跑通,采用最简单的文本分割器,尽量按照段落进行分割。
# Split
from langchain.text_splitter import RecursiveCharacterTextSplitter
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
    chunk_size=300,
    chunk_overlap=50)
# Make splits
splits = text_splitter.split_documents(blog_docs)
接下来,我们需要将文本分割的结果存入向量数据库,默认使用了OpenAI的Embedding模型。
# Index
from langchain_openai import OpenAIEmbeddings
from langchain_community.vectorstores import Chroma
vectorstore=Chroma.from_documents(documents=splits,embedding=OpenAIEmbeddings())检索过程非常简单。首先构建检索器retriever,设置K=1,即只召回最相关的一个内容块;然后根据问题找到最相关的内容,存入docs
retriever = vectorstore.as_retriever(search_kwargs={"k": 1})
docs=retriever.get_relevant_documents("What is Task Decomposition?")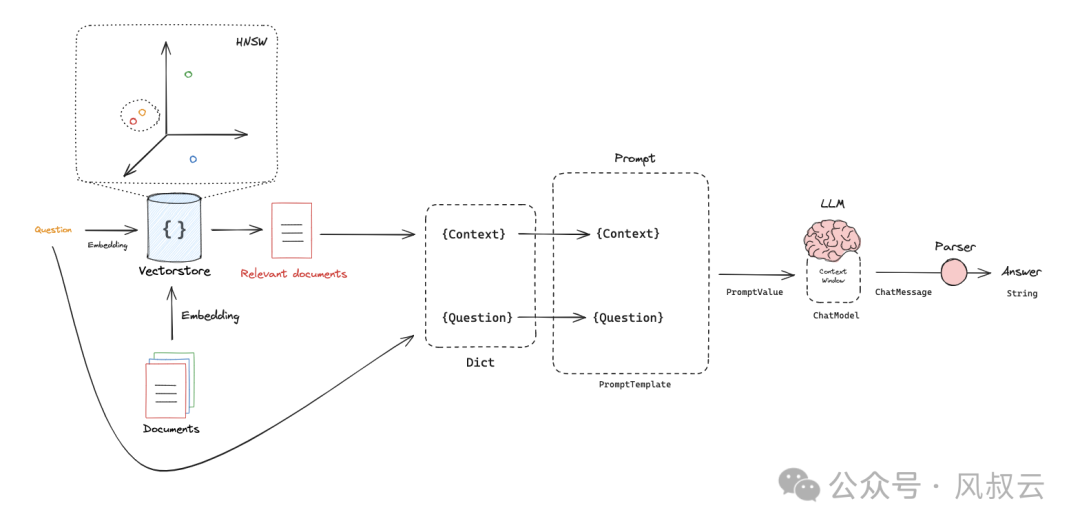
生成环节,我们先定义Prompt。先跑通流程,我们定义一个最简单的Prompt
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate
# Prompt
template = """Answer the question based only on the following context:{context}
Question: {question}"""
prompt=ChatPromptTemplate.from_template(template)
然后调用大模型生成最终回复,我们使用了gpt-3.5-turbo。我们先把temperature调到0,减少大模型输出的随机性。
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough
llm = ChatOpenAI(model_name="gpt-3.5-turbo", temperature=0)
rag_chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser())
rag_chain.invoke("What is Task Decomposition?")
到这里,一个最最简单的Rag系统就搭建完了,其原理非常简单易懂。“麻雀虽小,五脏俱全”,大家也可以拿这段代码自己做一些修改,比如读取pdf文件、word文档等等。
经过上述流程,我们搭建了一个非常简单的Naive RAG系统,这个系统解析了一篇博客文章,然后接收用户提问,并使用博客的内容做增强生成。这是一个非常简单的框架,也很易于理解。
但是在实际应用中还有非常多需要优化的地方,包括Indexing(索引)、Query Translation(查询转换)、Routing(路由)、Query Construction(查询构建)、Retrival(检索)和Generation(生成),每个环节都有多种有效的优化方式。
在下一篇文章中,风叔将重点围绕Indexing(索引)环节,详细介绍优化索引的四种高级方法。
本文由人人都是产品经理作者【风叔】,微信公众号:【风叔云】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自Unsplash,基于 CC0 协议。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。