







现阶段,各个公司都有自己的大模型产品,有的甚至不止一个。除了小部分开源外,大部分都选择了闭源。那么,头部开源模型厂商选择开源是出于怎样的初衷和考虑?未来大模型将如何发展?我们来看看本文的分享。
在对人工智能发展史的观察中,我们发现了AIGC以及它背后的大语言模型在近年高速发展的诸多偶然与必然(可回顾历史文章《关于AIGC崛起与行业发展,我有几点小观察…》
但近两年,大批大语言模型应用的涌现以及“百模大战”的兴起,却与“模型开源”这个动作密不可分。
除了开放性,现阶段的开源和闭源大模型在盈利模式、商业打法、发展策略等方面有何区别?头部开源模型厂商选择开源又是出于怎样的初衷和考虑?未来开源和闭源大模型将如何发展?下文揭晓。
在大众的认知中,开源软件往往指向完整共享源代码,任何人都能使用、检查、修改和分发其源代码的产品。
在计算机科学与技术发展进程中,Linux(操作系统)、Python、JavaScript(编程语言和框架)、MySQL(数据库)、Transformer(深度学习框架)等产品的开源都显得意义非凡。
开源大模型虽属开源阵营中的一员,但现阶段大多数开源的大模型并不像开源软件那样共享完整的源代码、数据集、训练过程等细节,更多属于权重方面的有限开源。
这里面有大模型开发的数据量级、训练复杂度等方面的原因。因为这层缘故,大多数开源模型更多依靠开源方来推动产品研发和迭代,社区贡献度有限。
但即便如此,它让大批开发者能在较低使用成本的基础上,根据自身实际需求进行灵活调整,并解锁更多商业场景和收益,也足以极大刺激整个产业的发展与繁荣。
闭源大模型和大多数闭源软件差异不大,通常指不对外分享源代码,仅所有者能合法访问、修改和分发,经封装后对外进行商业化变现的大模型产品。用户一般只能在付费后按既定方式使用。
区别于开源产品经常采用的“开源方主导+社区共建”的开发模式,闭源大模型高度依赖开发方的自主研发和长线运营,主要通过知识产权的价值货币化快速获取收益。
因为闭源大模型较之开源大模型存在更高的使用门槛,开发方会倾向于将大模型封装成各种标准化的产品,方便各类开发商在此基础上创建应用,并按实际消耗的tokens量、专有许可费等收费。
为了丰富业务线,目前主流的闭源大模型厂商也有基于底层模型推出AI应用,收取相应的产品订阅、调用、定制化等费用,以扩大整体营收。
两者迥异的开发形态和商业模式,决定了开源大模型前期更多通过免费/低价获客和生态合作,壮大基本盘,实现对关联业务的加持或业务场景及客源的拓展,服务于未来的财务增长。
而闭源大模型则更多采用“模型即服务”和应用拓展,直接进行商业变现,服务于当下的业绩增长。
当两者结合,共同推动了大语言模型的发展,加速着通用人工智能时代的来临。
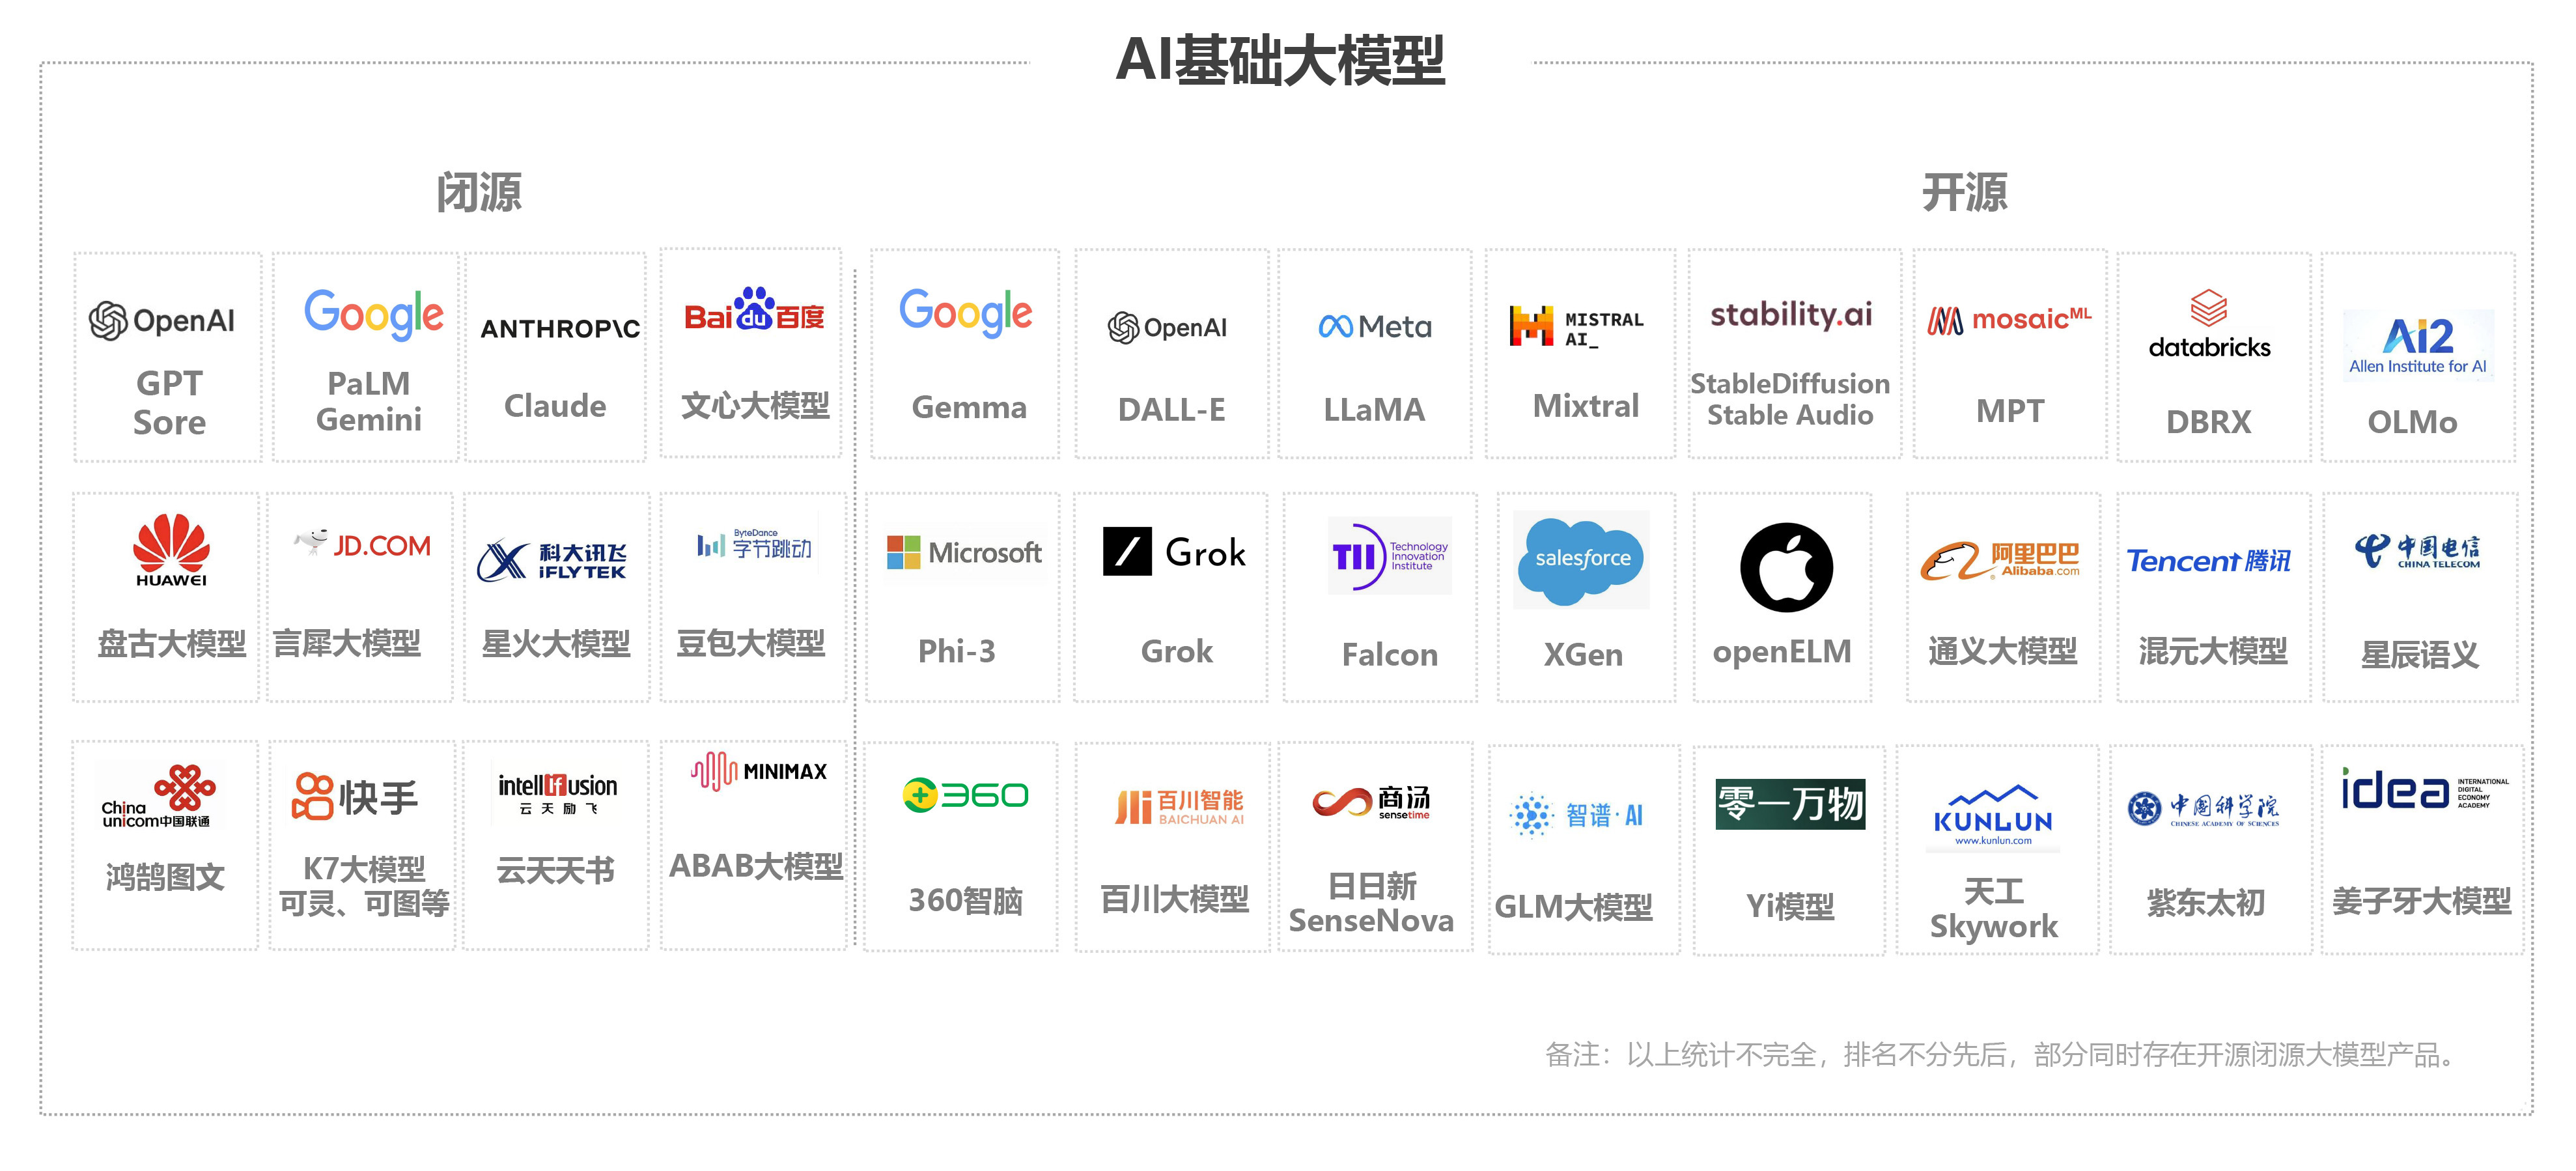
就在最近,业内对开源和闭源大模型的讨论声不绝于耳。
孰是孰非这里不论,不过个人比较认同“我们都是受益于开源成长起来的个人和公司”这句话(摘自360创始人周鸿祎的公开发言)。
而且,在整理媒体对当下主流开源大模型掌舵人的采访时,我们发现:各家选择开源自家大模型产品,背后的商业考虑与决策依据其实挺耐人寻味。总结起来,主要包含以下几点:
1)保障技术安全与良性发展。
比如包括Meta CEO扎克伯格、Mistral创始人Arthur Mensch等在内的头部开源大模型厂商leader都有提到:模型的开源会是保障大模型技术安全,解决安全漏洞的有效措施。
而且伴随用户使用的增加,能更好地集思广益,改善模型适用性与标准性,实现良性发展。这点与以往的开源软件宗旨算是一脉相承。
2)实现产业赋能。
鉴于当前基于全栈国产化基础软硬件的平台不多,已开源的多模态本土大模型产品也少,以中国科学院自动化研究所为代表的“国家队”选择开源自研的紫东太初大模型,则更多是想通过“大模型+小数据”的形式,推动大模型对产业带来的赋能。
3)促成生态合作共赢。
作为开源大模型赛道的代表性厂商,Meta坚持开源Llama系列大模型,则很大程度上源于对未来发展的考虑。
在公开采访中,Meta CEO扎克伯格曾表示:开源对Meta AI的未来发展有利。对于整个科技领域来说,大模型的开源也显得意义深刻,能创造更多赢家。
国内方面,以智谱为代表的本土大模型厂商,通过开源ChatGLM-6B,在加速全球下载量的同时,催生了600+优秀大模型应用开源项目,此举进一步推动了产业融合和AI生态建设。
4)为商业化做准备。
虽然开源意味着很难直接大规模商业变现,但作为获客或打开知名度的手段,却效果斐然。
比如2023年成立的Mistral AI ,因发布Mistral 7B、Mistral 8X7B两大开源模型一举成名,之后再推商业化模型,已能在业内快速打开局面,近期官宣获得6.4亿美元B轮融资。
而Llama系列的开源让Meta保持在AI领域的独特优势,反哺社交、广告等业务的同时,也打开了和云服务商、AI硬件平台等合作的另一种可能。
除此之外,出于提升行业地位、扩大商业机会等考虑,也推动着不少大模型开发商选择了开源,以争取在商业生态中的竞争优势或长远发展。
目前,有人认为开源大模型和闭源大模型处在对立面,未来必将像零和博弈一般,你输我赢,此消彼长。
不过在个人看来,两者的关系未来很可能像开源软件与闭源软件一样,长期共存,各自发展。
在这其中,开源产品能达到闭源产品很难企及的用户覆盖面与创新自由度,而闭源产品能更快、直接转化为商业利益,进一步提升产品迭代速度和服务质量。
两者就像Linux与Windows,Android与iOS,虽然有竞争,但互为补充,各自在擅长的领域开疆拓土。
只是在入局者越来越多、产品越来越卷的当下,未来市场难免会经历洗牌,只保留少数头部、更具有竞争优势的选手。
这也是眼下国内外大模型厂商热心于竞争生态位或出于商业化考虑,反复切换开源和闭源赛道,或丰富业务线以保持自身优势的一大原因。
比如谷歌在推出闭源大模型Gemini Ultra的同时,发布了Gemma 2B 和7B两款开源模型产品。Mistral在推出Mistral 7B、Mistral 8X7B两大开源模型后一炮而红,新推出的旗舰版大模型Large 则为闭源产品。
出于成本压力和商业化考虑,目前开源大模型厂商和闭源大模型厂商的界限正逐渐模糊。
不过抛开这些,就整个行业来说,开源和闭源大模型的百花齐放,推动了AI上层应用生态乃至整个行业的繁荣,也为人们以较低门槛使用人工智能产品带来了便利。
备注:本文原创,首发司普科技,第三方首发人人都是产品经理。有参考segmentfault、钛媒体、智东西等,仅做分享。
本文由 @iseeworld 原创发布于人人都是产品经理。未经许可,禁止转载。
题图来自 Pixabay,基于 CC0 协议
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。