






近几日,OpenAI发布视频生成模型Sora,各大自媒体的营销内容更是为Sora增加了神秘色彩。本文详细阐述了Sora实现原理,希望对你有所帮助。
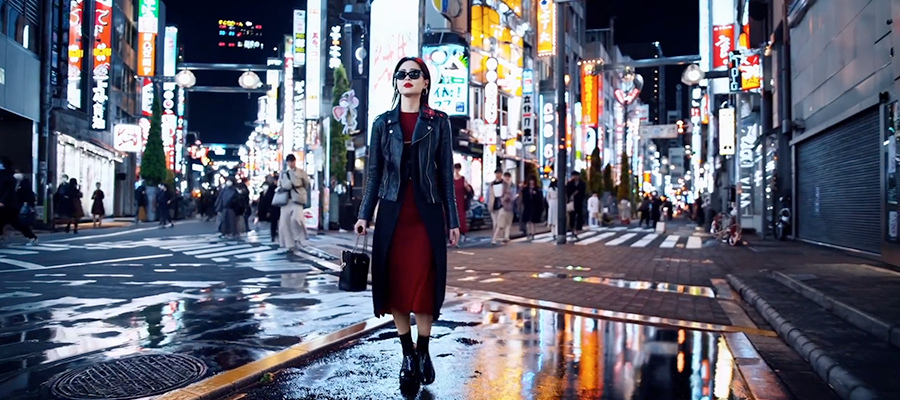
近几日,关于OpenAI发布视频生成模型Sora的消息甚嚣尘上,各类自媒体的营销内容更为Sora增加了神秘色彩。
就说Sora有多火吧,生成的视频上线一个,疯传一个。
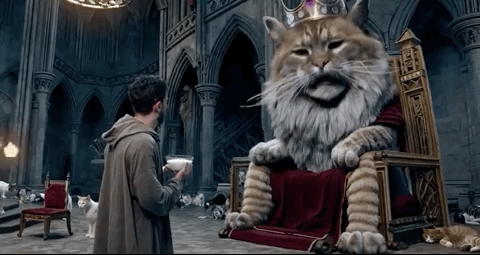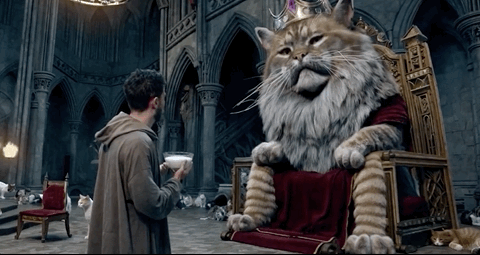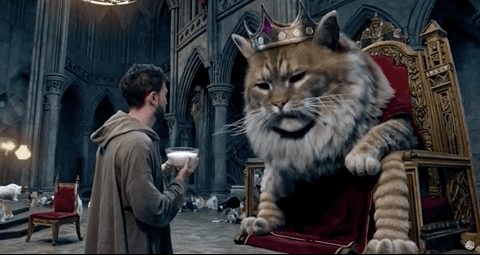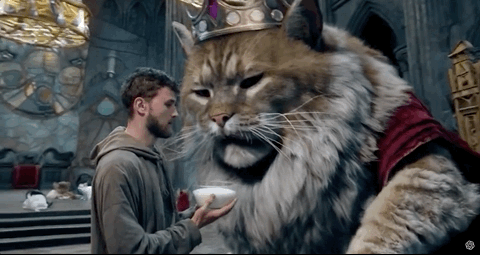
人类向猫王朝拜
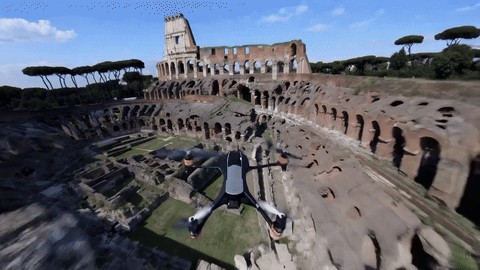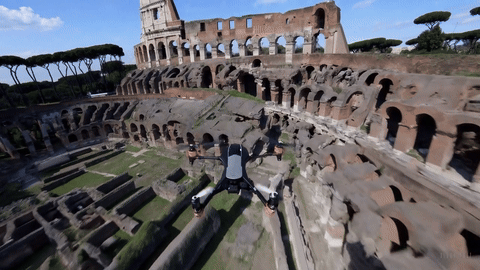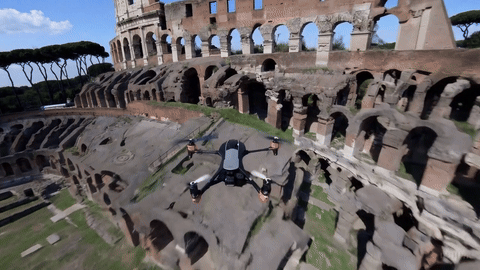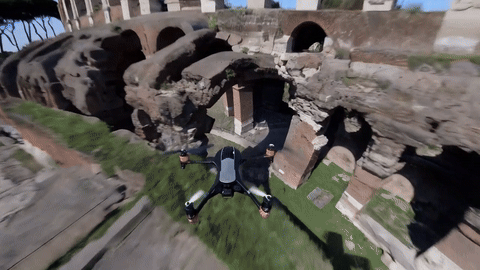
无人机穿越古建筑
明显能看出来Sora生成的视频中的各项细节都让人惊叹,一如去年的ChatGPT,Sora被认为是AGI(通用人工智能)的又一个里程碑时刻。
然而,大众所看到的文生视频也仅仅是一个表象而已,Sora模型之所以如此轰动,并不只是因为AI生成的视频时间更长、清晰度更高,而是OpenAI已经超越过去所有AIGC的能力,生成了一个与真实物理世界相关的视频内容。
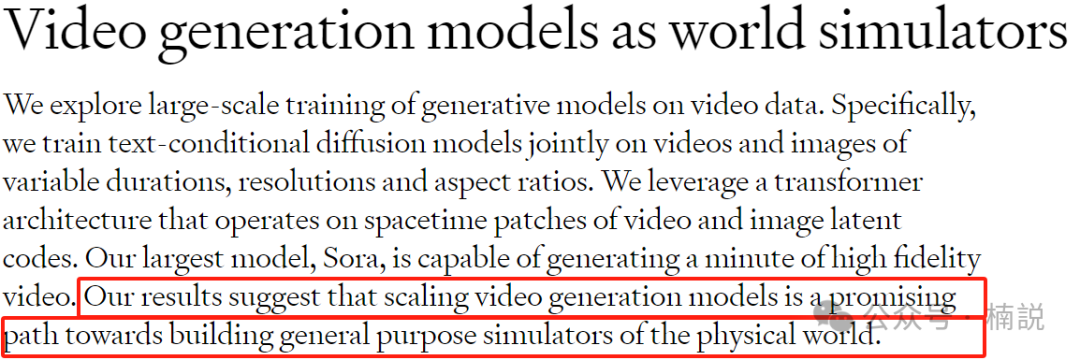
在OpenAI官方出具的技术报告中,对Sora的定位是“作为世界模拟器的视频生成模型”,“我们的研究结果表明,扩展视频生成模型是构建物理世界通用模拟器的一条可行之路。”
由于Sora的技术原理和细节尚未公开,而Sora也没有进行公测。我仅从现有OpenAI公布的的技术报告以及AI领域的专家和学者对其分析来了解Sora如何是处理多样化视觉数据的,我会用通俗的语言和一些好理解的例子来解释Sora是如何完成视频创作的。
在这之前,我们先想一下我们自己是如何理解这个世界?
当你日常从各类渠道或者新闻媒体,短视频平台上获取信息时,即使没去过的地方,没见过人或物。尽管你所掌握的这些信息内容和风格各异,但你仍能在需要时轻松地辨识提取每一个信息片段(Token),因为你的大脑能够将这些不同的视觉信息统一理解。所以你可以通过获取的信息并在脑海里构想物品或者画面;你可以在梦境中见到从未见过的人或物;你甚至在梦境中可以出现一些违背物理常识体验,比如自己在空中骑着扫帚飞。
现在,让我们将这个过程与Sora处理多样化视觉数据的方式进行对比。Sora首先通过自学习理解来自世界各地、不同设备拍摄的数以百万计的图片和视频。这些视觉数据在分辨率、宽高比、色彩深度等方面都存在差异。为了让Sora能够像人类大脑那样理解和生成这么丰富的视觉内容,OpenAI开发了一套将这些不同类型视觉数据转换为统一表示形式的方法。
对,没错,Sora就是像人理解世界一样去构建模拟一个属于Sora的世界。不同于 Runway 、Stable Video Difusion 等扩散模型主要采用经典的 U-Net架构,Sora 用 Transformer 架构替 换 U-Net 架构,大幅提升模型扩展性。
Sora 的训练受到了大语言模型(Large Language Model)的启发。这些模型通过在互联网规模的数据上进行训练,从而获得了广泛的能力。——引自OpenAI对Sora模型技术报告详解
首先,Sora通过“视频压缩网络”。
技术,将这些输入压缩为较低维度的表示形式。随后,这些压缩数据被进一步分解为“空间时间潜在补丁”(Spacetime Patches)并处理为一致的格式。在接收到我们的文本条件,即最小信息片段(Token)后,Sora通过理解这些信息片段,从时间和空间维度逐步勾勒出视频画面。
请注意,上述无论是通过该“视频压缩网络”技术对输入进行压缩的过程,还是进一步分解为“空间时间潜在补丁”(Spacetime Patches)的过程。这并不意味着会忽略原始数据的独特性,而是将它们转换成一个对Sora来说更容易理解和操作的格式。而分解补丁则可以看作是视觉内容的基本构建块,就像是我们把一副拼图打散后,拼图的每一块卡片都是包含独特景观、颜色和纹理的小片段。这样,不管原始视频的长度、分辨率或风格如何,Sora都可以将它们处理成一致的格式。
这就像你在将拼图复原时,尽管拼图卡片有几千个之多,但你依然能通过已有的参照和相同的方式去复原它们。
上面我们阐述了Sora如何对输入进行分解到最基本的构建块“空间时间补丁”(Spacetime Patches),接下来我们顺着这一概念来探讨Sora如何根据文本提示生成内容的机制。这一过程核心依赖于一种名为“文本条件化的Diffusion模型”。
现在设想你手握一本绘画本,初始时,本子上仅有一些杂乱无章的线条,看似毫无意义。然而,当被告知主题,例如“描绘一座花园”时,你脑海中便会自发地搜索与“花园”相关的所有信息片段。接着,你将这些零散的信息逐步呈现在绘画本上,并不断修改和优化已有的笔触。最终,这些混乱的线条渐变为一幅精致的花园画卷。在此过程中,“指定的主题”类比为文本提示,而你逐步完善草稿的过程则与Diffusion模型的运作方式相似。
就像你画一幅“花园”时,这个过程并不是一蹴而就的,而是通过数百个渐进的步骤完成的,每一步都会让视频离最终目标更进一步。这种方法的一个关键优势在于其灵活性和创造性:同一段文本提示,通过不同的噪声初始状态或通过稍微调整转化步骤,可以生成视觉上截然不同、但都与文本提示相符的视频内容。这就像是多个画家根据同一主题创作出风格各异的画作。通过这种基于文本条件的Diffusion模型,Sora不仅能生成具有高度创造性的视频和图片,还能确保生成内容与用户的文本提示保持高度一致。
具体到Sora的实现,这个过程开始于一段与目标视频同样时长、但是内容完全是随机噪声的视频。可以把这段噪声视频想象成草稿本上那些毫无意义的线条。随后,Sora根据给定的文本提示(比如“一只小狗站在草坪上,伸着舌头”)开始“涂改”这段视频。在这个过程中,Sora利用了大量的视频和图片数据学习到的知识,来决定如何逐步去除噪声,将噪声视频转变成接近文本描述的内容。
这种处理多样化视觉数据的能力,使得Sora在接收到如‘一只小狗站在草坪上,伸着舌头’类似这样的文本提示时,正如OpenAI的技术报告中提到“Sora 的训练受到了大语言模型(Large Language Model)的启发。这些模型通过在互联网规模的数据上进行训练,从而获得了广泛的能力。”使得Sora不仅能理解这个提示背后的意图,还能利用它的内部表示形式,综合利用不同类型的视觉信息,生成与文本提示相匹配的视频或图片。就好比是从全世界的视觉数据中找到那些能够拼凑出你想象中的“一只小狗站在草坪上,伸着舌头”场景的片段,并将它们组合起来,创造出一个全新的视觉作品。
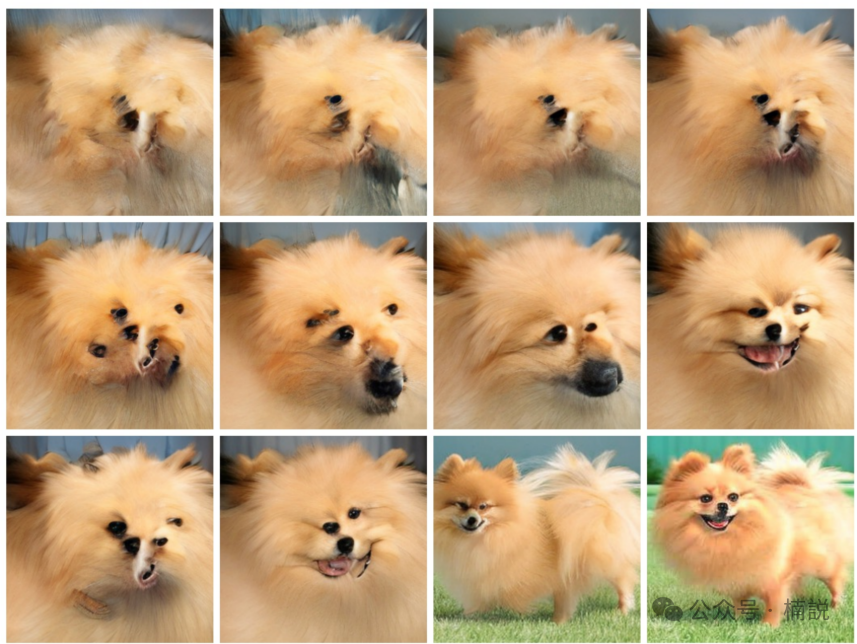
引自《Scalable Diffusion Models with Transformers》论文
文本条件化的Diffusion模型赋予了Sora强大的理解和创造力,让它能够跨越语言与视觉之间的障碍,将抽象的文字描述转化成具体的视觉内容。这一过程不仅展示了AI在理解自然语言方面的进步,也开辟了视频内容创造和视觉艺术领域的新可能性。
而其他文生视频的平台如Runway、Pika等还停留在通过像素来构建视频画面,这也是为什么其他像Runway,Pika等生成的视频扭曲会这么严重的原因,他们仅仅是通过让静态图片的部分元素动起来进而生成视频的。
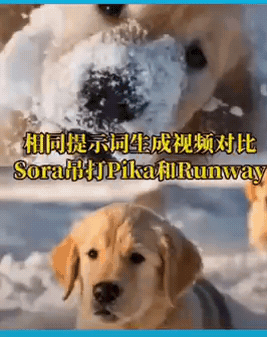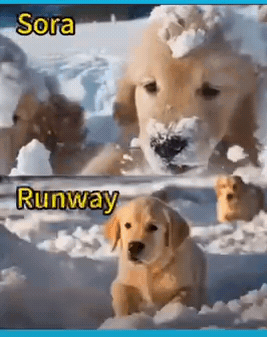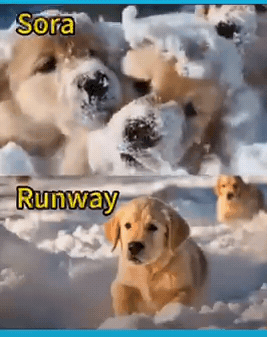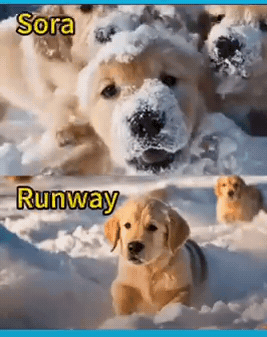
Sora生成的小狗玩雪活灵活现,而Runway则是像定格动画
以上我用通俗的语言解释了Sora的原理和与其他平台的差异。先不用管上述描述中一些陌生的概念,你只需要用你是如何理解这个世界的方式来理解Sora的实现原理,当然Sora的原理也不仅仅是如我所说的这么简单,我只是在已有研究的基础上,通过这几天的学习和理解加上一些生活中的例子来试图解释Sora。
这次 Sora 的发布又让很多人对 AGI 的实现更加乐观了。360董事长周鸿祎作出预判——Sora的发布意味着AGI实现将从10年缩短到1年。
Sora的发布是否会真正开启AGI(Artificial General Intelligence 人工通用智能)时代的大门,我们还不可知。但是肯定会对视频制作,游戏画面等行业产生影响,试想一下以往制作一部电影制作特效需要花费的时间和人力以及制作游戏需要对游戏世界进行建模,模拟真实世界的物理规律,这些虽然我们已经可以做到,但是是通过一种最笨的方式去构建我们想象的世界的样子,但是Sora在大语言模型的基础上,以一种全新的思路为我们提供了另一种方式来构建和模拟真实世界,而且这种方式还是更简单,更快捷的。
正如OpenAI 技术报告的结尾是一个《我的世界》的游戏视频,旁边写着这样一句话:“ Sora可以通过基本策略同时控制Minecraft中的玩家,同时高保真地呈现世界及其动态。只需在Sora的提示字幕中提及‘Minecraft’,就能零距离激发这些功能。
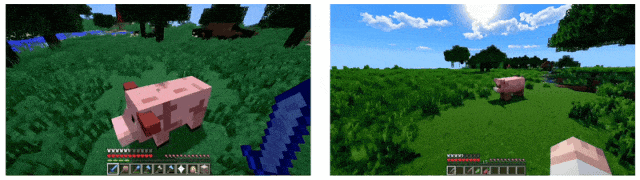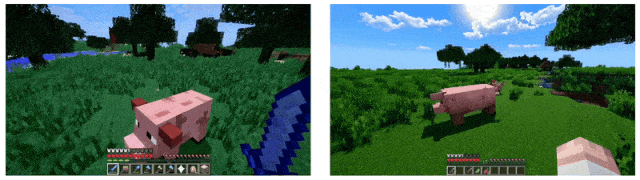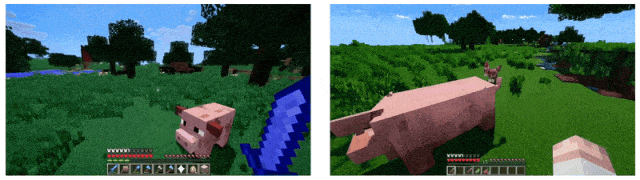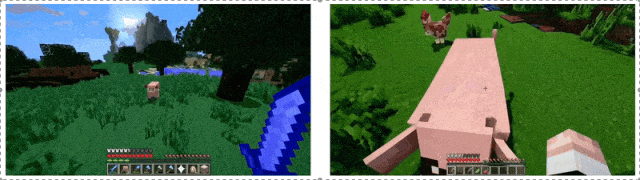
Sora 如果真能实现对物理世界的模拟、能够跟 LLM 代表的虚拟世界无缝融合,那它必然是通往 AGI 路上的里程碑。
今天就写这么多吧。手动码字,还请点个赞吧!!
本文由@楠説 原创发布于人人都是产品经理,未经作者许可,禁止转载。
题图来自Sora文生视频演示截图
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。