








近日,生数科技与清华大学联合发布了「Vidu」文生视频模型,那么这一模型,是否可以和 OpenAI 的 Sora 实现对标?一起来看看本文的解读。
2 个月前,OpenAI 发布了全新的文生视频模型 Sora,瞬间引爆了全球科技圈,也让马斯克说出了「人类愿赌服输」。在那之后,没有任何一个大模型敢于在文生视频领域「挑衅」Sora。
现在,事情有了变化。
在 4 月 27 日举办的 2024 中关村论坛上,生数科技与清华大学联合发布了「Vidu」文生视频模型,全面对标 OpenAI 的 Sora。
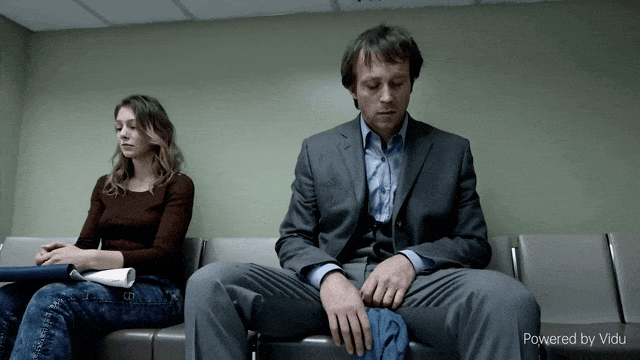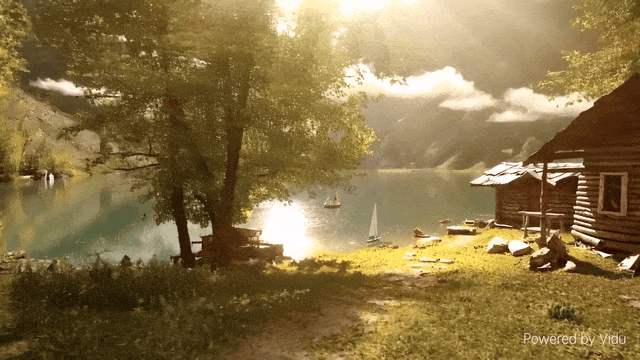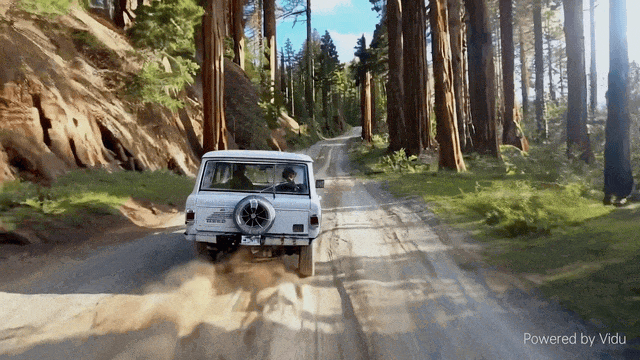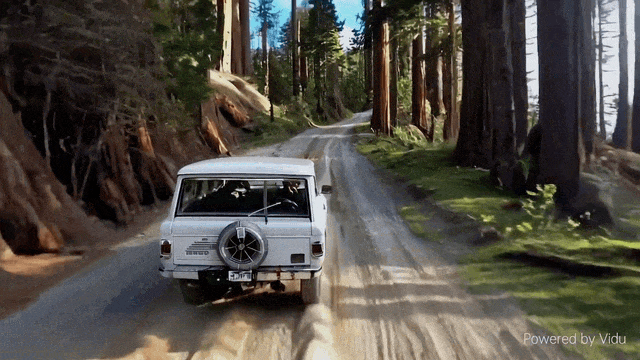
Vidu 生成,动图经过压缩。图/生数科技
不仅是在视频生成分辨率和时长上,最关键的根据官方放出的生成视频,Vidu 已经实现了相当程度的「拟真」——模拟真实世界的物理原理,以及主体的一致性。这是 Vidu 真正对标 Sora 的底气。
但 Vidu,离 Sora 到底还有多少差距?
从这次发布可以看出,Vidu 处处都在对标 Sora。同样是通过提示词直接生成视频,同样支持最高 1080P,虽然 16 秒的生成视频时长还明显短于 Sora(最长 60 秒)。
最明显的还是生成的视频内容。
比如 Sora 街头行走这一段,相信会看这篇文章的读者应该都看过,一度刷爆了各大社交媒体。
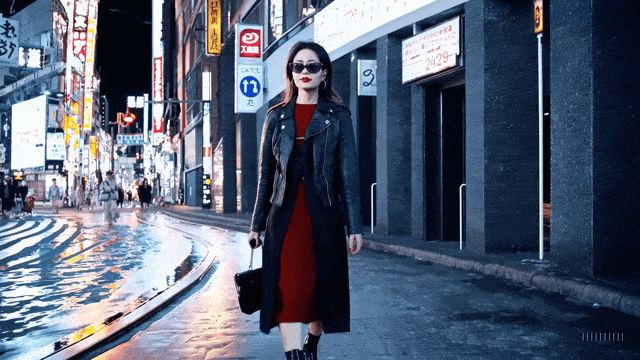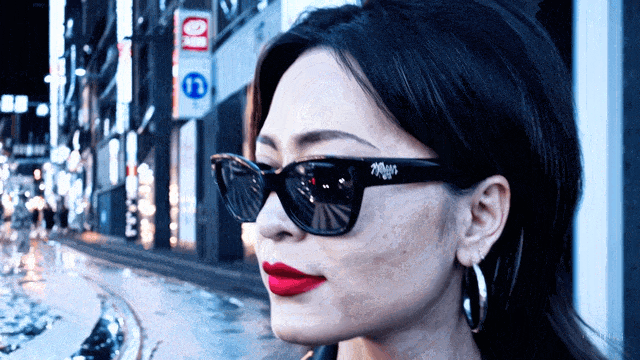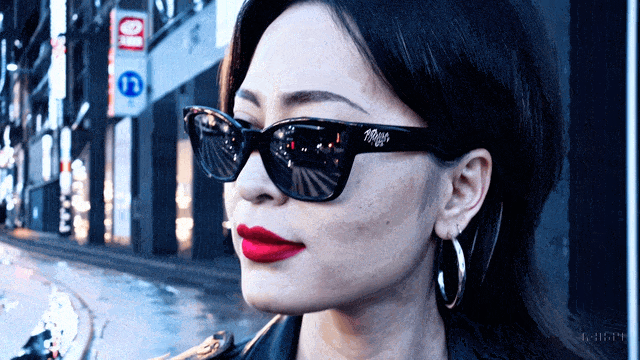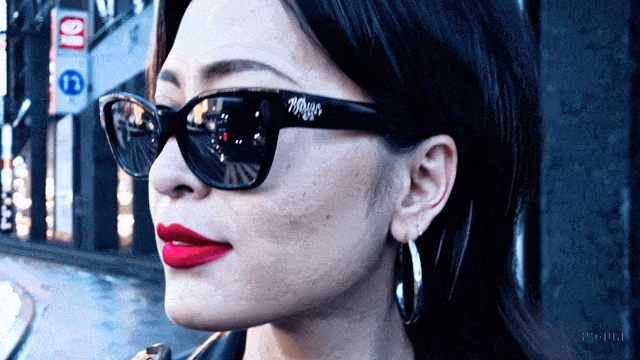
Sora 生成,动图经过压缩。图/ OpenAI
Vidu 也同样生成了类似的视频内容,开始展示了一男一女一熊走在街头的画面,随后又重点展示了熊人的背景街道。
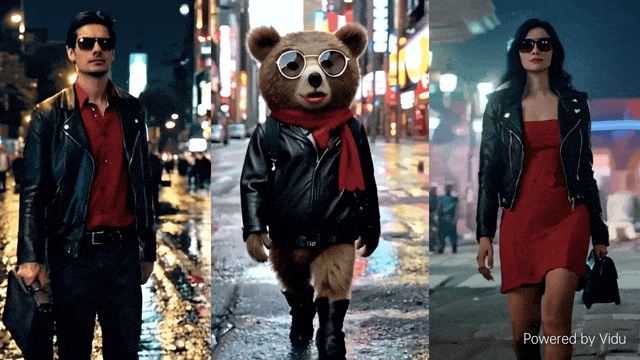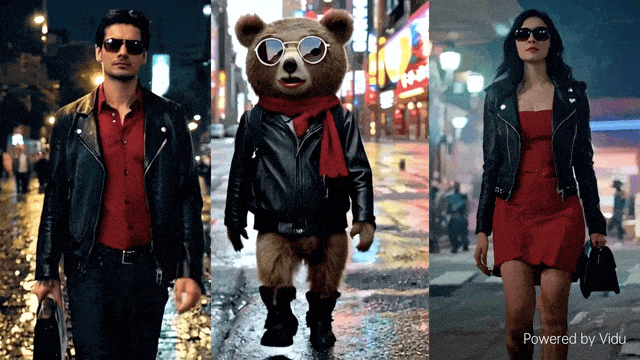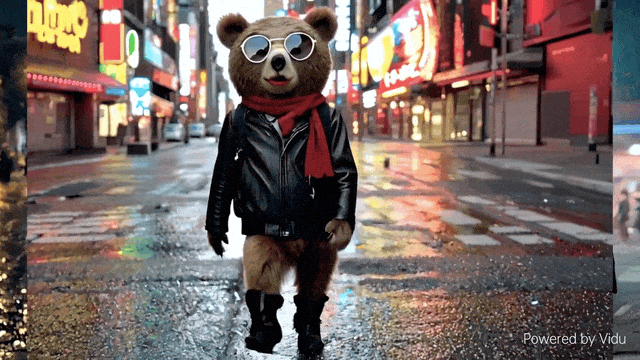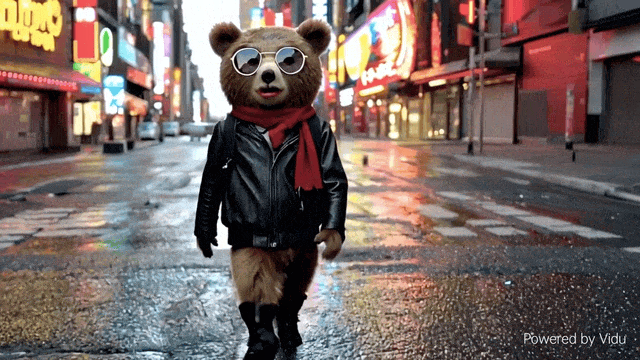
Vidu 生成,动图经过压缩。图/生数科技
虽然相比 Sora 那段少了很多震撼和细节展示,但不管是皮衣的质感,还是路面的反射和倒影,Vidu 其实都展现了非常有说服力的效果。
更重要的是,背景、人物主体是一致的,并没有在前后发生大的变形或变化。
类似的表现还出现在其他生成视频上。
比如开车这一段,镜头一直跟随着汽车前移,但路旁的树木和汽车主体始终没有发生变化,并不像很多扩散模型一样,这一秒和下一秒的主体都可能出现明显的差异。

Vidu 生成,动图经过压缩。图/生数科技
不过在保真度上,Vidu 还是和 Sora 有比较明显的差距。相似的提示词(内容)下,Sora 开车这一段的背景明显更接近真实世界,用比较通俗的话讲,Vidu 有点「油画」。

Sora 生成,动图经过压缩。图/ OpenAI
但显然,Vidu 作为国产大模型,还是更懂中国。
Sora 在之前曾经生成过一段街头「舞龙」的视频,而 Vidu 干脆直接生成了一段「真龙」的视频,背景是辉煌的宫殿群。
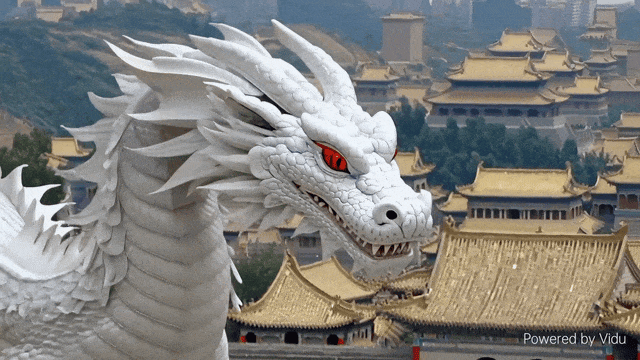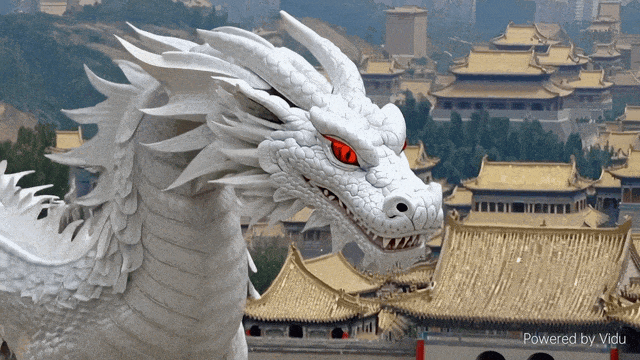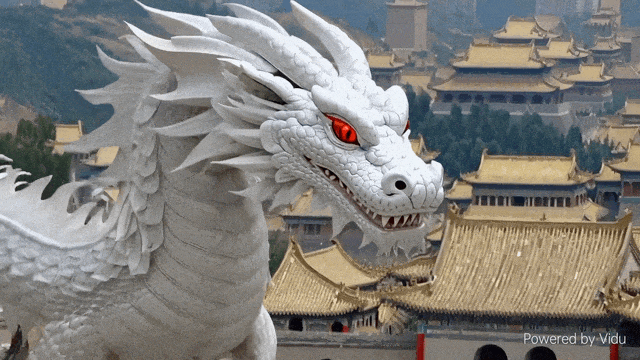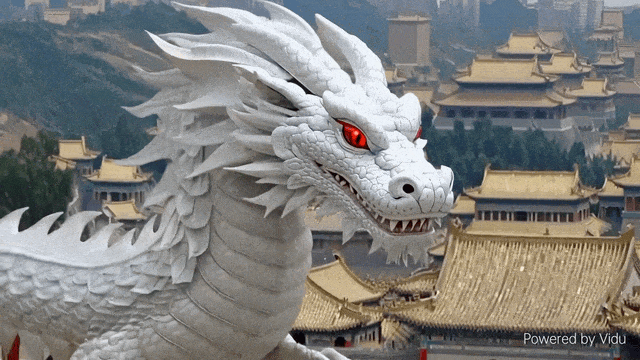
Vidu 生成,动图经过压缩。图/生数科技
如果 Sora 的重点与其说是舞龙,实则更像展现「围观群众」的惊人模拟,那 Vidu 就是真真正正模拟了一条龙。
此外,Vidu 还生成了一段「熊猫在湖边弹吉他」,除了主体上的拟真,背景部分的草地、湖水都相当程度地「真实」。
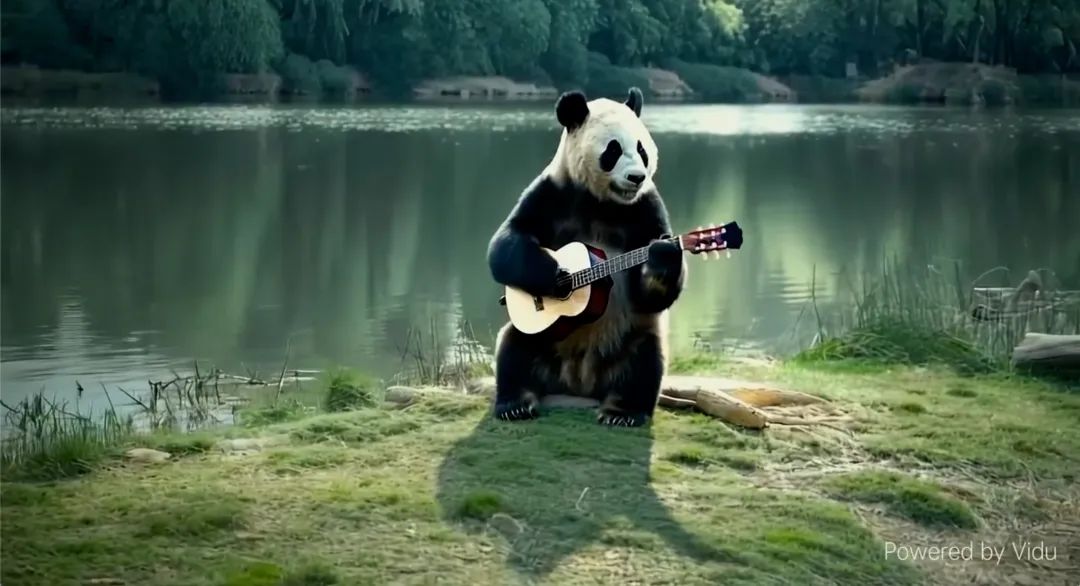
Vidu 生成片段截图,非动图。图/生数科技
在人物生成上,Vidu 也有一组画面充分展示了它的实力,从面部表情、眨眼到抬头,都非常接近实拍镜头。就算比起 Sora 的人物镜头,也不逊色多少。
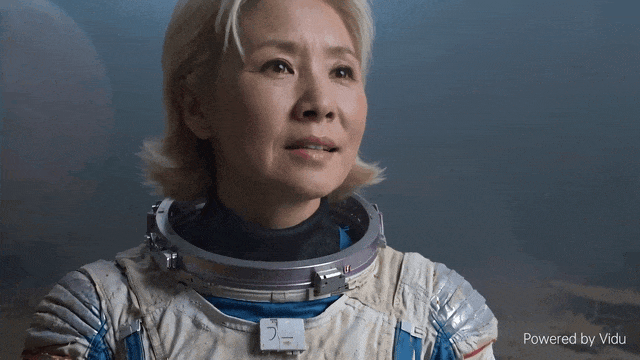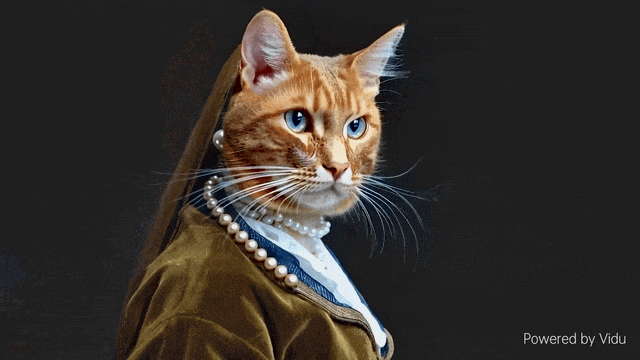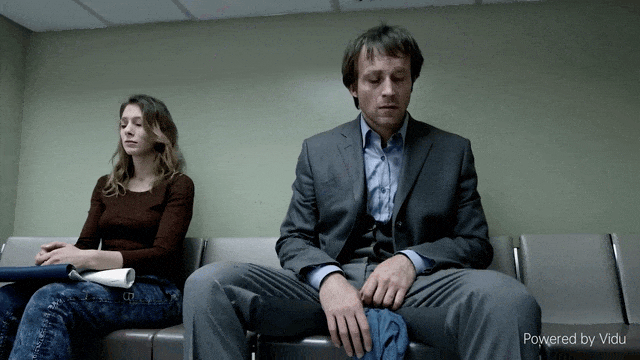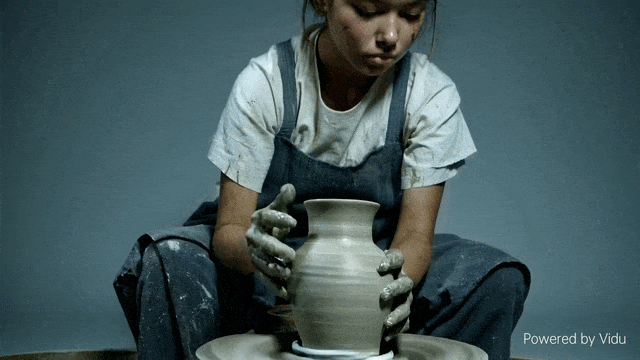
Vidu 生成,动图经过压缩。图/生数科技
另外考虑到要参与视频内容制作流程,这类文生视频模型也绕不开「镜头调度」的能力,事实是 Vidu 依然展示了相当不错的水平。
总的来说,虽然有 Sora 珠玉在前,但从目前公布的生成视频来看,Vidu 依然展示了极高的视频生成能力,或者说是模拟物理世界的能力。或许在生成复杂画面、保真度等方面还差 Sora,但有一些镜头完全称得上可用,这已经是一个很大的进步。
当然,Sora 的反方向跑步,Vidu 的「人物」突然长出第三条腿,都说明即便 AI 在视频生成领域有了跨越性的进步,仍然还有很大的提升空间。
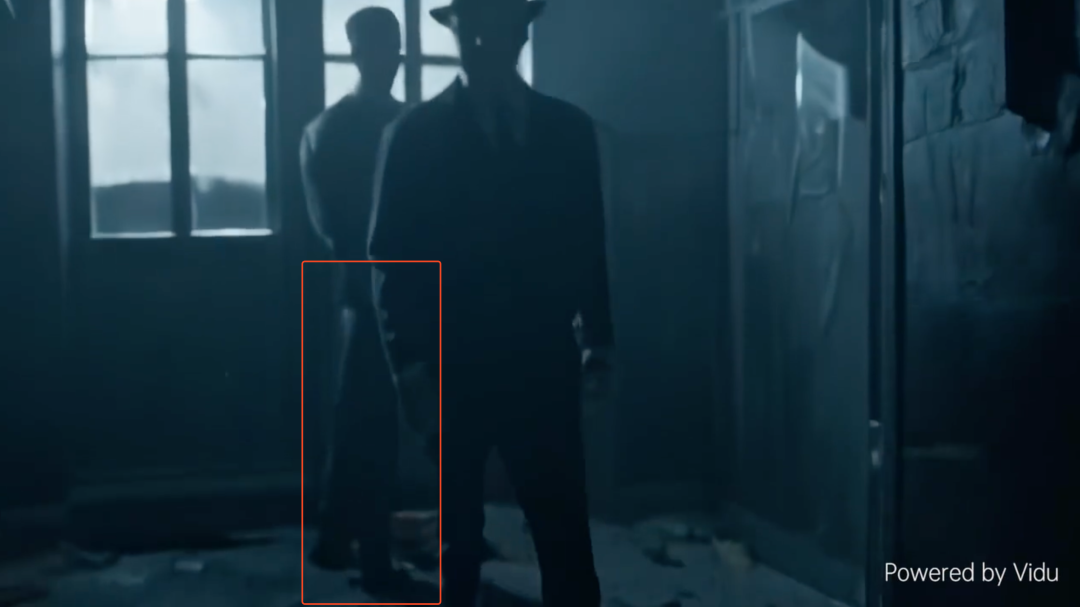
突然出现的第三条腿。图/生数科技
正如 OpenAI 在 Sora 发布之初承认的,这类模型当前存在一定的局限性,比如无法模拟复杂场景的物理效应,理解某些特定因果关系等。
看起来,Vidu 就好像 Sora 一样横空出世,以相当惊艳的表现引起刷屏,而且同是基于对 Transformer 与 Diffusion 架构的融合。但很多人并不知道,生数科技联合创始人兼 CEO 唐家渝上个月就透露过:
「今年内一定能达到 Sora 目前版本的效果。」
不仅如此,这家几乎可以算是从清华大学人工智能研究所「孵化」出来的初创公司,在 2022 年 9 月就提出了融合 Diffusion 和 Transformer 的 U-ViT 架构,比 OpenAI 提出 DiT 架构(Sora 的底层架构)还要早。
甚至因为发布时间更早,计算机视觉顶会 CVPR 2023 提前收录了清华大学的 U-ViT 论文,而以「缺乏创新」为由拒绝了 OpenAI DiT 论文。
但总的来说,这两家公司的思路大体一致。
目前市面上大部分视频生成模型都是基于 Diffusion 架构的扩散模型,比如 Stable Video Diffusion。OpenAI 和生数科技则是引入大语言模型底层的 Transformer 架构,在一定程度上,解决了文生视频一直以来前后一致性和视频长度过短的问题。
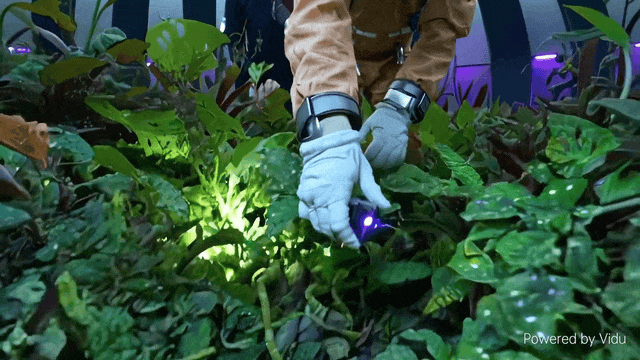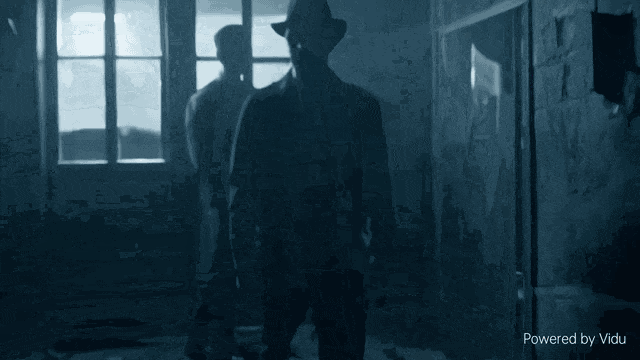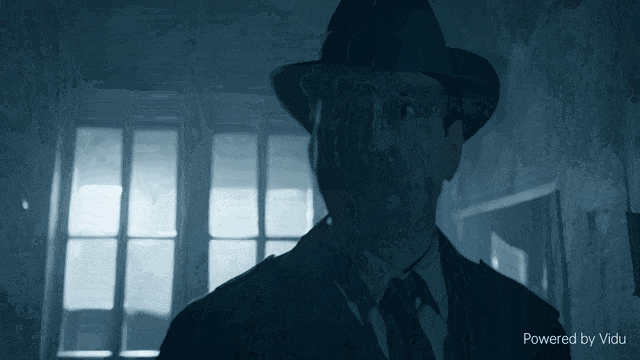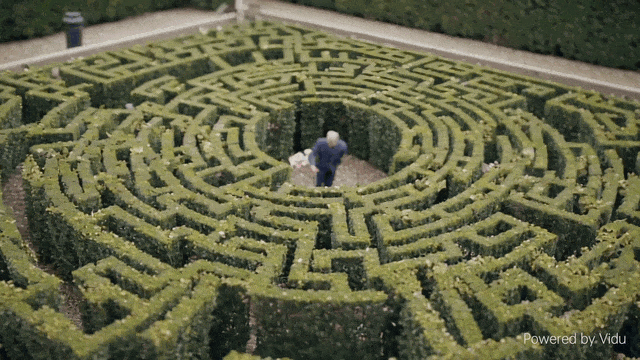
Vidu 生成,动图经过压缩。图/生数科技
所以在 Sora 和 Vidu 生成的视频中,你可以说有很多不完美,但在保证主体和背景一致性上,它们都有了实质性的飞跃,几乎不会看到有人物边走边变形的情况,背景不会时刻在变,场景也不会在没有任何转场的情况下突变。
不过很多人可能还有一个问题:明明更早提出融合架构,生数科技为什么更慢?甚至效果还差一些?
事实上不难理解。要知道,生数科技正式成立于 2023 年 3 月,虽然在不久后获得了阿里、百度、字节等公司和机构的多轮融资,但最多也就融到数亿。相比之下,OpenAI 背靠微软,在算力、数据、资金、人才等方面都有着更大的优势。
同时,这也会影响到 Sora 和 Vidu 完全不同的发展路径。
在接受 WSJ 记者采访时,OpenAI 首席技术官 Mira Murati 公开表示,Sora 最快将会在今年年内面向公众推出。考虑到 Sora 生成视频需要的海量算力,外界估计,可能将有限度地率先开放给 ChatGPT Plus 用户。
而据唐家渝表示,生数科技目前要走两条路。
一是打造覆盖文本、图像、视频、3D 模型等多模态能力的底层通用大模型,面向 B 端提供模型服务能力;二是自己面向图像生成、视频生成等场景打造垂类应用,面向游戏制作、影视后期等需求提供订阅制收费服务。
Sora 刚发布的时候,国内一片惊叹,又是一片哀嚎。
360 创始人周鸿祎说,Sora 将人类实现 AGI(通用人工智能)的时间从 10 年拉小到了 1-2 年,同时也进一步拉大了中美在 AI 领域的差距。还有更多人认为,尽管国内大模型众多,做视频模型的也不少,却看不到一个能够追赶 Sora 的竞争对手。
而 Vidu 的发布,至少再次证明了一切皆有可能。但如果说 Sora 的发布是一个开始,那我相信 Vidu 不是结束,「甚至不是结束的开始。但这也许是开始的结束。」
编辑:冬日果酱;来源:雷科技AI硬件组
来源公众号:雷科技(ID:leitech),聚焦科技与生活。
本文由人人都是产品经理合作媒体 @雷科技 授权发布。未经许可,禁止转载。
题图来自Unsplash,基于CC0协议
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。