


当 Codex 与飞书文档碰撞,数字分身计划却暴露了 AI 的认知鸿沟。本文作者将 2000 多份工作文档喂给 AI,试图打造能替代决策的'数字分身',最终得到的却只是低质 RAG 系统——它能检索显性知识,却无法复刻人类判断中那些未言明的隐性逻辑。这场实验揭示了当前 AI 在企业知识管理中的致命短板。
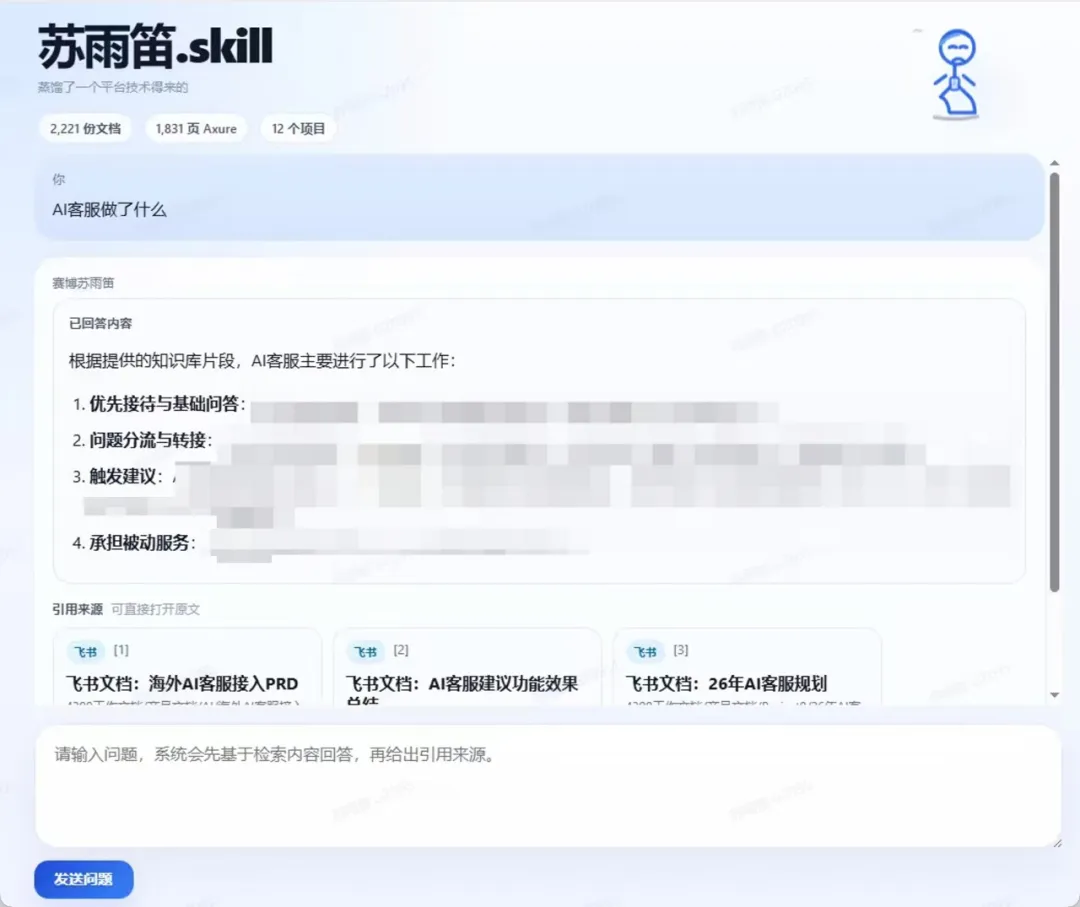
最近跑路了,为了方便交接,我用 Codex 调用飞书 CLI,把自己过去写过、参与过、沉淀过的 2000 多篇飞书文档和 Axure 原型全部拉了下来,让 AI 做解析,再基于这些内容构建了几层索引。
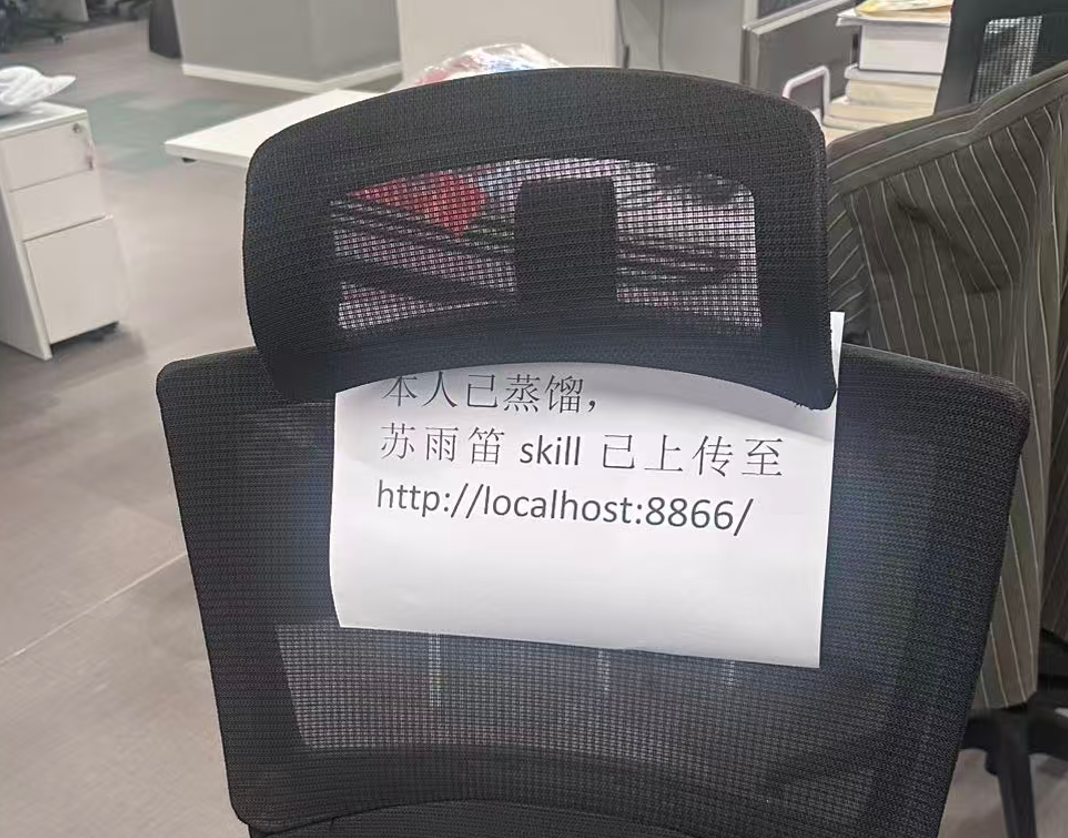
简单说,就是想把过去几年的“我”蒸馏出来,做成一个数字分身。
跑路后,业务就可以对着这个分身问一些问题,比如:“这个功能当时为什么这么设计?”、“XX系统里某个能力是怎么考虑的?”
这个想法听起来挺美好。毕竟文档都在,原型都在。按理说,只要把这些东西喂给 AI,它不就能接住我的历史经验了吗?
但实际用下来,我发现它没有变成“我”,只变成了一个低质 RAG。为什么它只是一个低质 RAG
这个蒸馏项目本质上只是把文档做成知识库,再接一个问答入口,它最多解决“找得到资料”的问题,很难“像这个人一样判断问题”。
RAG 论文里讲的 retrieval augmented generation,本质上是让模型在生成时检索外部知识,用来增强知识密集型任务的表现。但检索增强不等于判断增强。
它能把资料拿过来,不代表它知道资料之间谁更新、谁覆盖谁、谁只是草稿、谁才是当前口径;更不代表它知道这件事为什么这么做,以及到底该由谁负责。
所以我说它是一个低质 RAG,主要体现在三个特点上。第一个特点,是只能检索结论,不能理解判断。
它能根据问题找到相关文档,但不知道为什么这个功能当时要这么设计。比如业务问一个活动功能为什么没做,RAG 可能会找到活动方案、需求评审记录、某个版本范围说明,然后拼出一个回答。
但在游戏行业里,一个活动规则为什么没有做某个能力,通常不是只看最终方案就能理解的。可能不是产品忘了,而是当时版本排期不允许;可能是海外 SDK 的能力边界没开放;可能是活动目标只是短期拉活,不值得把长期系统能力做进去;也可能是运营、研发、发行、合规之间已经做过一次权衡。
文档里可能只写了最终方案:“本期暂不支持 XX 功能。”但人脑里记住的往往是另一层内容:“当时为什么暂不支持。”前者是结论,后者才是判断。所以它经常只能回答“资料上写了什么”,不能回答“当时为什么这么判断”。第二个特点,是能模仿人的口吻,但分不清责任边界。
最经典的一次,是业务问它海外 SDK、活动项目里某个功能是怎么回事,为什么没有记录。数字分身回答得很顺,甚至还很有担当,大概意思是:“这个功能我当时没有考虑到位。”
看起来是不是挺像一个离职同学在认真复盘?但问题是,这个项目根本不是我的项目。真是人在家里坐,锅从天上来。
更尴尬的是,相关记录其实在索引文档里也能找到。也就是说,它不是完全没有资料,而是没有理解清楚“这件事是谁负责的”、“我在里面扮演什么角色”、“这个问题应该归因到哪里”。第三个特点,虽有知识索引,但索引不到足够深的隐性知识。
一开始我以为,数字分身做不好,可能只是索引没建好。比如 chunk 切得不合理,向量检索召回不准,元数据不够细,Axure 原型解析得不完整,文档之间的关联没有建起来。
但是在我尝试了几轮后,问题并未被解决。因此,我觉得,更底层的问题是:就算索引建得更好,它索引到的也主要是文档里的显性知识。
比如 PRD 写了功能规则,会议纪要写了本次结论,Axure 原型画了页面状态,复盘写了这次活动的数据结果。这些内容有用,但它们不等于一个人做判断时真正调用的全部知识。
真正难复刻的是那些没有写深、甚至没有写出来的隐性知识。
比如一个活动功能为什么没做,文档里可能只写“本期暂不支持”。但实际判断里,可能还有一串背景:当时海外 SDK 还没开放对应能力,研发排期已经被版本节点卡死,活动本身只是一次短期验证,做成长期系统能力反而不划算,运营侧也接受用人工方式先兜一版。
这些才是产品经理脑子里真正用来判断的东西。
这些内容很少会完整写进文档。
Michael Polanyi 在《The Tacit Dimension》里有一个很经典的说法,大意是:人知道的东西,往往比能说出来的更多。这就是所谓的隐性知识。
放到这里,就是文档记录了“当时怎么做”,但没有完整记录“为什么这么做”、“为什么不那么做”、“谁能为这个判断负责”。
所以,当我把 2000 多篇文档喂给 AI 时,我其实只是把一堆显性知识喂给了它。但我希望它复刻的,是一个会把显性知识、隐性知识和当前环境放在一起判断的人。
这中间差的,不是多建几层索引就能完全补上的。这件事有解吗?
那么这件事有解吗?
我觉得有优化空间,但还没到能说“已经有成熟解决方案”的程度。因为它不是单纯的 RAG 问题。RAG 本身解决的是“让模型回答时能引用外部知识”。这个方向当然有价值。IBM、TechTarget 等很多资料也都提到,RAG 在企业里常见的问题,集中在检索不准、chunk 切分不合理、上下文窗口限制、复杂关系理解不足、知识过期和治理困难这些方面。
这些问题可以继续优化。比如把文档清洗得更好,补充元数据,区分版本、负责人、适用范围;或者用知识图谱、GraphRAG 之类的方式,把文档之间的项目、功能、系统、人员、时间关系建出来,避免 AI 只在一堆碎片里做相似度匹配。
但这些优化,更多是在把“检索资料”做得更准。它不一定能解决“复刻判断”。因为一个人的判断里,还有大量文档里没有写出来的隐性知识。也就是说,就是我不能只把文档交给 AI,还得想办法把当时没写出来的判断理由、责任边界、业务环境补出来。
所以这件事到最后,已经不只是一个个人数字分身的问题了。它其实指向了 AI 更大的方向:不是让机器替代人,而是把人脑里那些原本说不清、写不全、却真正决定判断的东西,一层层拆出来,再慢慢交给 AI 去学习。 这也是为什么我觉得,今天的低质 RAG 只是开始。它离真正的“我”还很远,但它已经把下一步该往哪走,露出来了。 未来的 AI,不一定会先学会怎么说得像人,但它大概率会先学会,像人一样理解知识、理解边界、理解环境,最后再去理解判断。
本文由人人都是产品经理作者【柠檬饼干净又卫生】,微信公众号:【柠檬饼干净又卫生】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自Unsplash,基于 CC0 协议。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。