


在大模型盛行的时代,能高效处理海量文档的 RAG(检索增强生成)方案正成为企业的刚需。但现实是:高延迟、高成本、低吞吐,拦住了大多数人。而 Google 最新发布的 Gemini 2.0 Flash,用一次性能的“降维打击”,让 PDF 转文本、并行摄取、快速问答不再遥不可及。
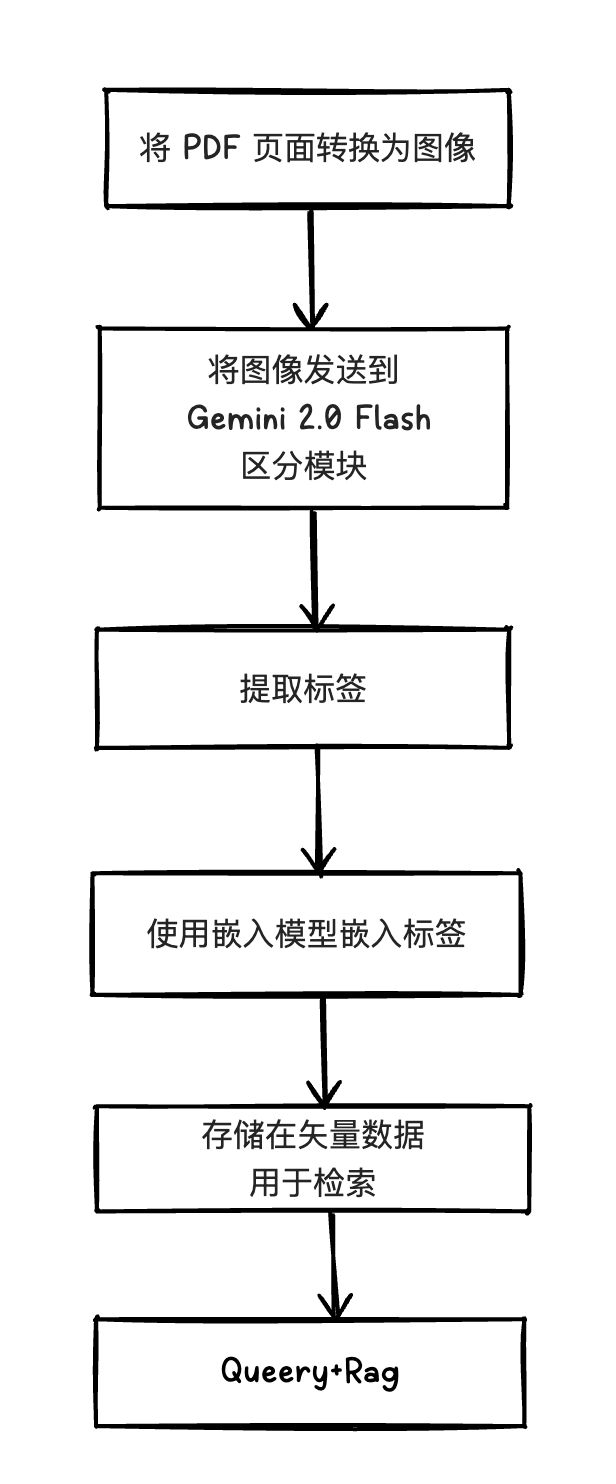
首先将每个 PDF 页面转换为图像,然后将它们发送以进行 OCR,只是为将原始文本转换为可用的 HTML 或 Markdown。接下来,您仔细检测并重新构建每个表,将内容切成块以进行语义检索,最后将它们全部插入到矢量数据库中,整个成本是非常高。
Google 的 Gemini 2.0 Flash 就可以简化整个过程。
在一个步骤中捆绑 OCR 和分块,而成本只是其中的一小部分。这篇文章恰恰探讨这种可能性。我将展示 Gemini 2.0 Flash 如何一次性将 PDF 转换为分块的、可用于 Markdown 的文本,让您摆脱冗余的多步骤。然后,我们将这些数据存储在可扩展矢量数据库,用于快速矢量搜索。
本指南介绍如何:
这是目前的模型价格
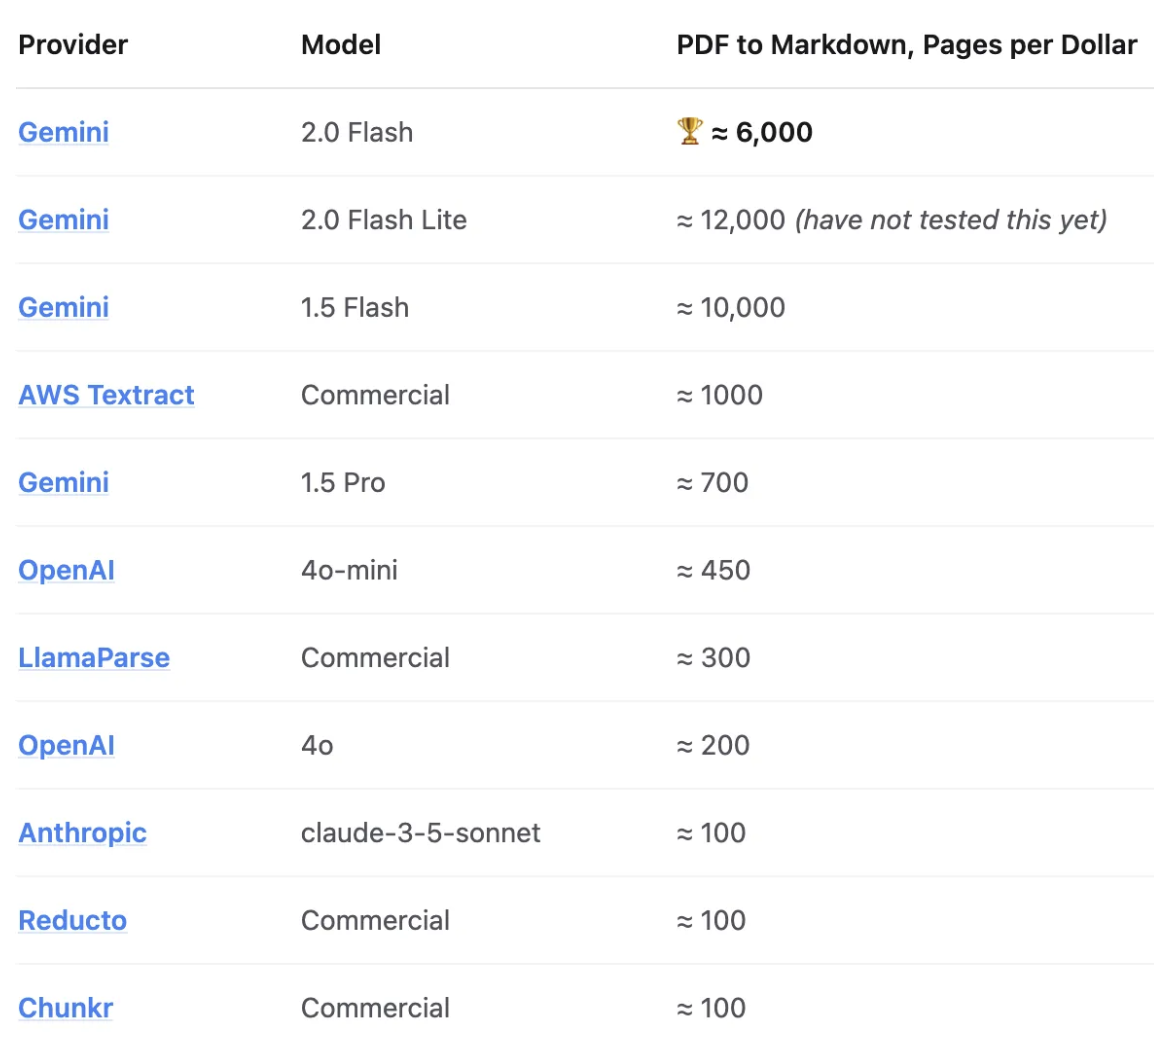
如果您不需要原始 PDF 中的边界框,这种方法比旧的 OCR 管道简单得多,成本也低得多。
为什么 PDF 摄取如此困难?
许多团队最终会得到一个脆弱且昂贵的巨大管道。新方法是:“只需将 PDF 页面作为图像显示给多模态 LLM,提示它分块,然后看着奇迹发生。”
这就是 Gemini 2.0 Flash 的用武之地。
成本 :~6,000 页/美元(使用批量调用和最少的输出令牌)。这很容易比许多其他解决方案(GPT-4、专门的 OCR 供应商等)便宜 5-30 倍。
准确性 :标准文本的保真度令人惊讶。大多数错误是微小的结构差异,尤其是对于表格。
最大的缺失部分是边界框数据。如果您需要将像素完美的叠加层重新覆盖到 PDF 上,Gemini 的边界框生成仍然远非准确。但是,如果您主要关心是基于文本的检索或摘要,那么它更便宜、更快、更容易。
1)安装依赖并创建基本表
!apt-get update
!apt-get install -y poppler-utils
!pip install -q google-generativeai kdbai-client sentence-transformers pdf2image
import os
import kdbai_client as kdbai
from sentence_transformers import SentenceTransformer
# start session with KDB.AI Server
session = kdbai.Session(endpoint=”http://localhost:8082″)
db = session.database(‘default’)
print(“Connected to KDB.AI:”, db)
您可以注册矢量数据库。免费 AI 服务器在这里: https://trykdb.kx.com/kdbai/signup/
2)创建 Vector Table
# Define KDB.AI table schema
VECTOR_DIM = 384 # we’ll use all-MiniLM-L6-v2 for embeddings
schema = [
{“name”: “id”, “type”: “str”},
{“name”: “text”, “type”: “str”},
{“name”: “vectors”, “type”: “float32s”}
]
# Build a simple L2 distance indexindex = [
{
“name”: “flat_index”,“type”: “flat”,
“column”: “vectors”,
“params”: {“dims”: VECTOR_DIM, “metric”: “L2”}
}
]table_name = “pdf_chunks”
try:
db.table(table_name).drop()
except kdbai.KDBAIException:
pass
table = db.create_table(table_name, schema=schema, indexes=index)
print(f”Table ‘{table_name}’ created.”)
3)将 PDF 页面转换为图像
# Convert PDF to images
import requests
from pdf2image import convert_from_bytes
import base64
import io
pdf_url = “https://arxiv.org/pdf/2404.08865″ # example PDF
resp = requests.get(pdf_url)
pdf_data = resp.content
pages = convert_from_bytes(pdf_data)
print(f”Converted {len(pages)} PDF pages to images.”)
# We’ll encode the images as base64 for easy sending to Gemini
images_b64 = {}
for i, page in enumerate(pages, start=1):
buffer = io.BytesIO()
page.save(buffer, format=”PNG”)
image_data = buffer.getvalue()
b64_str = base64.b64encode(image_data).decode(“utf-8”)
images_b64[i] = b64_str
4)调用 Gemini 2.0 Flash 进行 OCR + 分块
# Configure Gemini & define chunking prompt
import google.generativeai as genai
GOOGLE_API_KEY = “YOUR_GOOGLE_API_KEY”
genai.configure(api_key=GOOGLE_API_KEY)
model = genai.GenerativeModel(model_name=”gemini-2.0-flash”)
print(“Gemini model loaded:”, model)
CHUNKING_PROMPT = “””\
OCR the following page into Markdown. Tables should be formatted as HTML.
Do not surround your output with triple backticks.
Chunk the document into sections of roughly 250 – 1000 words.
Surround each chunk with <chunk> and </chunk> tags.
Preserve as much content as possible, including headings, tables, etc.
5)使用一个 prompt 处理每个页面
# OCR + chunking function
import re
def process_page(page_num, image_b64):
# We’ll create the message payload:
payload = [
{
“inline_data”: {“data”: image_b64, “mime_type”: “image/png”}},
{
“text”: CHUNKING_PROMPT}
]try:
resp = model.generate_content(payload)
text_out = resp.text
except Exception as e:
print(f”Error processing page {page_num}: {e}”)
return []
# parse <chunk> blocks
chunks = re.findall(r”<chunk>(.*?)</chunk>”, text_out, re.DOTALL)
if not chunks:
# fallback if model doesn’t produce chunk tags
chunks = text_out.split(“\n\n”)
results = []
for idx, chunk_txt in enumerate(chunks):
# store ID, chunk text
results.append({
“id”: f”page_{page_num}_chunk_{idx}”,
“text”: chunk_txt.strip()
})
return results
all_chunks = []
for i, b64_str in images_b64.items():
page_chunks = process_page(i, b64_str)
all_chunks.extend(page_chunks)
print(f”Total extracted chunks: {len(all_chunks)}”)
6)在矢量数据库中嵌入块和存储
# Embedding & Insertion
embed_model = SentenceTransformer(“all-MiniLM-L6-v2”)
chunk_texts = [ch[“text”] for ch in all_chunks]
embeddings = embed_model.encode(chunk_texts)
embeddings = embeddings.astype(“float32”)
import pandas as pd
row_list = []
for idx, ch_data in enumerate(all_chunks):
row_list.append({
“id”: ch_data[“id”],
“text”: ch_data[“text”],
“vectors”: embeddings[idx].tolist()
})
df = pd.DataFrame(row_list)
table.insert(df)
print(f”Inserted {len(df)} chunks into ‘{table_name}’.”)
7)查询和构建 RAG 流程
相似度搜索
# Vector query for RAG
user_query = “How does this paper handle multi-column text?”
qvec = embed_model.encode(user_query).astype(“float32”)
search_results = table.search(vectors={“flat_index”: [qvec]}, n=3)
retrieved_chunks = search_results[0][“text”].tolist()
context_for_llm = “\n\n”.join(retrieved_chunks)
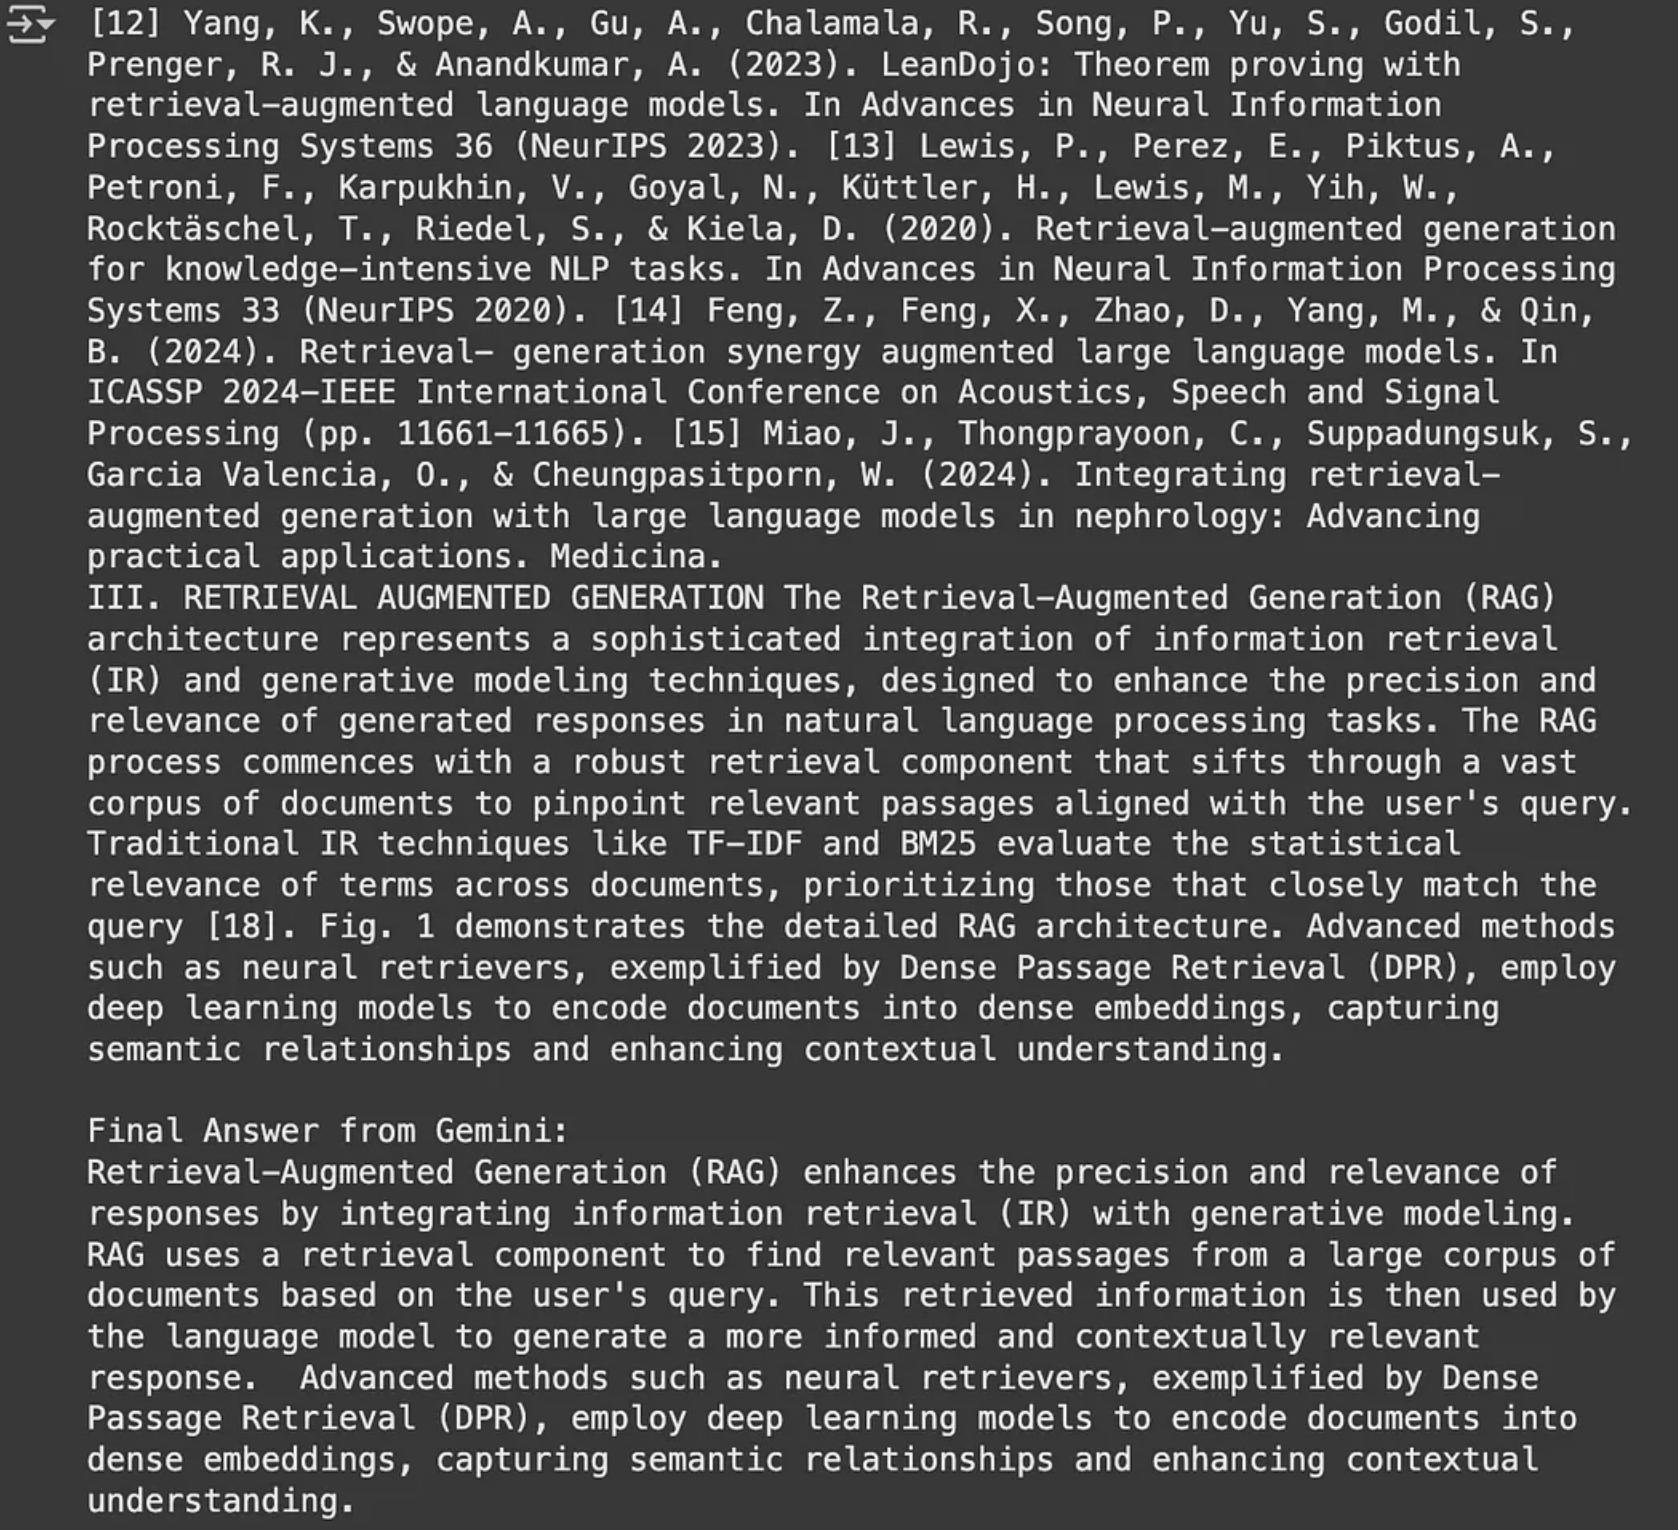
print(“Retrieved chunks:\n”, context_for_llm)
8)最终生成
# SNIPPET 8: RAG generation
final_prompt = f”””Use the following context to answer the question:
Context:
{context_for_llm}
Question: {user_query}
Answer:
“””
resp = model.generate_content(final_prompt)
print(“\n=== Gemini’s final answer ===”)
print(resp.text)
本文由 @来学习一下 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。