







从提示词工程到上下文工程,再到如今的Harness Engineering,AI工程领域正在经历一场深刻的范式转移。本文揭示了AI应用的核心痛点——不是模型不够强大,而是缺乏让Agent稳定运行的环境设计。通过拆解OpenAI等团队的实战案例,我们将看到如何通过上下文工程、架构约束和熵管理三大维度,构建真正可靠的AI协作系统,以及工程师角色从代码编写者向系统设计者的本质转变。
说实话,我最近有点被这个词刷屏了。
Harness Engineering,这个两个月前还没几个人提的概念,现在已经成了 AI 工程圈里最热的关键词。我自己也花了挺长时间才想清楚它到底在说什么——不是因为概念难,而是因为它触碰到了一个我一直隐约感觉到、但没有明确说出来的问题:
我们到底在哪个环节搞错了方向?
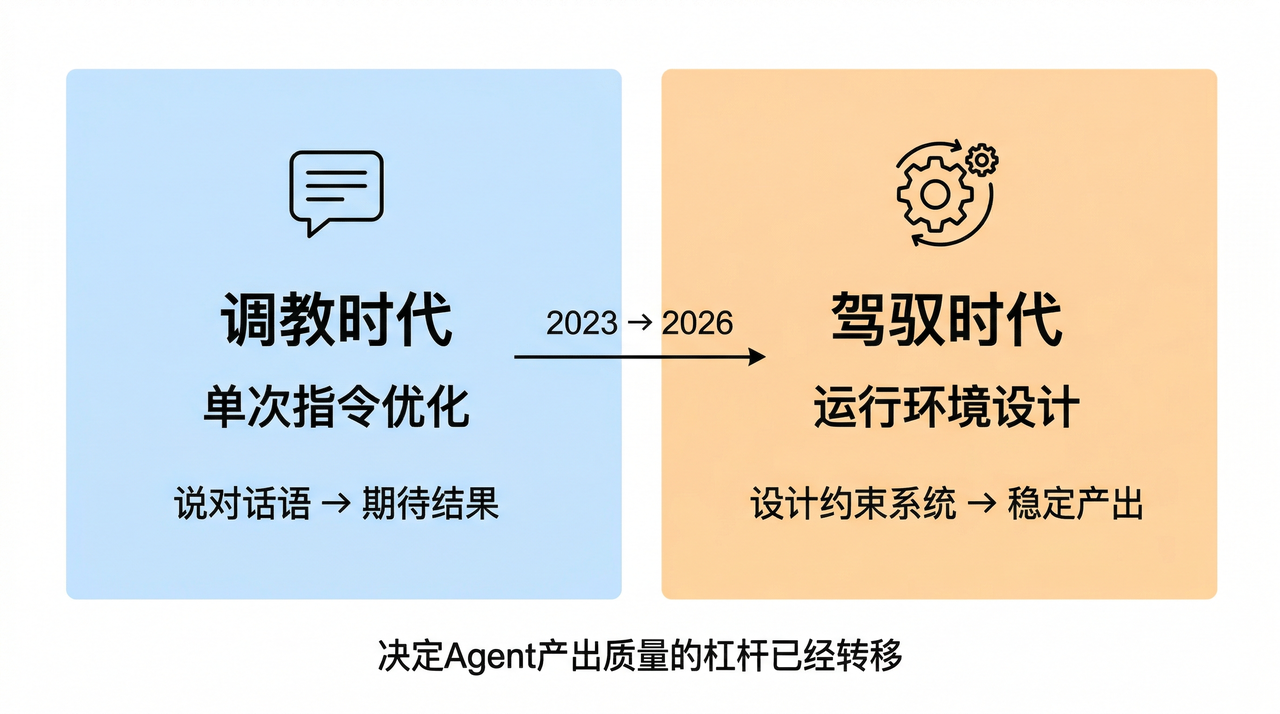
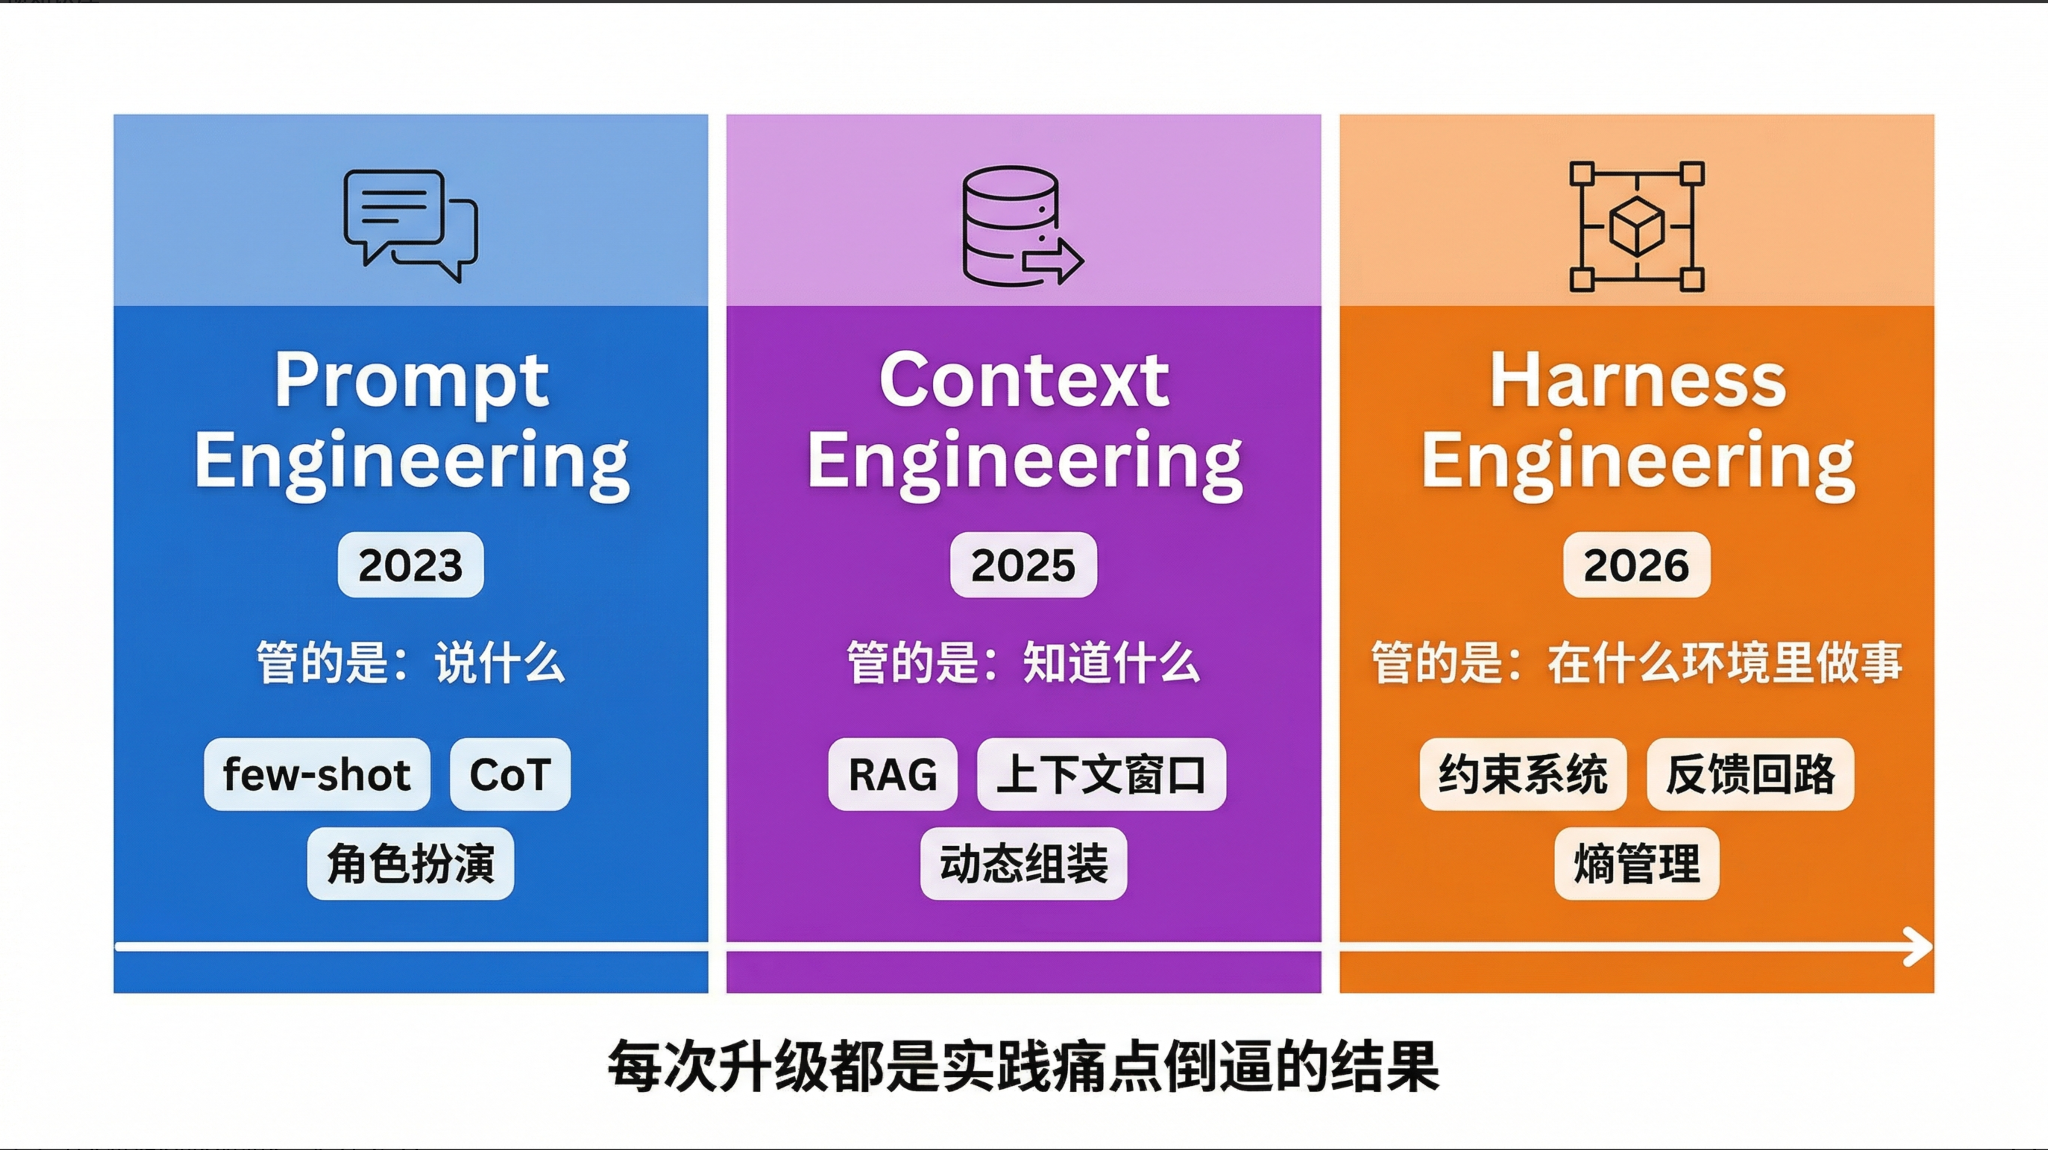
时间拨回 2023 年,那会儿整个 AI 圈都在研究一件事:怎么把提示词写好。
各种技巧满天飞,few-shot、思维链、角色扮演……我自己也没少折腾,专门建了一个文档收集各种”神级 prompt”,觉得找到了某种秘诀。那时候的感觉就像是,只要咒语念对了,AI 就会乖乖交付你想要的东西。
但慢慢地,问题开始出现。
同样一条提示词,昨天用没问题,今天换个任务就崩了。同样的指令,给不同的 Agent 用,结果差异大得离谱。更要命的是,当任务变得复杂,需要 Agent 连续做十几个步骤的时候,提示词写得再精妙也救不了它在中途跑偏。
Simon Willison 说过一句很扎心的话,大意是:大多数人听到”提示词工程”,脑子里浮现的就是对着聊天框打字。这个词的含义已经被稀释成那样了。
我当时看到这句话,有点沉默。因为我自己就是那个”对着聊天框打字”的人。
2025 年前后,风向变了,开始流行一个新词:Context Engineering。
核心逻辑是,光写好指令不够,你还得让模型”知道它需要知道的东西”。于是工程师们开始搞向量数据库、RAG 检索、上下文窗口管理,把各种信息塞进去,期待模型能做出更好的判断。
这个方向确实有用,我自己用过之后效果提升很明显。但问题也很快暴露出来——
有人记录过一个真实事故:一个没人盯着的 Agent 陷入了无限循环,等到有人发现的时候,API 账单已经跑了五万美元。
上下文再好,也管不住一个失控的 Agent。
你可以告诉它”知道什么”,但你没办法阻止它”做不该做的事”。
2026 年 2 月,一份来自 OpenAI 内部的技术报告让很多人开始重新思考这件事。
报告描述了一个挺极端的实验:一个最多七人的小团队,五个月时间,零行手写代码,通过 Agent 协作交付了超过一百万行代码的生产级软件。每名工程师平均每天合并 3.5 个 PR。
这个数字本身不是重点,重点是报告里的一句话,被反复引用:
“我们目前最困难的挑战,集中在设计环境、反馈回路和控制系统上。”
不是模型不够聪明,不是提示词不够精妙,不是上下文不够丰富——是环境。
几乎同时,HashiCorp 的联合创始人 Mitchell Hashimoto 在博客里给这件事起了个名字,叫 Harness Engineering,并给出了一个很简洁的定义:每当你发现 Agent 犯了一个错误,你就花时间设计一个解决方案,使它永远不再犯同样的错误。
这个定义我看了好几遍。越想越觉得,这才是对的问题意识。
理解 Harness Engineering 有一个很好的切入角度,就是把视野拉远一点。
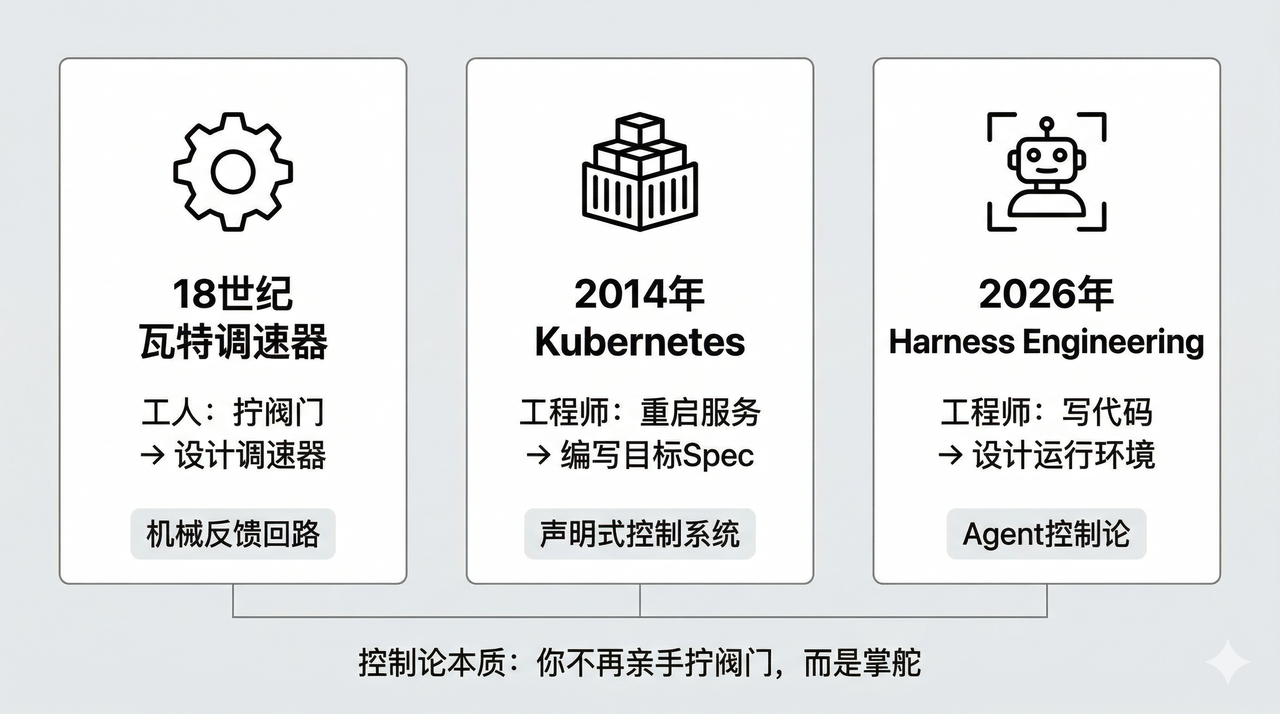
十八世纪八十年代,瓦特改良蒸汽机的时候,顺带发明了一个叫离心调速器的装置。在它出现之前,必须有工人站在机器旁边,用手不停地调节阀门。有了调速器之后,一套带飞球的机械结构会自动感知转速、自动调节。工人的工作没有消失,只是变了——从亲手拧阀门,变成设计调速器本身。
后来 Kubernetes 出现,工程师不再需要手动重启服务,只需要声明目标状态,控制器会持续监测并自动修正偏差。角色又变了一次——从执行者变成规格说明的制定者。
现在是第三次。
1948 年,数学家诺伯特·维纳给这个反复出现的模式起了一个名字:控制论,来自希腊语里”舵手”的意思。你不再亲手拧阀门,而是掌舵。
Harness Engineering 本质上就是这个——把工程师从”亲手操作”的位置,迁移到”设计让系统自动运转的机制”的位置。
有一组数据我觉得很有说服力。
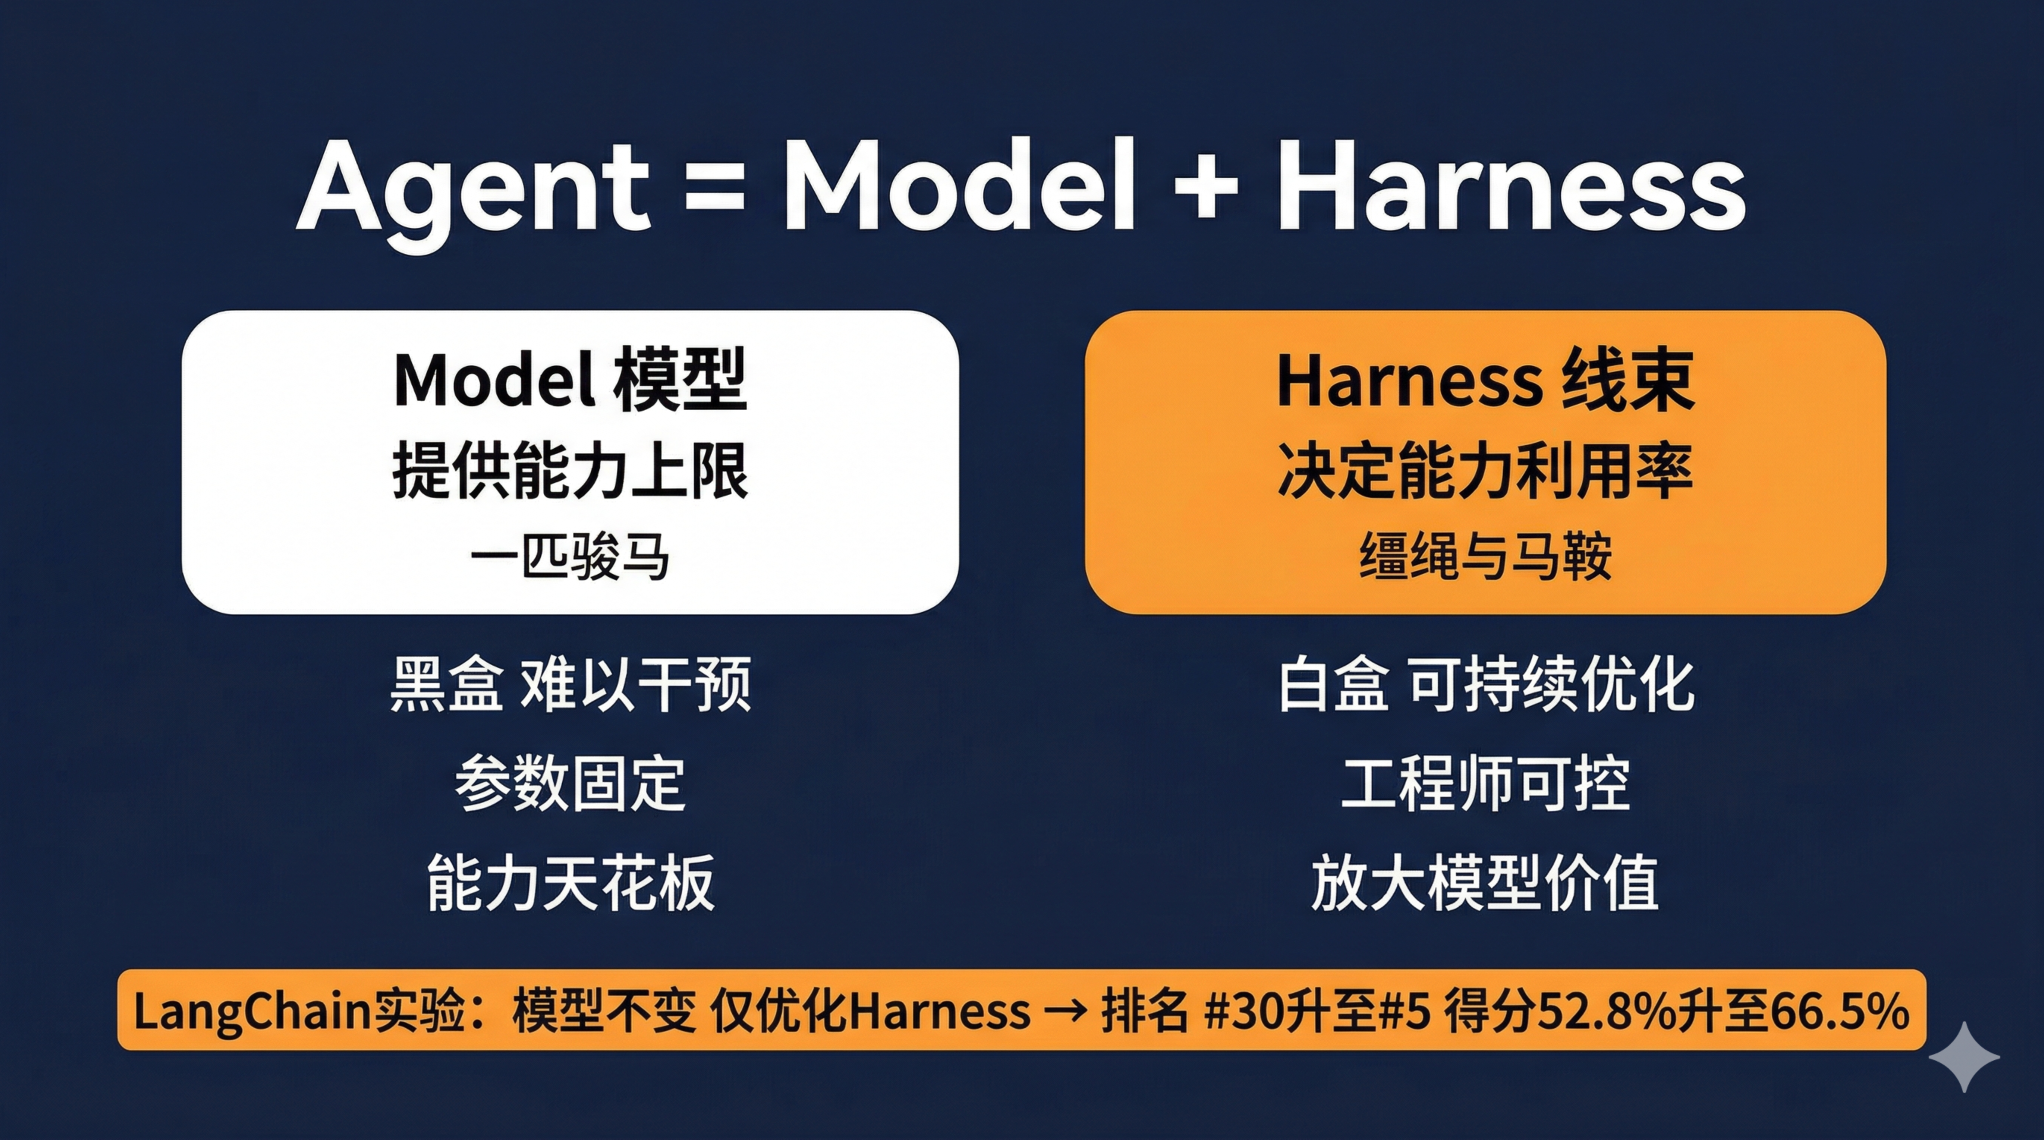
LangChain 的编码 Agent 在一个叫 Terminal Bench 2.0 的基准测试上,做了一件很干净的实验:底层模型一个参数都没动,只优化了 Agent 运行的外部环境——文档结构、验证回路、追踪系统。结果排名从全球第 30 位跃升至第 5 位,得分从 52.8% 飙到 66.5%。
模型没变,Harness 变了,结果完全不同。
这让我想到一个比喻,是 LangChain 的工程师提出来的:Agent = Model + Harness。如果模型是一匹马,Harness 就是缰绳。马再强壮,没有缰绳也跑不了你想要的方向;有了合适的缰绳,普通的马也能稳定完成任务。
试图扛着马跑,才是真正的问题所在。
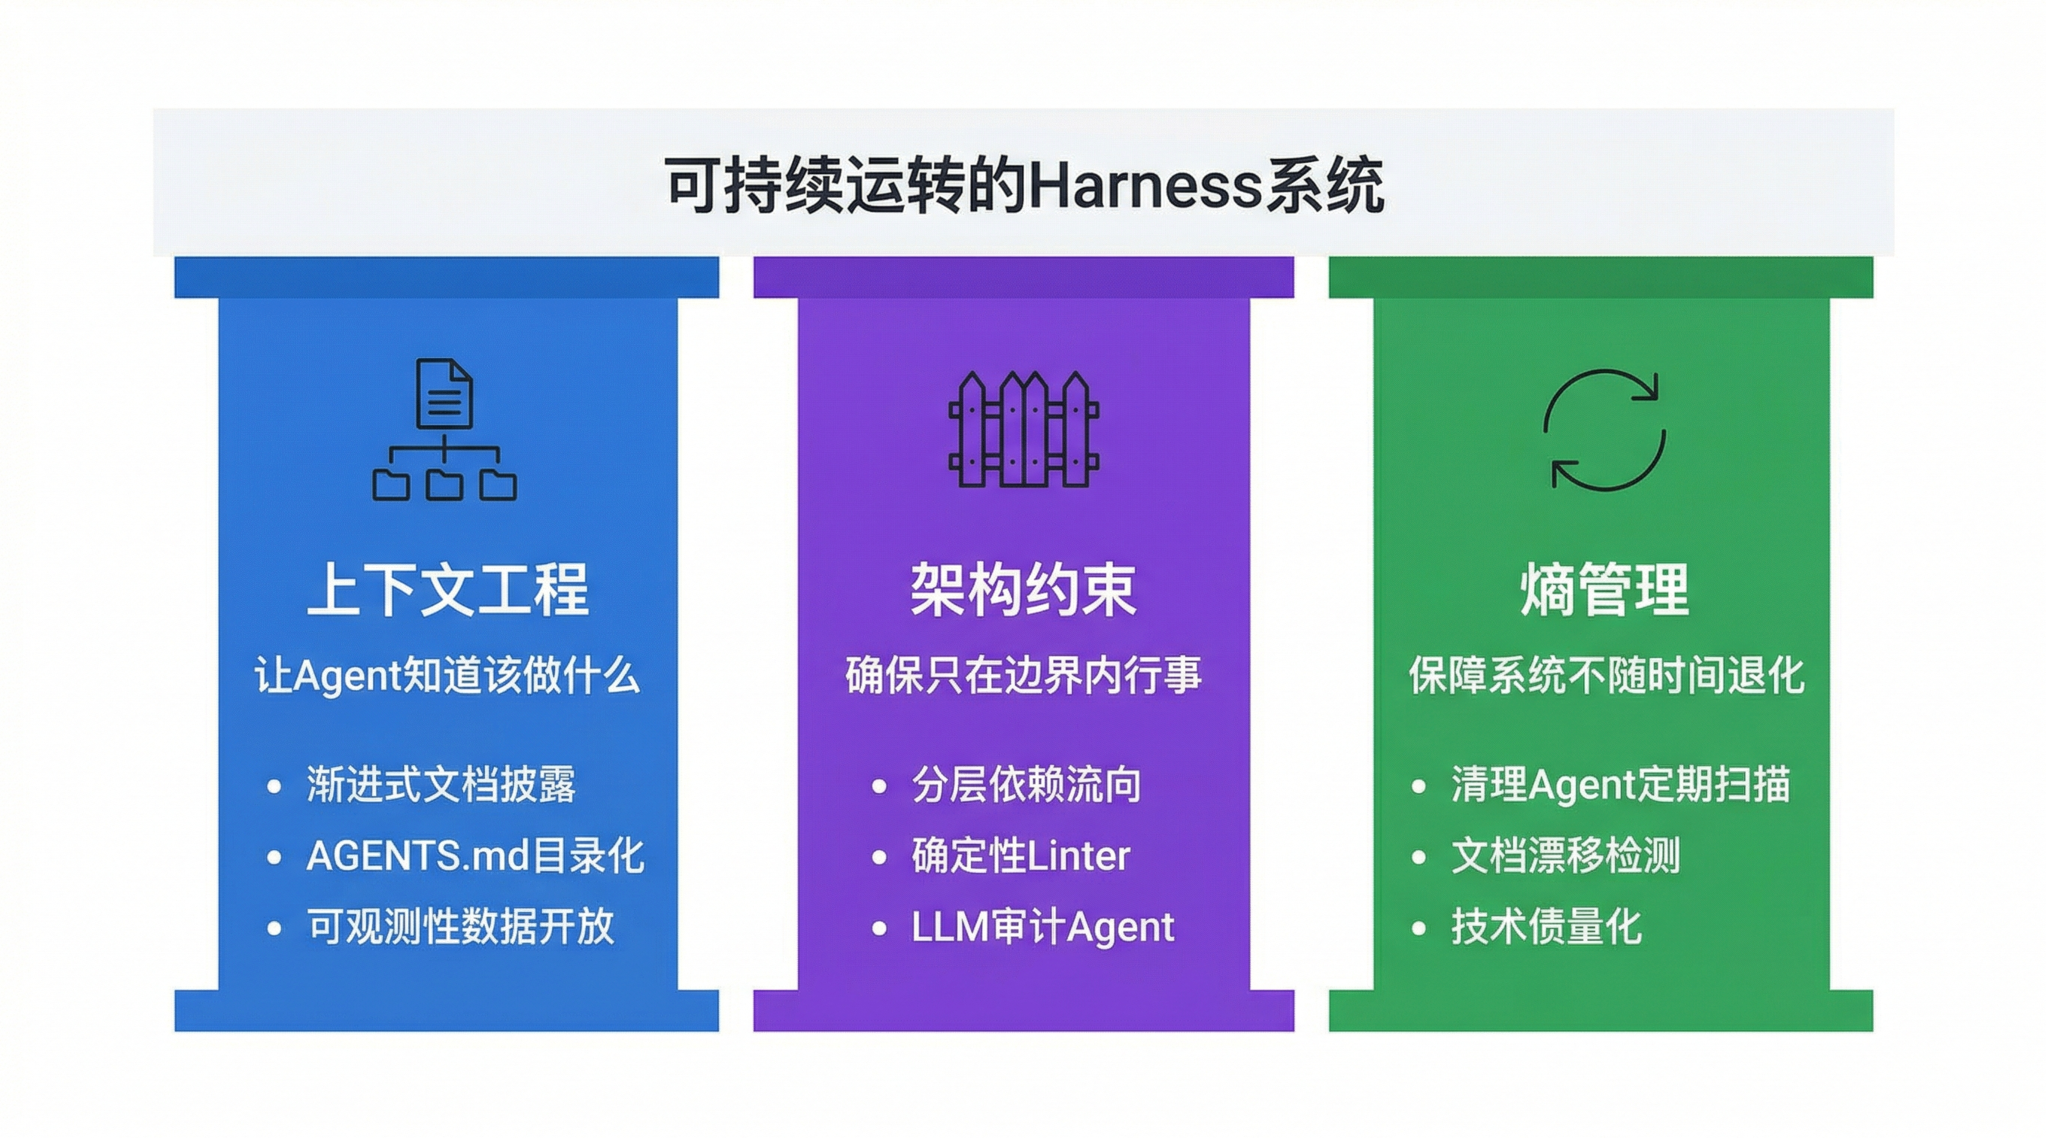
Thoughtworks 的工程师 Birgitta Böckeler 做了一个很清晰的拆解,把 Harness 分成三个维度,我觉得很好用。
第一个维度是上下文工程。
这里有一个 OpenAI 团队踩过的坑值得说一下。他们早期把所有内容——系统说明、架构规范、代码风格、边界条件——全部堆进一个 AGENTS.md 文件。结果 Agent 被信息淹没,性能反而下降了。
后来他们演化出一个”渐进式披露”的方案:AGENTS.md 只做目录,真实内容放在结构化的 docs/ 目录里,Agent 按需逐层读取。逻辑其实很简单,就像新员工入职,没人第一天就要读完公司所有文档。
更进一步,他们还把可观测性数据直接暴露给 Agent——日志、指标、追踪信息全部开放,Agent 可以查询运行时数据,甚至能操作浏览器来重现 Bug、验证修复。Agent 从此不只是”写代码的工具”,它开始能看见代码跑起来之后发生了什么。
第二个维度是架构约束。
这里有一个细节我觉得特别能说明问题:OpenAI 的工程师花了好几个小时,专门重写 Linter 的错误输出格式。不是为了让人看懂,而是为了让 Agent 能读懂——读懂之后自动修复。
Linter 输出的受众,从人类变成了 AI。
这件事本身就是一种思维方式的转变。约束不是用来限制的,是用来让正确的事情更容易发生的。当约束被机械化执行,Agent 会自然地在边界内工作,而不是不断试探边界。
Stripe 的做法也很有意思,他们把工作流拆成两类节点:可预测的步骤交给确定性代码,需要判断和创造力的环节才调用 LLM。把 LLM 关在”可控盒子”里,而不是让它到处乱跑。
第三个维度是熵管理。
这个维度最容易被忽视,但我觉得最关键。
Harness 本身也是代码和文档,它同样会腐化。规则会过时,例外会累积,系统会慢慢退化。如果 Harness 自身腐化了,Agent 读到混乱的指令,输出的就是混乱的代码。
OpenAI 的解法是部署专用的清理 Agent,定期扫描文档漂移和模式违规。把技术债治理从”季度任务”变成”日常垃圾回收”。
三个维度加在一起,Böckeler 的总结是:上下文工程让 Agent 知道该做什么,架构约束确保只在边界内行事,熵管理保障整个系统不随时间退化。缺少任何一环,Harness 都会在某个时间点失效。
我在这个行业待了好几年,见过很多次”工程师的工作要变了”的讨论,大多数都是虚惊一场。但这次感觉不太一样。
OpenAI 实验里的工程师,日常工作已经变成了三件事:
维护文档和上下文体系,让 Agent 始终知道项目的边界在哪;把业务目标和质量标准表达成机器可以理解的形式,用 Schema 定义数据结构,用测试用例定义预期行为;构建自动化的验证机制,让质量问题在生成阶段就被拦截,而不是堆到人工审查环节。
有人描述过一个很生动的工作场景:某个做工具的创始人在用 Agent 的时候,只讨论架构和重大决策,完全不碰具体代码实现。他是那种”在脑子里保存着整个项目高层结构”的人,Agent 是他的执行系统。
这让我想了很久。系统理解的深度,比写代码的速度重要得多——这句话放在三年前说,可能是废话;但现在,它越来越像一个真实的能力要求。
组织层面的变化也很明显。小团队完成大体量的工程输出,已经不是新鲜事了。但有一个问题我觉得值得认真对待,就是”学徒缺口”——如果初级开发者一入行就跳进 Agent 驱动的循环,跳过了手动开发的阶段,他们将来能不能建出真正健壮的 Harness?
这个问题没有简单的答案,但至少值得每个技术管理者想一想。
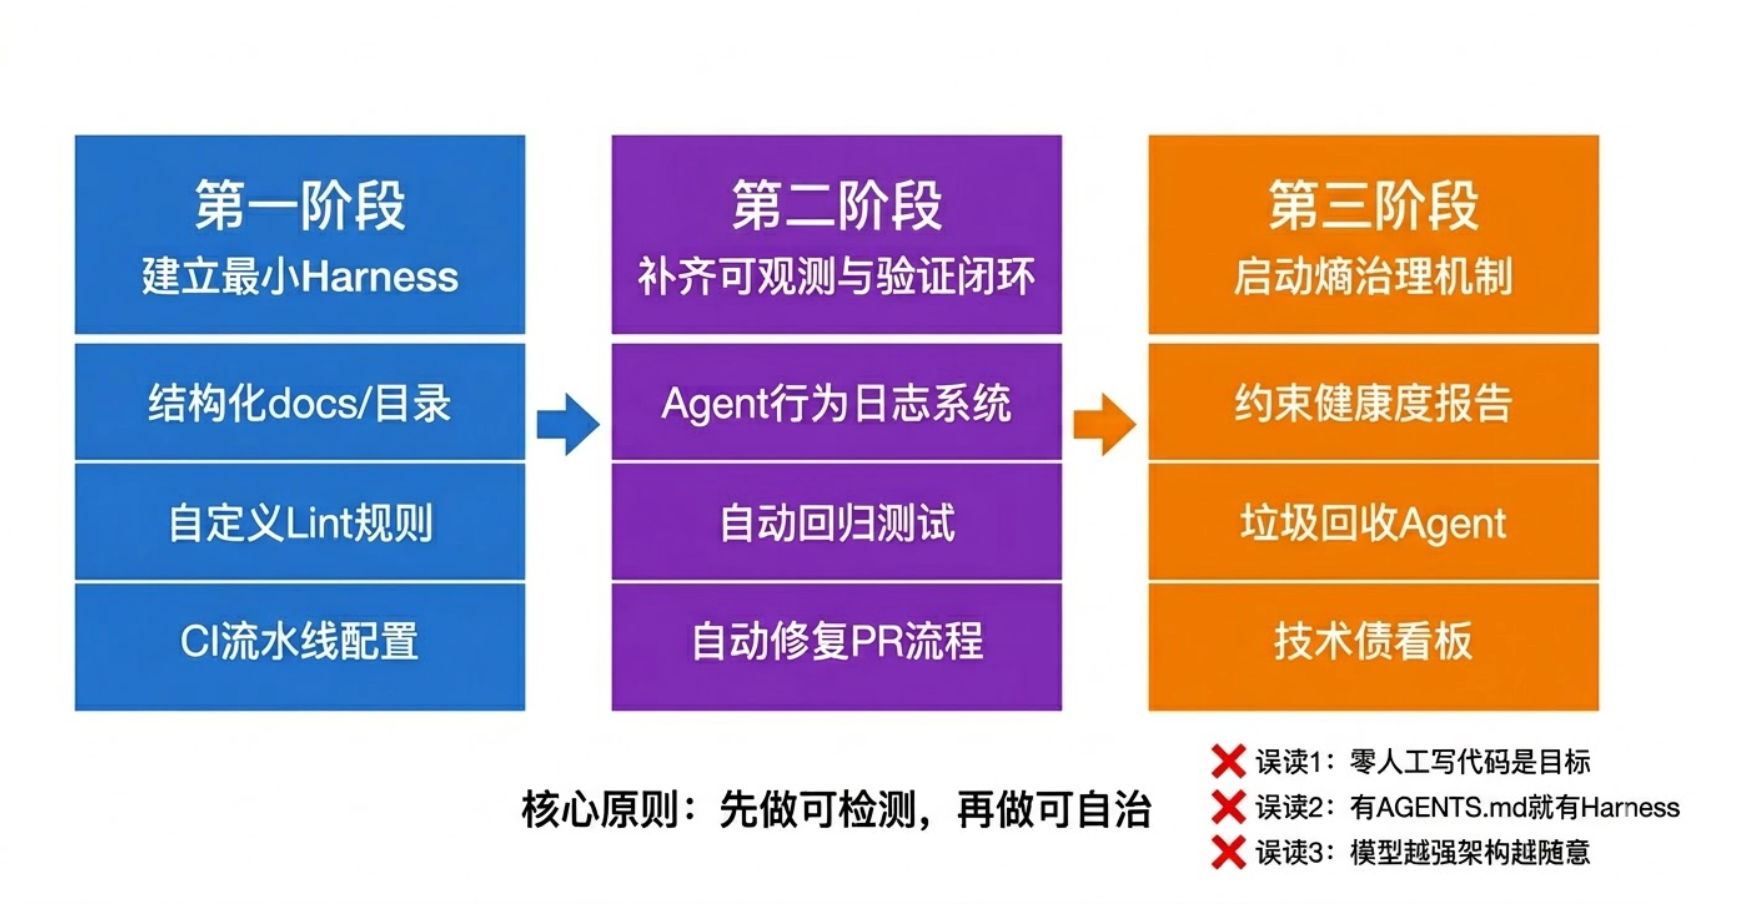
说了这么多理论,落地才是真的。
第一步,目标只有一个:让 Harness 能跑起来,哪怕很粗糙。把 AGENTS.md 改成目录入口,真实内容放进结构化的 docs/;加几条高价值的自定义 Lint 规则;配好 CI,让代码提交时自动跑测试。
有一个建议我觉得很实用:把同一个任务做两遍,先自己手动完成,再让 Agent 做一遍。不是为了比较结果,是为了建立对 Agent 能力边界的直觉。你得先知道它会在哪里出错,才能知道要在哪里加约束。
第2步,重点是让系统能”看见”Agent 在做什么,并判断做得对不对。建日志系统,把关键用户旅程变成可执行的验收场景,引入自动修复 PR 的流程。
第3步,开始处理 Harness 自身的腐化问题。定期跑垃圾回收任务,建质量评分看板,把高频的 review 反馈固化成工具规则。
有三个误区需要提前说清楚。
“零人工写代码”不是目标,那是一个极端实验的副产品,真正的目的是逼团队补齐 Harness 缺口。
“有 AGENTS.md 就有 Harness”,这个想法会害了你。单文档规则会迅速失效,必须结构化、可校验、可回收。
还有一个短板现在大多数团队都没补上:功能正确性验证。能通过所有 Linter 和架构测试的代码,不等于做了用户真正需要的事情。LangChain 的行业数据显示,89% 的团队已经有可观测性,但只有 52% 建了评估体系。这个差距,是接下来一年最值得填的坑。
那些当年设计了瓦特调速器的工人,后来没有回去拧阀门。不是因为他们不会拧,而是因为那件事已经没有意义了。
从提示词工程到上下文工程再到 Harness Engineering,三年时间,这个行业对”怎么让 AI 可靠工作”这个问题的理解,已经走过了三代。每一代的答案都没有错,只是不够完整。
现在我们知道了,光说对话语不够,光给对信息也不够,还需要设计一个让 Agent 能在其中稳定运转的环境。
这件事大多数团队还没开始做,但方向已经很清楚了。
人类最核心的竞争力,从来都不是去扛着马跑,而是通过构建高效的协作系统,让那些强大的智能精准落地
本文由 @图灵共振 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。