







推理模型不仅能够模仿人类思维,还能跨越知识领域,将信息整合并生成新的知识,这正是AGI实现通用性的基础。
笛卡尔说:“我思,故我在。”
思考是文明存在的根本,是人类探索未知的永恒追求,现在也成了大模型技术演进的一个重要方向。
自OpenAI在9月中旬悄然发布o1模型后,一系列推理模型陆续开放测试。比如通义千问的QwQ、deepseek的R1、Kimi的K1以及智谱刚刚发布的GLM-Zero的初代版本GLM-Zero-Preview(智谱清言同步上线了智能体“Zero推理模型”)。
正好到了年末,我们萌生了举办一场推理模型“年终考试”的想法。
在“考试”正式开始前,先来简单科普下推理模型的特点:相较于基座模型,推理模型在回答问题前会像人类一样进行更长时间的“思考”,不断验证和纠错,更擅长编程、数学、科学等任务。
所以,这是一场面向“理科生”的考试。
需要说明的是,我们没有使用AIME2024、MATH500等专业的数据集,也无意对各个推理模型进行专业测评和排名,仅适用于多数人在日常生活中可能遇到的问题。
譬如给孩子辅导作业、应付面试时的“奇葩问题”、和朋友一起玩剧本杀时的推理游戏等等,和大家一起探索各个推理模型的“长项”和“短板”。
一共有六道考题,分别用高三数学的单选题、多选题和计算题测试模型的数学计算能力,用一道常见的编程题目测试模型的编程能力,用一道逻辑问题和一道海龟汤问题测试模型的推理能力。
分数评定分为三个维度,最终根据推理结果(占比60%)、推理过程(占比25%)、推理时间(占比15%)加权平均。考虑到单次测试存在的不确定性,满分为100分,兜底分数为60分(即使做错了也有60分)。
考生名单:OpenAI o1、通义千问QwQ-32B-preview、deepseek深度思考(R1)、Kimi视觉思考版(K1)和智谱GLM-Zero。
下面,考试正式开始。
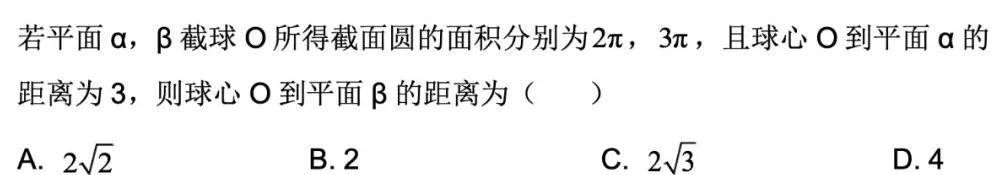
考虑到不少人曾经拿高考真题测试,为了防止可能的“作弊”行为,我们从《2024届浙江省镇海中学高三下学期期中数学试题》筛选了一道单选题目进行测试。(难度的话,至少本科毕业十年的我们是不会做的。)
鉴于测试的过程比较无趣,我们把5个模型的测试录屏放在了视频中,感兴趣的小伙伴可以点击观看,也可以直接查看最终的“考试”结果。
第一题成绩揭晓
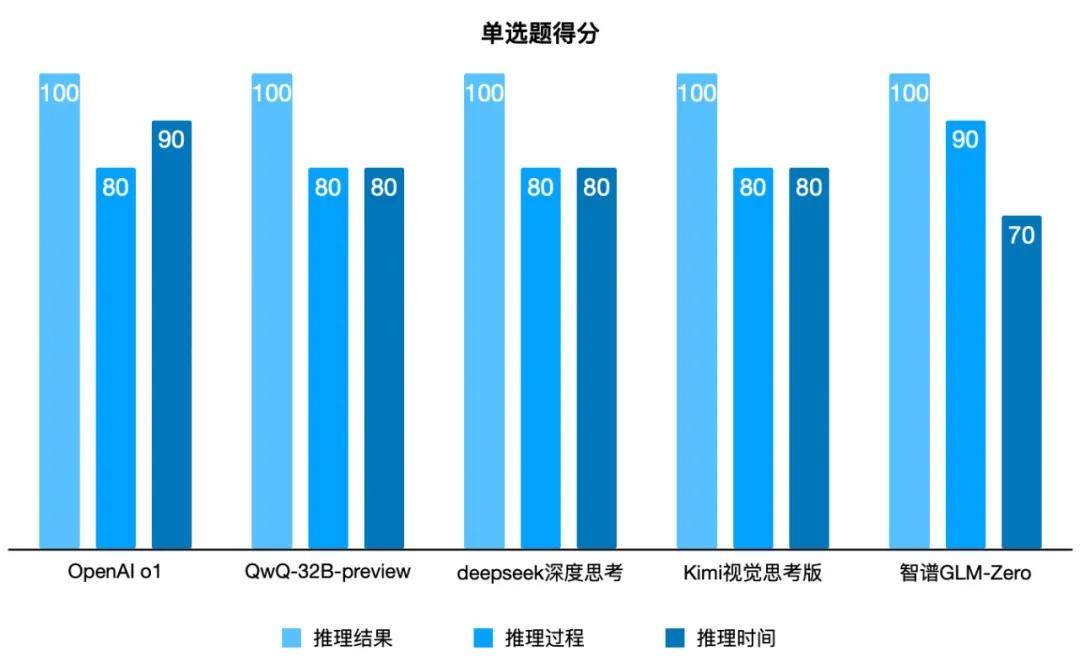
五个推理模型均给出了正确答案。
其中o1模型的推理速度是最快的,推理过程简单高效,直接给出了计算过程和结果;可能是刚上线的缘故,GLM-Zero的推理速度相对慢一些,但推理过程是最符合人类思维的(在思维链中可以清晰地看到自我反思和优化、将复杂问题分解,并尝试用不同方法解决问题),可以作为解题的参考答案。另外三个模型的推理速度比o1稍慢,但在结果和推理过程上可以和o1媲美。
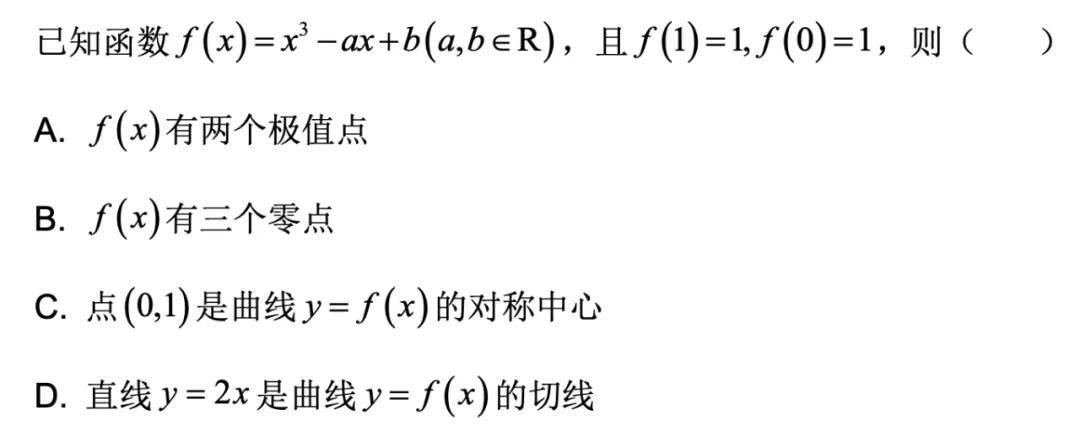
题目来源和单选题一样,难度有所增加,更考验模型处理复杂问题的能力,以及思考的方式和过程。(PS:我们在考前进行过类似题目的测试,部分模型每次都只给一个答案,所以在正式考试时特意给了多选题的提示。)
第二题成绩揭晓
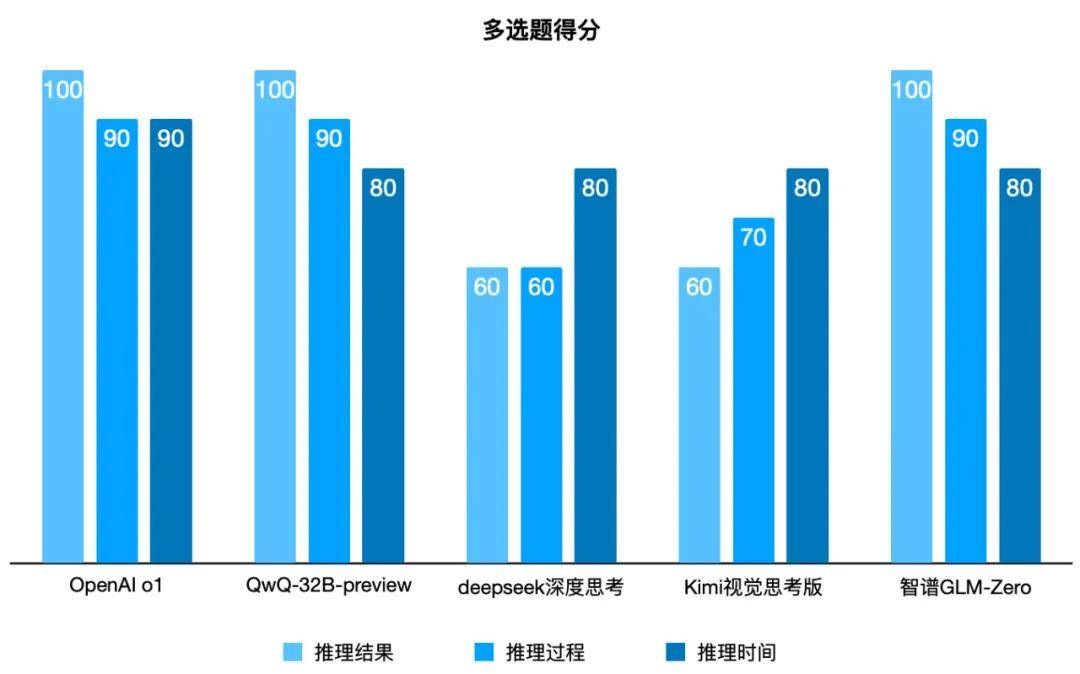
五个推理模型中,只有三个模型给出了正确答案。
o1、GLM-Zero和QwQ回答正确,Kimi视觉思考版只给出了一个正确选项,deepseek深度思考的回答是“没有正确答案”(排除了图像识别问题)。在三个回答正确的模型中,GLM-Zero和QwQ表现出了不俗的归纳与演绎能力,提供了详细的解题过程,并通过反思进行多次验证,而且GLM-Zero的推理速度比上一题提升了不少。o1没有显示思考过程,直接给出了答案。
如果一个城市中 95%的人打了疫苗,而疫苗保护率是 90%,病毒传播率是5%,未接种者感染率是 50%,计算城市中总感染率。
这是一道AI拟定的题目,因为表述有点“模糊不清”,但又不乏逻辑自洽,审题不仔细的话,很可能给出错误答案。(毕竟我们当年就在高考试卷上吃过“马虎”亏,也要让AI尝尝什么叫审题要认真!!!!)
第三题成绩揭晓
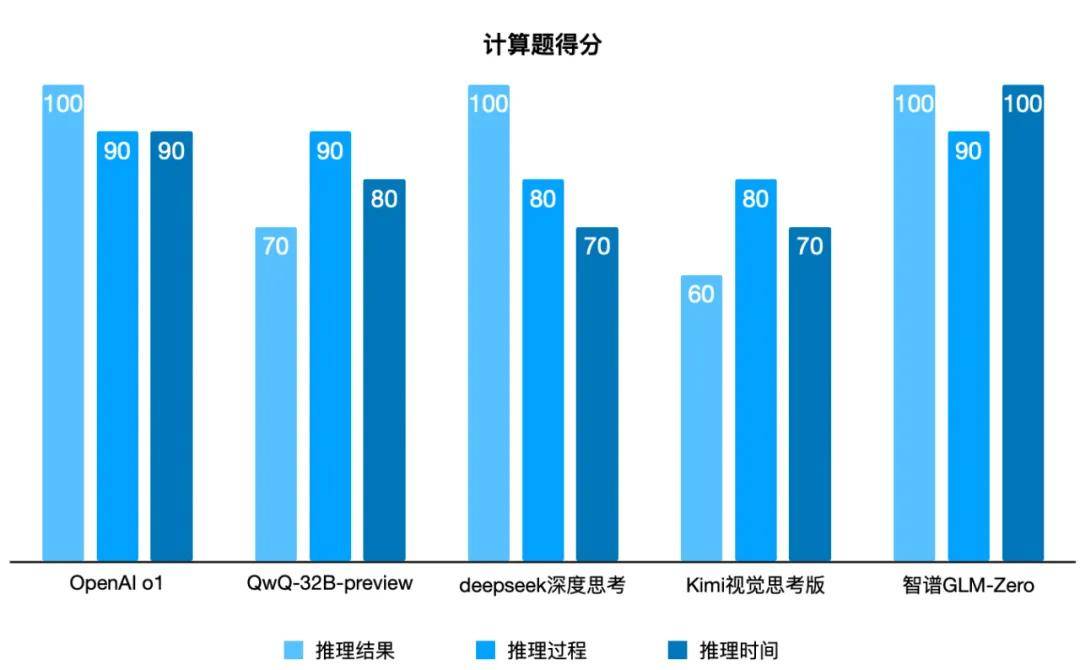
和预料的一样,有两个模型“翻了车”。
这道题不仅仅计算,还考验模型的思考过程,能否识别中题目中的逻辑漏洞,找到最合理的假设。GLM-Zero在速度上“逆袭”了,整体表现比o1的表现还要优秀。deepseek深度思考的推理过程看起来最完善,考虑到了多种可能,最终给到的是最合理的答案。Kimi和QwQ也考虑了多种可能,但在逻辑漏洞的理解上出现了偏差,最终沿着错误的方向进行计算,导致计算结果错误。
写一个程序,将一个字符串中的所有单词翻转(例如输入:“Hello World”,输出:“World Hello”)。
由于我们不是程序员,对代码的认知停留在了大一的C语言入门阶段,所以选择的编程题目比较基础,主要考验代码的合理性和可用性。(如果你是程序员的话,希望进行更深度的测试,并将结果同步给我们。)
第四题成绩揭晓
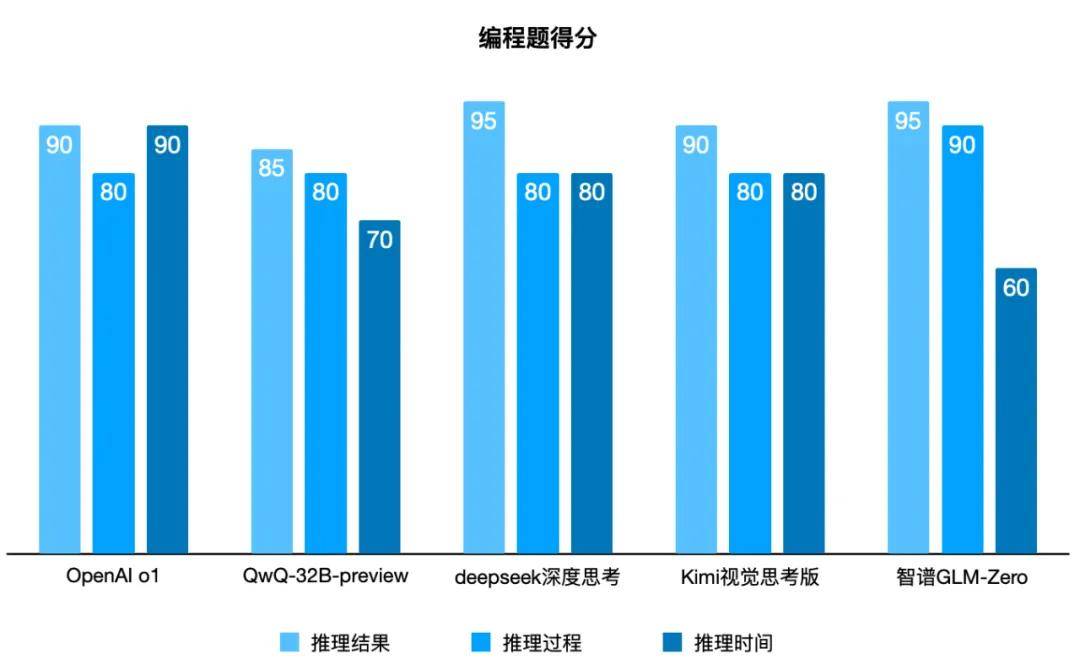
五个推理模型都达到了及格分。
其中GLM-Zero和Kimi的代码解释最为详细,虽然程序很简单,依然进行了逐行解释,对新手程序员非常友好。o1模型照旧简单高效,deepseek给出了两种不同的实现方式,且均测试有效。就推理速度来看,GLM-Zero考虑到了更复杂的测试情形,反复推理验证,导致耗时比其他模型长了不少。
一个房间里有三个开关,分别对应三个灯泡,你只能进入房间一次,如何确定哪个开关对应哪个灯泡?
据传是微软的面试题,主要考验面试者的逻辑思维和判断能力,推理模型能否通过微软的面试呢?(本来打算用“牛过桥”的问题,据说是华为的面试题,考虑到逻辑性和答案的一致性,最终还是选择了灯泡问题。)
第五题成绩揭晓
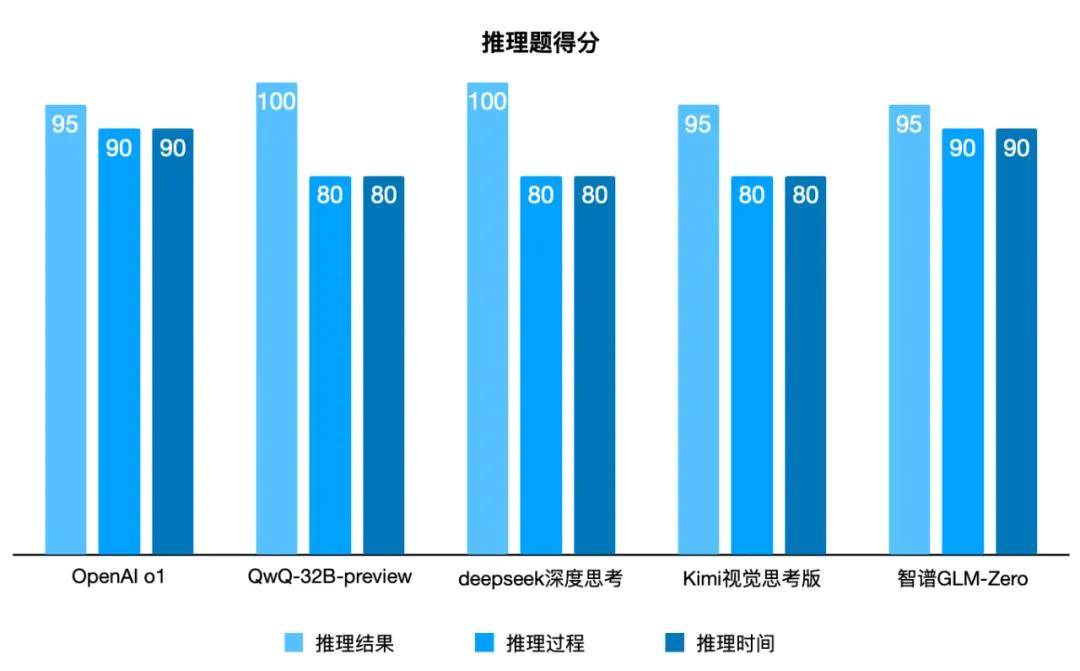
也许是问题过于“经典”,五个模型均顺利过关。
其实也意味着,五个模型在推理上都有着不错的能力。就细节上来看,Kimi“不小心”出现了格式混乱,GLM-Zero和o1都在极短时间里给出了合理的推理过程和正确答案。之所以在得分上有差距,原因是deepseek和QwQ都特意补充“确保灯泡是白炽灯”,弥补了题目本身的缺陷,在逻辑上更加合理。
一名男子在弹钢琴时,突然一根弦断了,他立即停止弹奏并开始哭泣。这是为什么?
海龟汤问题的答案通常是开放的,涉及不同领域的知识,模型需要对语言细节进行精确理解,并在回答中清晰地表达推理过程。同时需要从表面信息推导出隐藏的逻辑,要求模型能够分析隐含的信息并进行深度推理。
第六题成绩揭晓
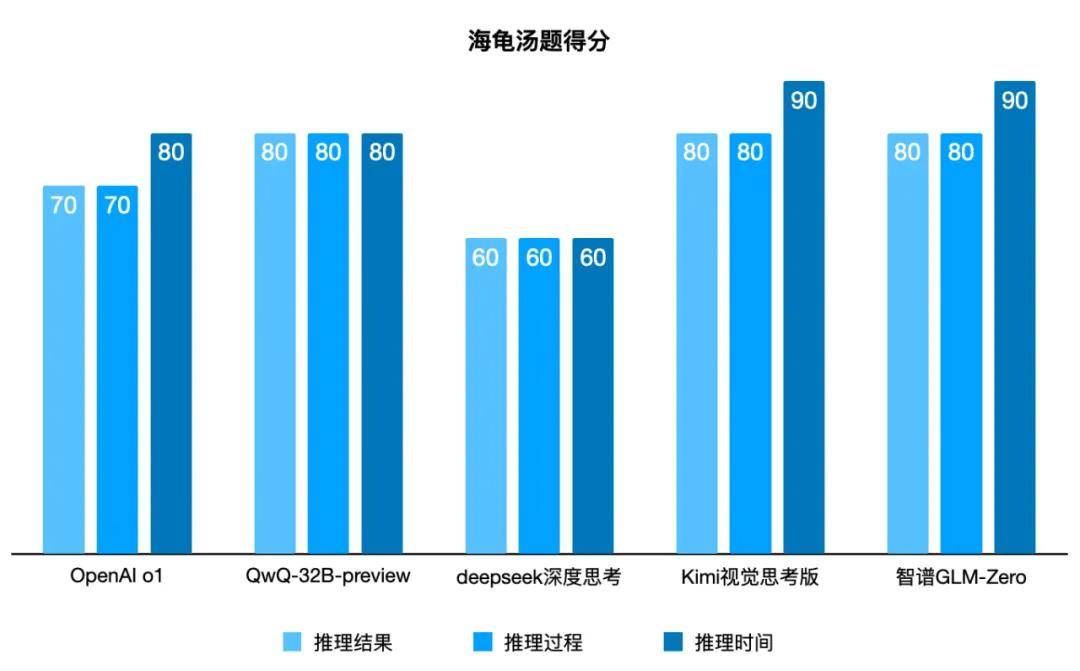
海龟汤题没有标准答案,主要考的是推理结果的合理性。
o1模型终于“翻车”了,将问题理解为了“脑筋急转弯”,而且推理几乎没有逻辑;deepseek陷入了思考死循环,等待了4分多钟后,我们被迫停止了测试;kimi、GLM-Zero和QwQ的表现不相上下,只是Kimi再次出现了格式混乱。遗憾的是,作为“理科生”的推理模型,都没有进行富有创造性的故事描述。
考试小结
我们按照文初提到的考试规则,进行了平均分的计算,考虑到单次测试的偶发性(比如将多选题拆解为单选题,进一步测试两个“翻车”的模型,最终都给出了正确答案),可以说各个推理模型并未拉开太大的差距,并没有陷入同质化,而是各有所长。

o1模型胜在推理速度和推理正确率;QwQ-32B-preview的表现中规中矩;deepseek深度思考在数学计算和编程方面表现优秀;Kimi视觉思考版“自我反思”能力强,在发散问题上的逻辑自洽性最佳;GLM-Zero在数学计算、编程和推理上的综合表现不输o1,可以说是目前国内最好的推理模型。
不过,Open AI已经发布了o3模型,整体性能比o1提升了20%,国内的几个推理模型仍然有很大的提升空间。其中智谱已经公开表态将持续优化迭代强化学习技术,并将推出正式版的GLM-Zero,将深度思考的能力从数理逻辑扩展到更多更通用的技术。
正如OpenAI的介绍o1模型的博客文章里所提到的:“我们通往AGI的路上,已经没有任何阻碍。”
推理模型不仅能够模仿人类思维,还能跨越知识领域,将信息整合并生成新的知识,这正是AGI实现通用性的基础。
相较于我们的“单题测试“,推理模型在产业中落地的可能更大。比如在金融、医疗、法律等决策过程常涉及多变量权衡的领域,推理模型可以分析大量数据、找出相关性,并提供优化的解决方案。
以医疗场景为例,基于推理的诊断模型可以帮助医生快速排查可能病因并建议治疗方案,从而提高诊断效率;再比如智谱在AutoGLM上示范的人机协作场景,推理模型能够更好地理解人类的意图、预测需求、并主动提出建议,将进一步提升Agent的能力,帮助用户解决更多类型的问题。
可以预见,2024年是大模型落地应用的元年,在推理模型的赋能下,2025年将是AI进一步提质增效的一年。
本文由人人都是产品经理作者【Alter】,微信公众号:【Alter聊科技】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自Unsplash,基于 CC0 协议。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。