








在数字化转型的浪潮中,AI大模型正成为重塑数据分析和自动化流程的关键技术。本文深入探讨了如何运用AI大模型构建高效、准确的数据机器人,通过对比传统NLP技术和现代AI大模型的应用,揭示了不同方法的优势与挑战。
我19年在蚂蚁的时候独立起了个项目,当然这个项目整体是个业务归因分析的平台,但是在这里面我采用了一种新的数据分析的用户交互方式,就是通过钉钉以IM进行问答式的分析交互。简单说就是想看什么样的数据,以及分析和归因都可以通过自然语言的方式进行提问,然后会返回具体的结果。
给大家个示例:
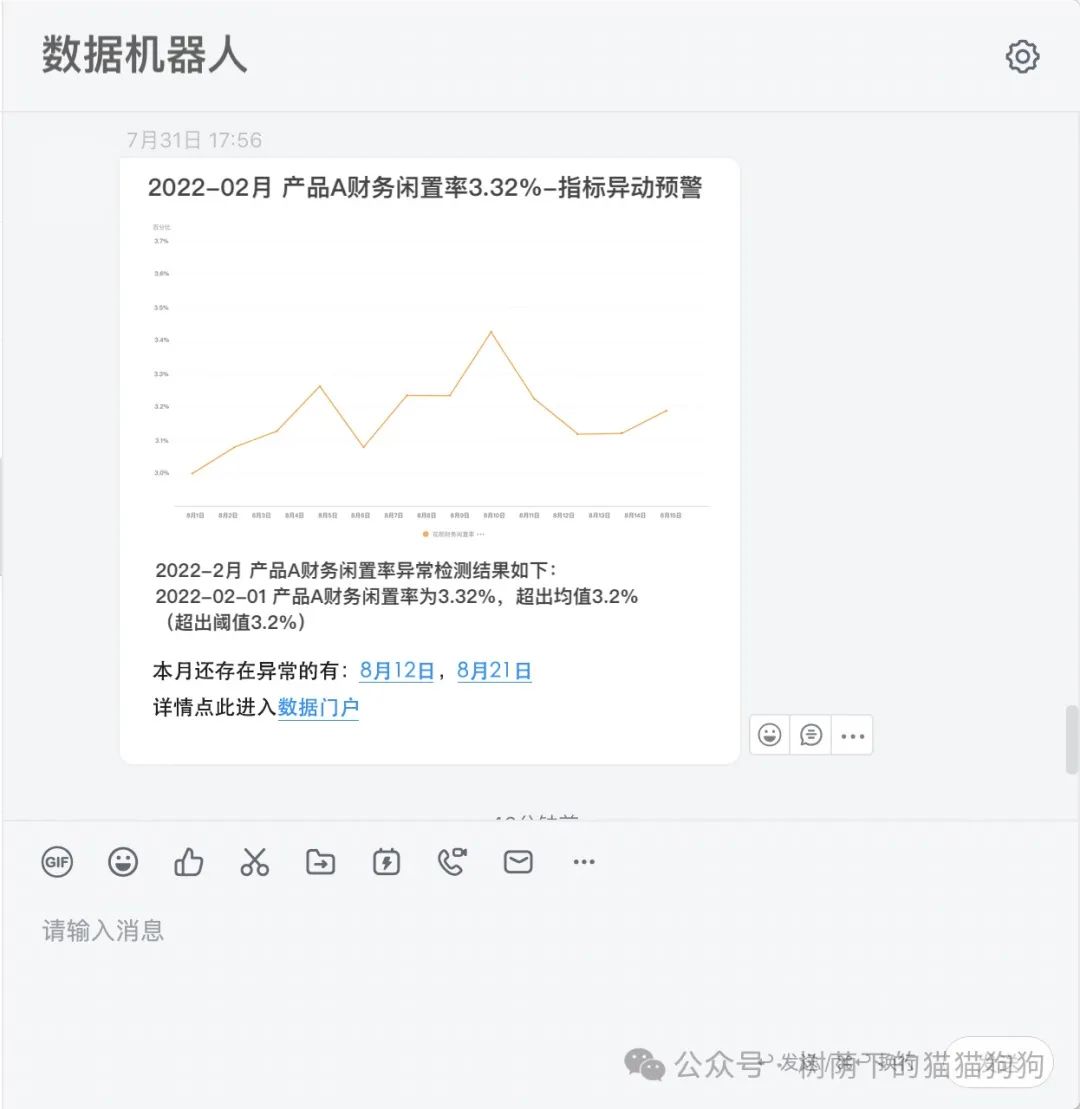
数据机器人示例-就像这样支持用户进行自然语言交互
在今天看起来是不是非常像AI大模型?如果那时候有大模型的加持肯定过会事半功倍,当时采用的方法是非常复杂的,不过也有其优点就是能保证数据的准确性。
今天就来教大家如何构建问答式的数据机器人,以及两种方式各自的优劣。
我之前的方式是采用:NLP分词+知识图谱的方式(在增强分析领域,可以称为NLQ-Natural Language Query)。这个过程是通过NLP解析用户自然语言的问题转换为SQL,然后通过SQL在对应的指标图谱中通过多维指标的数据关系进行指标汇总,最后返回给用户数据结果。
查询过程:用户自然语言查询→NLP→SQL→查询指标图谱→数据聚合→图表和数据返回
这里面NLP其实核心是在做分词,把时间、维度和指标名解析出来,因为在查询时是基于指标模型(时间周期+修饰词+原子指标)进行的,所以只要有查询的指标结构就可以做到。NLP解析出来后生成的SQL更多的是在做简单查询,假设用户要查询「今日杭州新注册用户数」的话,对于SQL来讲就是直接查询这个指标(select ‘杭州新注册用户数’ where day=‘今天日期’),但其实这个指标是通过知识图谱(指标图谱)的图关系把「今日」、「杭州」和「新注册用户数」这几个实体和关系的数据进行聚合。
所以复杂关系的指标数据聚合其实是在知识图谱完成的,因为如果让NLP解析后直接生成复杂SQL的话在那个时候技术并不成熟,当然对于今天的大模型来说生成复杂的SQL语言是小菜一碟。
去年也就是23年初大模型火热的时候我就在思考这个问题,如果通过大模型来实现是否可行,这取决于大模型的NLQ能力——对指标与分析相关的自然语言的理解以及转化为SQL的准确性。因为如果通过大模型的方式来实现的话,取代的是“NLP→SQL→查询指标图谱”这个流程环节,同时也就不需要构建复杂的知识图谱了,只需要像数仓中间层正常构建多维的指标数据宽表就够了,因为派生指标的聚合其实是在大模型中生成的复杂查询SQL。令人兴奋的是,大模型的编程语言能力比想象的更强。
首先在大模型中设置提示词(Prompt):声明数据表结构(表元数据信息)→声明查询方式→生成SQL
完整机器人交互查询过程:用户IM自然语言查询→大模型NLQ→查询指标模型表→图表和数据返回
(这个过程和前面的对比你会发现大模型取代了「NLP分词」、「SQL生成」和「知识图谱构建」这几个很复杂的环节。)
因为我们整个数据指标核心还是依托指标模型(时间周期+修饰词+原子指标),所以在提示词声明表的元数据信息以及查询方式时可以把表相应的字段约束一下,比如——“时间”是哪个字段,基于时间聚合的话方式是怎样的(时间已经按照时间周期标签化了,比如:近1天、近7天。还是字段存储的是日期,需要根据日期进行筛选后聚合),以及度量(原子指标)是哪个字段。
当然这些工作也可以不做,就相当于把准确性这个东西转嫁给了大模型,我测试过ChatGPT以及国内的大模型,我们只要把表的元数据信息——字段、字段类型、字段中文描述、分区以及分区存储类型(增量 or 存量),这些通过提示词声明好,我们在通过自然语言查询的时候生成的SQL准确性很高(因为大模型会根据你的字段描述以及元数据信息去进行自动判断)。但是对于成熟产品交付来讲,我们通过这个约束的目的是减少错误率。
不做提示词约束时大模型NLQ的实例:
比如这个就是我之前测试大模型NLQ时的一个实例,这个实例中我没有进行过多的提示就只是声明了一下表结构,大模型就能比较好的理解以及帮我生成SQL。
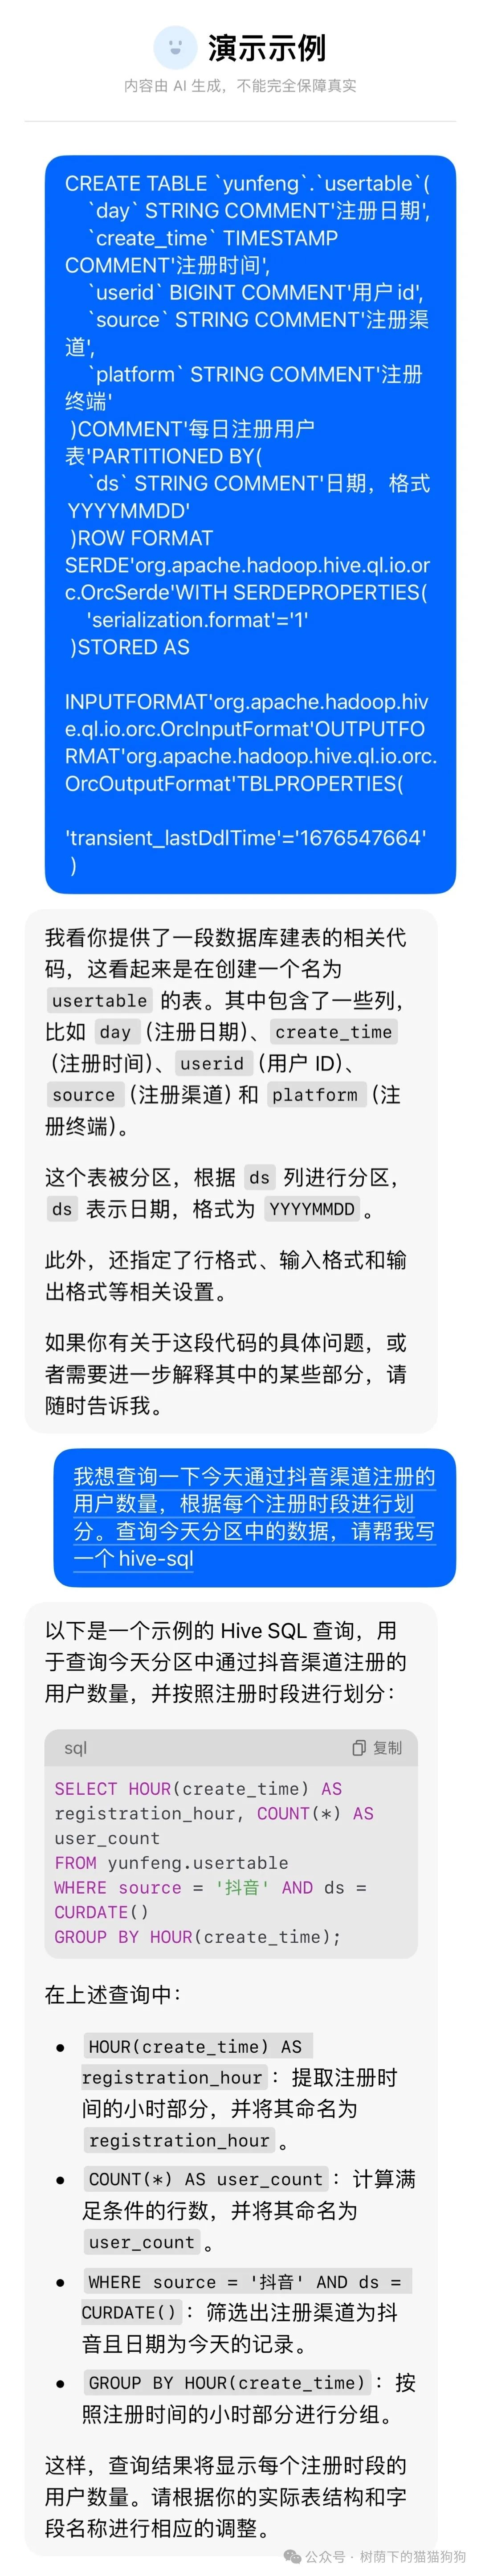
与国内某大模型的NLQ对话截图
这个用户明细表如果变成指标模型的多维表的话,表结构如下:
日期 | 注册渠道 | 注册终端 | 注册用户数(度量)
即使是变成这样的指标模型表结构的话数据形式也是有多样的,比如:
第①种:
近1天 | 微信 | App | 1000
近7天 | 微信 | App | 26000
第②种:
20240910 | 微信 | App | 1000
…
20240904 | 微信 | App | 6000
像上面我列出的这两种数据格式对于指标查询的处理就会有区别:
–第①种
select 注册用户数 where 日期=‘近7天’
–第②种
select sum(注册用户数) where 日期 between ‘20240904’ and ‘20240910’
当然上面这两种数据结构的前置数据处理逻辑也有区别,所以会有不同。我这里给大家举这个简单的例子是想说明,不同公司对指标数据的处理逻辑是不同的,要根据实际逻辑去看应该用什么样的查询方式,然后在提示词中进行声明和约束,否则就会导致数据口径出错的问题。
对于后一种利用大模型的方式进行构建(我们称为v2,前者是v1),很明显的要简单很多,容易实现,甚至说不需要太多的技术含量。但是这里面总会暗含着不确定性,也就是大模型在NLQ的过程中会不会搞些幺蛾子,这个在我们使用大模型的时候就很有体会,猛不丁的给你造个出人意料的东西出来(比如在这里就是出人意料的SQL查询逻辑)。
毕竟用户看的是数据结果,中间是黑盒,有时候结果很难察觉是否除了问题。所以就像总有一个苍蝇在你嘴边飞,不知道哪天就被吃进去了…所以就只能尽可能多的约束,但是约束是约束不了生成诡异的SQL代码逻辑的。
但是对于前一种方式(v1)来说,出错会意味着查询失败,但不会有“惊喜”!因为这里面主要可能出错的是在NLP分词的环节,分词分不好最多是维度、指标的错误和缺失之类的,把这些分词结果加到SQL中进行查询最多就是没有数据结果,而不会“一本正经的胡说八道”。
所以说v1版本的:
优势是——可以确保查询出的数据的准确性。
缺点是——构建复杂,会有很大的技术壁垒,比如知识图谱。
所以研发用时会很久,对于一般效率的研发来讲至少要4-6个月的时间才能有产品的mvp。
v2版本的:
优势是——可以很快速的把产品研发上线,甚至mvp版本2周应该就差不多。
缺点是——你要容忍暂时无法解决的“惊喜”,问题是这种惊喜还不容易发现和监控,甚至不容易察觉。
有的时候如果你的数据产品数据准确性像中奖一样且无法解决,对于需要可靠性的场景就直接被pass。但是从另一个角度来说,有很多对数据准确性没有那么严格,但是对取数效率比较重视的场景就是一个很好的产品。并且其实可以通过多次的查询以及经验去做简单的验证和判断。
毕竟对于这么炫酷好用的东西,很多老板可以暂时容忍一些小缺点的是吧!
以下是一些补充信息
本文中涉及到的一些专业名词解释:
本文涉及到的一些核心专业知识点:
指标模型的构建——文中指的是两方面:
①一方面是指标抽象的构成方式「时间周期+修饰词(维度)+原子指标」;
②另一方面是指的基于这种构成方式,数据表模型的构建。
专栏作家
戏说猫狗,公众号:树荫下的猫猫狗狗,人人都是产品经理专栏作家。前BAT数据产品经理,专注于数字营销Martech与智能风控领域,从事企业数据中台、数据智能化转型与产品解决方案。
本文原创发布于人人都是产品经理,未经许可,禁止转载
题图来自 Unsplash,基于 CC0 协议
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。