




GPT-5.1在CL-bench测试中仅获23.7%得分,却已是前沿AI模型中的最佳表现。腾讯混元与复旦团队发布的这个全新基准测试,揭示了AI在真实场景学习能力的致命短板:它们更擅长背诵而非真正学习。本文深度解析CL-bench如何颠覆行业认知,以及这对AI未来发展方向的关键启示。

23.7%。
这是GPT-5.1 (High)在CL-bench基准测试中的得分。
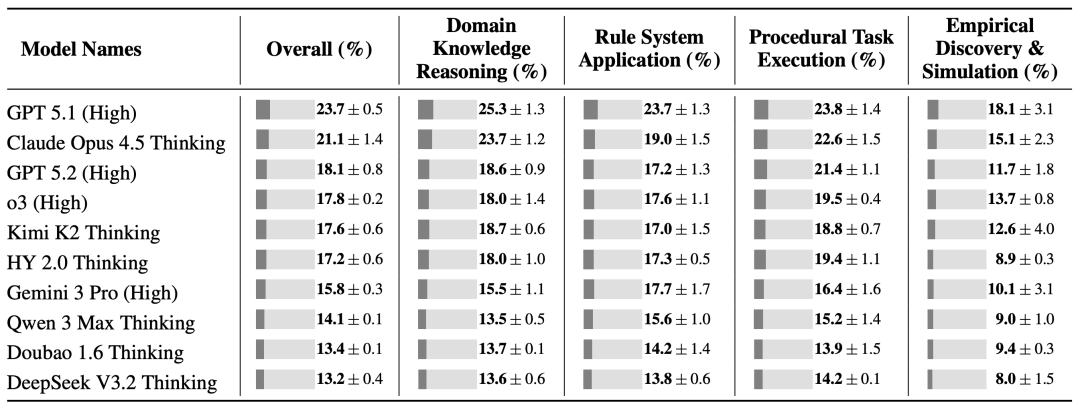
但这个低分,却是GPT、Claude、Gemini、Kimi、Qwen这些前沿模型中的最好成绩,这些模型平均分仅为17.2%。
CL-bench是腾讯混元团队与复旦联合团队最新发布的基准测试,专门评测语言的上下文学习能力。
它的目的验证模型在真实世界工作的能力。
不要去卷什么乱七八糟的参数,来试试当个生活做题家。
毕竟只有AI能够解决生活中杂乱、动态变化的场景,才能真正地成为人类的助手。
CL-bench的测试范围有哪些
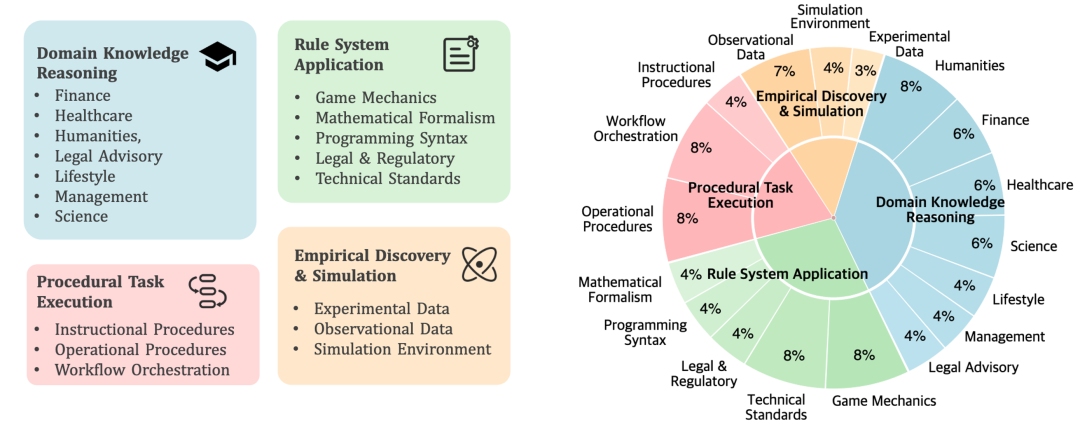
CL-bench 涵盖了四种广泛的现实世界 context 学习场景,包括:领域知识推理、规则系统应用、程序性任务执行、经验发现与模拟。
它拥有由资深领域专家精心制作的 500 个复杂 context 、1,899 个任务和 31,607 个验证标准。
CL-bench只包含一个简单但苛刻的要求:模型必须从上下文中学习到模型预训练中不存在的新知识,并正确应用去解决问题
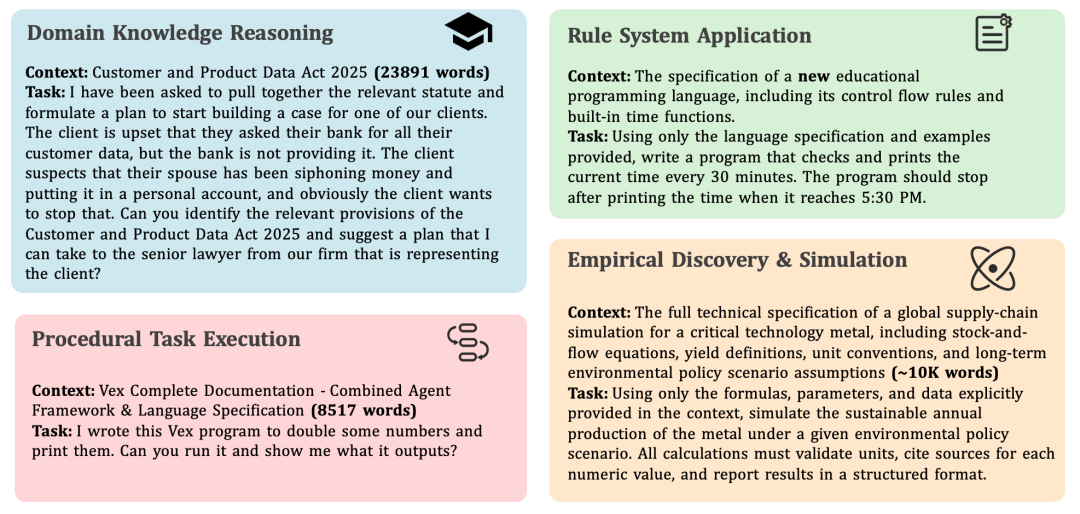
例如构造了虚假的法律体系,新的编程语法,让模型判断什么情况要用什么条款,要怎么写代码。
还提供了复杂的工作流和操作指南,让模型去完成任务,最复杂的是从实验数据、观测记录或模拟环境挖出潜在的定律或结论
CL-bench的测试结果
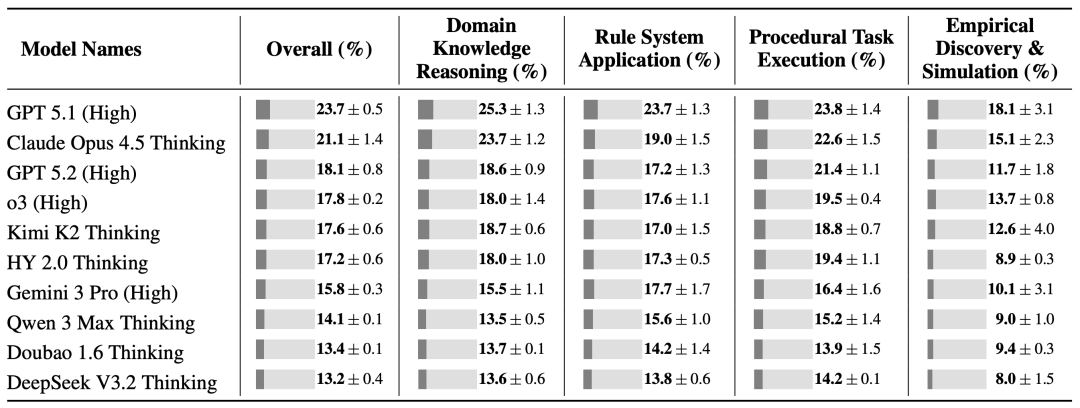
从结果上看,平均每个模型只能解决了17.2%的任务。
AI拥有了每个任务的全部信息,但还是在绝大多数任务中失败了,在没有见过的场景里它似乎没有真正的学习能力。
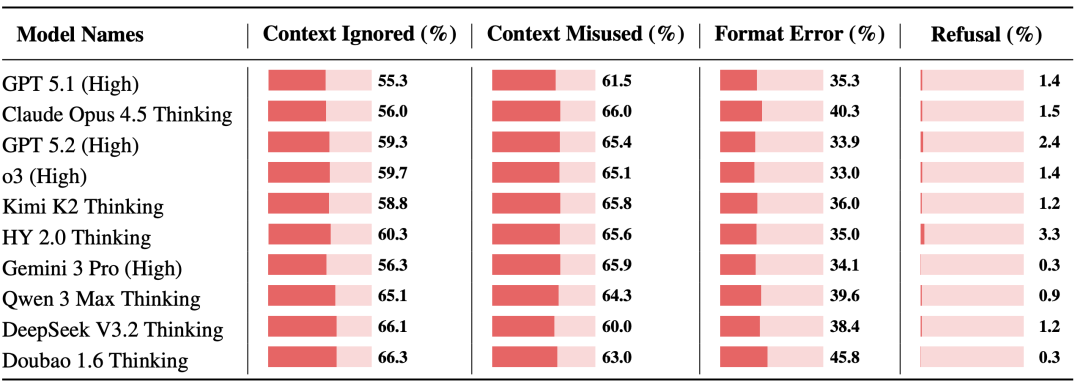
根本原因是:模型在背诵答案,而不是解决问题。
它拿到题目后,第一反应不是仔细阅读context里的新规则、新流程,而是赶紧去自己预训练的知识里看看有没有类似的东西?
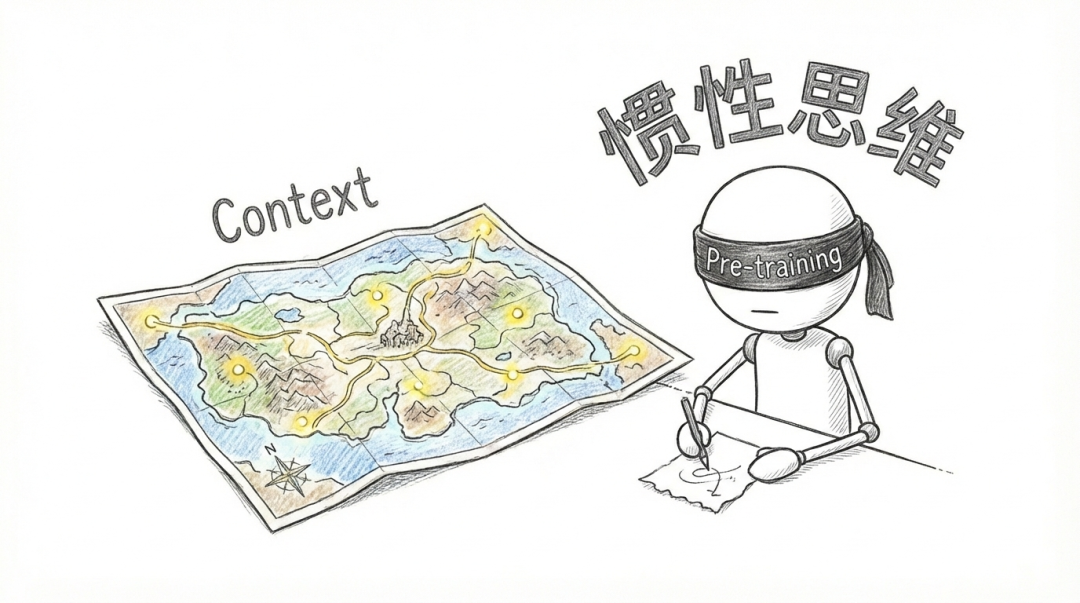
尝试用旧知识解决新的问题本就很容易失败,哪怕context里明明白白写着这是一套全新的规则,它也很容易视而不见。
CL-bench的新发现
过去几年业界的主流认知,人们普遍认为提供足够上下文,模型就能解决问题。
但CL-bench告诉我们当前模型更像是参数推理者,擅长依赖预训练的过去的静态知识,却不擅长从当下环境中吸收新信息。
真正的上下文学习者应该能够从眼前提供的上下文中提取新知识并灵活应用。
能处理长输入,不代表会从中学习。
我们需要模型能够做长上下文推理和指令遵循,但这两件事还不够,还需要学习能力,否则一样达不成任务。
归纳推理是从一堆数据里自己总结规律,或者在虚拟环境里摸索出路,这远比简单的照着说明书做要困难。
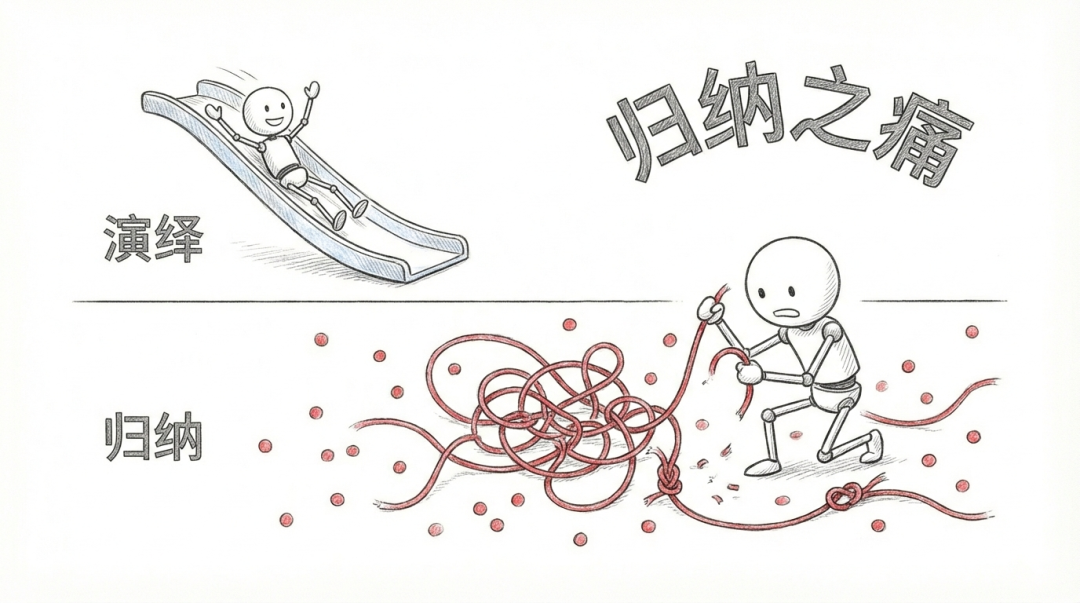
模型在归纳任务上的表现明显较差,任务解决率通常低于 10%,而且结果波动极大。毕竟发现规律,远比应用规律要难。
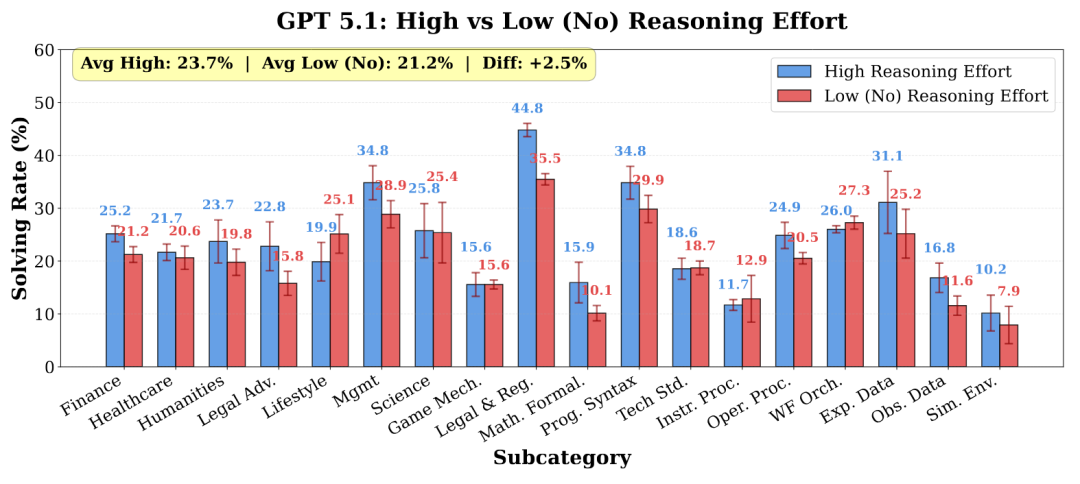
至于推理强度,确实对部分模型有帮助。
GPT-5.1在管理类和实验数据类任务上,提高推理强度后表现提升了约6%,但其他模型提升有限,甚至可能下滑。
大力出奇迹的时代已经过去了。
前不久姚顺雨老师在AGINEXT峰会时就提出了一个核心观点:
我们发现很多时候我们的环境来讲或者更强的模型,或者很强的模型,很多时候是额外的Context。
数字生命卡兹克,公众号:数字生命卡兹克唐杰、杨植麟、姚顺雨、林俊旸罕见同台分享,这3个小时的信息密度实在太高了。
CL-bench论文发布,用数据把这个观点实证化了。
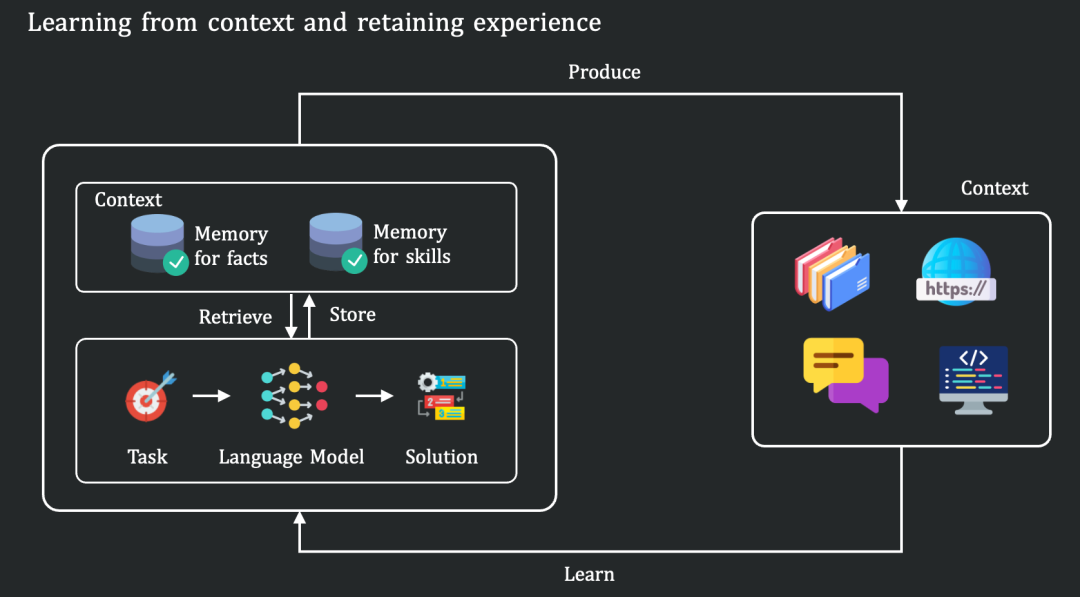
对 AI 行业来说,游戏的规则改变了。
以前拼的是谁能把模型训练得更聪明,以后拼的是谁能提供更丰富、更精准的Context。
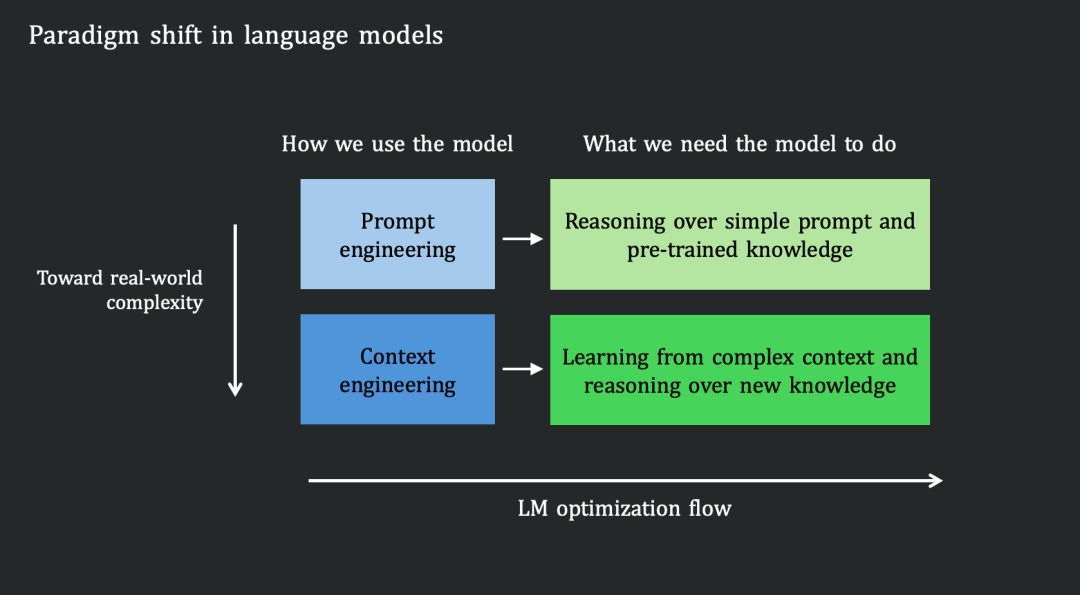
而未来可能会从提示词工程专项上下文工程,从依赖预训练数据让模型变好,转向于从上下文学习来让模型变好。
当上下文爆炸,考验的又会变成提炼和记忆,怎么从记忆里去提炼有价值的信息,用什么机制来对抗遗忘,这些会变得越来越关键。
AI的上半场,我们造出了能解奥数题、能过专业考试的做题家。到了下半场,我们需要的变成了能从真实环境中学习、成长的学习者。
声明:部分图片为AI生成
参考资料:
1)https://www.clbench.com/
2)https://hy.tencent.com/research/100025?langVersion=zh
作者:Wise,公众号:Becomewiser
本文由 @Wise 原创发布于人人都是产品经理,未经许可,禁止转载。
题图来自Unsplash,基于CC0协议
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。