






轰轰烈烈的百模大战硝烟渐散,当人们开始讨论闭源模型格局初定时,2024年,不得不说开源大模型给整个技术圈带来了不少新的惊喜。

开源大模型,已经开启大卷特卷模式。
全球范围,太平洋两岸,双雄格局正在呼之欲出。
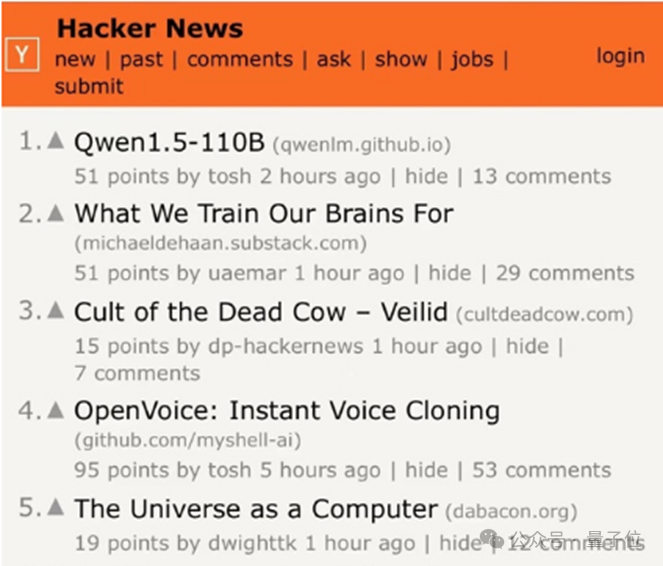
Llama 3中杯大杯刚惊艳亮相,国内通义千问就直接开源千亿级参数模型Qwen1.5-110B,一把火上Hacker News榜首。
不仅相较于自家720亿参数模型性能明显提升,在MMLU、C-Eval、HumanEval等多个基准测试中,Qwen1.5-110B都重返SOTA开源模型宝座,超越Llama 3 70B,成最强开源大模型。

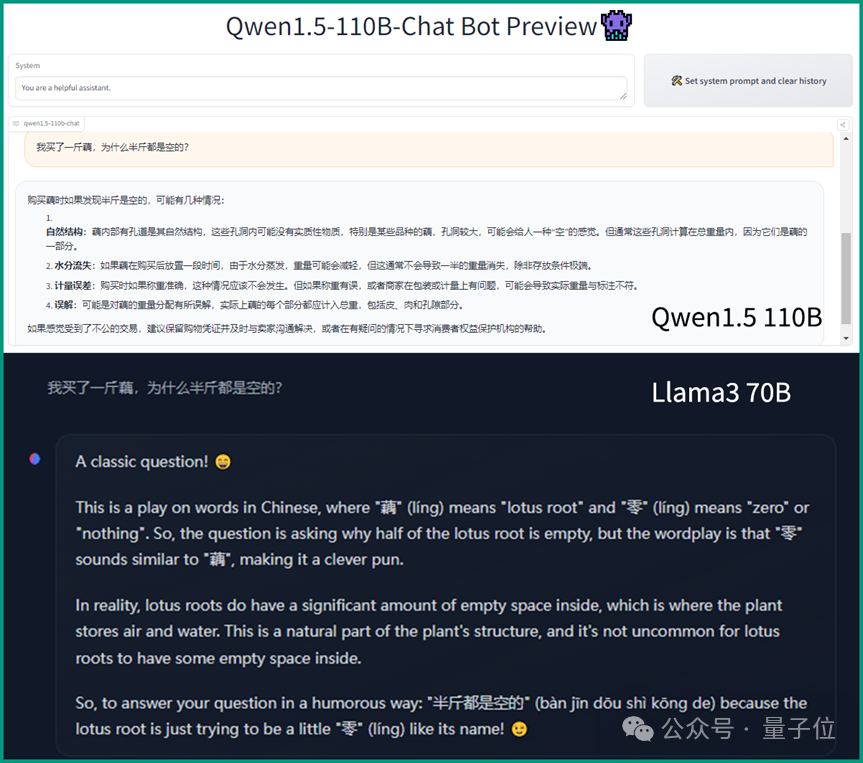
中文能力方面,对比仅喂了5%非英文数据的Llama 3 70B,Qwen1.5-110B更是优势明显。
于是乎,模型一上线,开源社区已经热烈响应起来。
这不,Qwen1.5-110B推出不到一天,帮助用户在本地环境运行创建大语言模型的Ollama平台,就已火速上线链接。

值得关注的是,这已经是3个月内通义千问开源的第8款大模型。开源大模型都在卷些什么?
那么,问题来了,因Llama 3和Qwen1.5接连开源而持续的这波开源大模型小热潮中,开源模型又在卷些什么?
如果说上一阶段由马斯克Grok和Mixtral所引领的话题热点是MoE,那网友们这一两周内聚焦的第一关键词,当属Scaling Laws——尺度定律
OpenAI创始成员、前特斯拉AI总监Andrej Karpathy在总结Llama 3时,就着重提到过其中尺度定律的体现:
Llama 2在2T token数据上训练,而Llama 3直接加码到了15T,远超Chinchilla推荐量。并且Meta提到,即便如此,模型似乎依然没有以标准方式“收敛”。

也就是说,“力大砖飞”这事儿还远没有达到上限。
无独有偶,Qwen1.5-110B延续了这个话题的讨论。
官方博客提到,相比于Qwen1.5-72B,此次开源的千亿参数模型在预训练方法上并没有太大的改变,但包括编程、数学、语言理解、推理在内的各项能力提升明显。
我们认为性能提升主要来自于增加模型规模。
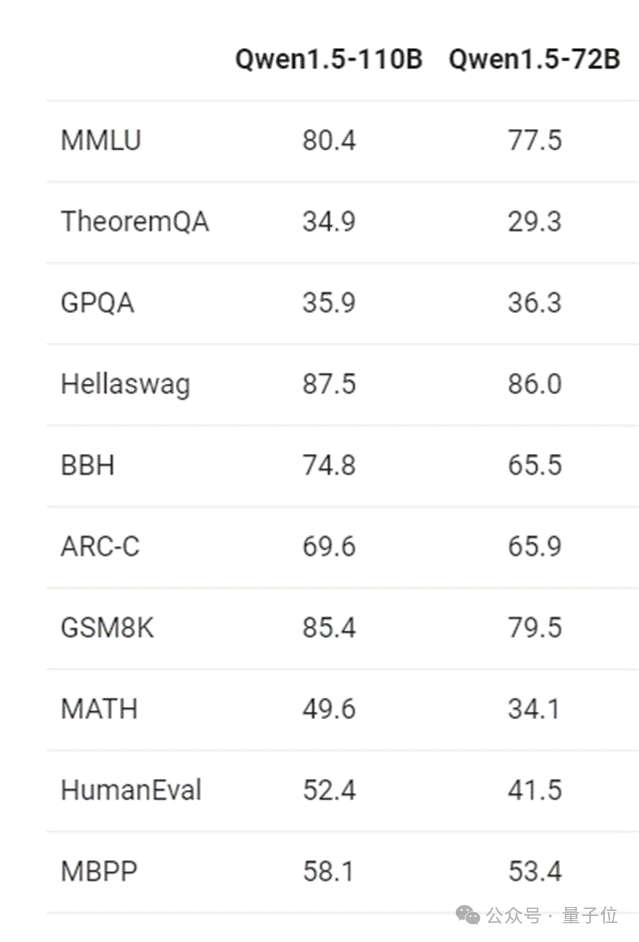
更强大、更大规模的基础语言模型,也带来了更好的Chat模型。

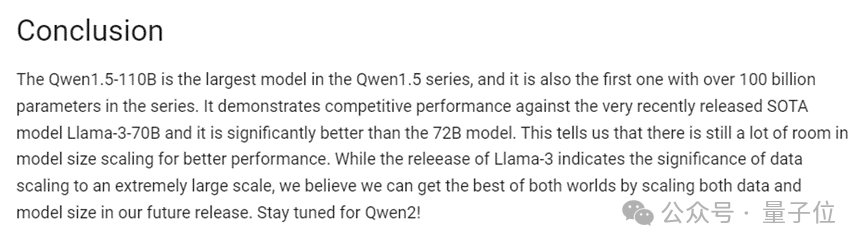
阿里的研究人员们指出,Qwen1.5-110B的评测成绩意味着,在模型大小扩展方面仍有很大的提升空间。
官方还浅浅剧透了Qwen 2的研究方向:同时扩展训练数据和模型大小,双管齐下。
尺度定律之外,由闭源模型掀起的长文本风潮,同样在开源模型身上被重点关注。
Llama 3的8K上下文窗口,就遭到了不少吐槽:实在有点“古典”。
Qwen1.5-110B在这方面延续了同系列模型的32K上下文。在此前的测试中,长文本能力测试结果显示,即使是Qwen1.5-7B这样的“小模型”,也能表现出与GPT3.5-turbo-16k类似的性能。

并且,开源的优势就是敢想你就来。
Qwen1.5官方博客中提到,虽然纸面给的是32K吧,但并不代表模型的上限就到这儿了:
您可以在config.json中,尝试将max_position_embedding和sliding_window修改为更大的值,观察模型在更长上下文理解场景下,是否可以达到您满意的效果。
另一个由通义千问而被cue到的大模型能力评判指标,就是多语言能力。
以Qwen1.5-110B为例,该模型支持中文、英文、法语、西班牙语、德语、俄语、韩语、日语、越南语、阿拉伯语等多种语言。
阿里高级算法专家林俊旸分享过通义千问团队内部收到的反馈:实际上,多语言能力在全球开源社区中广受欢迎,正在推动大模型在全球各地的落地应用。
而Qwen1.5在12个比较大的语言中,表现都不逊于GPT-3.5。

对于中文世界而言,这也是国产开源大模型的优势所在。
毕竟Llama 3强则强矣,训练数据方面中文语料占比实在太少(95%都是英文数据),单就中文能力而言,确实没法儿拿来即用。

相比之下,Qwen1.5 110B的中文实力就靠谱多了。
能让歪果仁瞬间抓狂的中文水平测试,轻松拿捏:
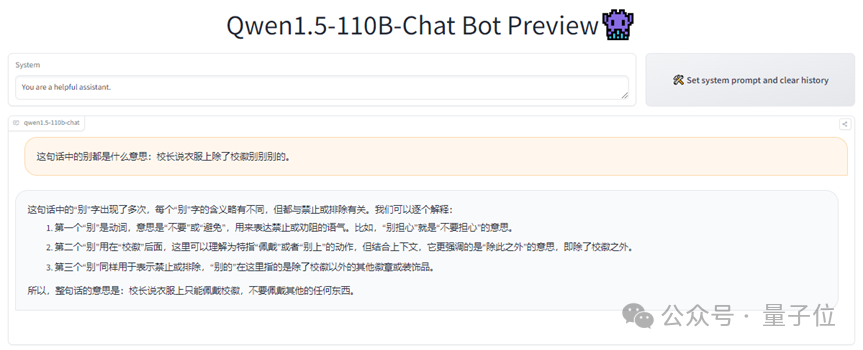
弱智吧Benchmark,也能应对自如:

此外,还有不少网友提到了开源模型型号丰富度的问题。
以Qwen1.5为例,推出不到3个月,已经连续开源8款大语言模型,参数规模涵盖5亿、18亿、40亿、70亿、140亿、320亿、720亿和1100亿,还推出了代码模型CodeQwen1.5-7B,和混合专家模型Qwen1.5-MoE-A2.7B。
随着大模型应用探索的不断深入,业界已经逐渐达成新的共识:在许多具体的任务场景中,“小”模型比“大”模型更实用。
而随着大模型应用向端侧的转移,丰富、全面的不同型号开源模型,无疑给开发者们带来了更多的选择。
如同大洋彼岸OpenAI引领闭源模型发展,而Meta靠开放权重的Llama系列另辟蹊径,在国内,阿里正是大厂中对开源大模型态度最积极的一家。
从Qwen到Qwen1.5,再到多模态的Qwen-VL和Qwen-Audio,通义千问自去年以来可谓开源消息不断。仅Qwen1.5系列,目前累计已开源10款大模型。

阿里官方,也已直接亮明“把开源进行到底”的态度。这在卷大模型的互联网大厂中,确实是独一份。
所以,阿里坚持走开源路线,背后的底层逻辑是什么?
或许可以拆解为以下几个层面来分析。
首先,在技术层面,尽管以GPT系列、Claude系列为代表的闭源模型们目前占据着领先地位,但开源模型也“步步紧逼”,不断有新进展惊艳科技圈。
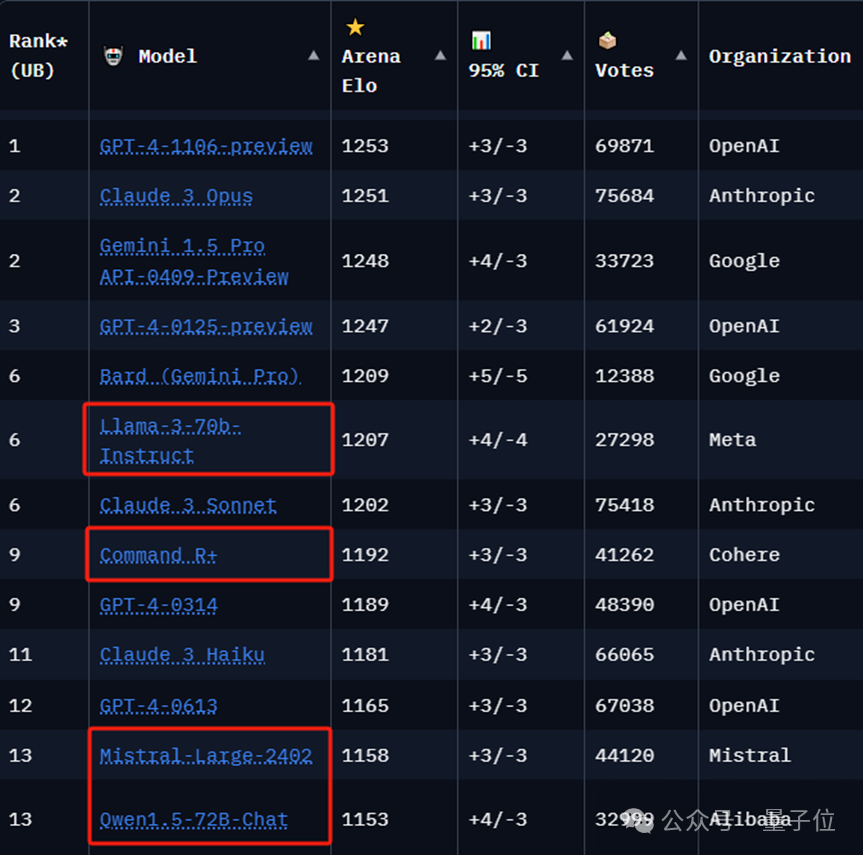
图灵奖得主Yann LeCun就曾援引ARK Invest的数据认为“开源模型正走在超越闭源模型的道路上”。

ARK Invest当时预测,在2024年,开源模型会对闭源模型的商业模式构成挑战。
而随着Llama 3为标杆的新一波开源大模型的爆发,越来越多的业内专家也开始期待,强大的开源模型“会改变很多学界研究和初创公司的发展方式”。

值得一提的是,开源模型独特的一重优势在于,来自开源社区的技术力量,同时也反哺了开源大模型的发展。
林俊旸就在量子位AIGC产业峰会上分享过,通义千问32B的开源,就是在因开发者们的反馈而推动的。
其次,在应用落地层面,开源大模型无疑起到了加速器的作用。
开源社区的热情就侧面佐证了开发者们把基础模型的控制权把握在自己手中的倾向性。
以通义千问为例,在HuggingFace、魔搭社区的下载量已经超过700万。
更实际的落地案例,也正在各行各业中持续实现。
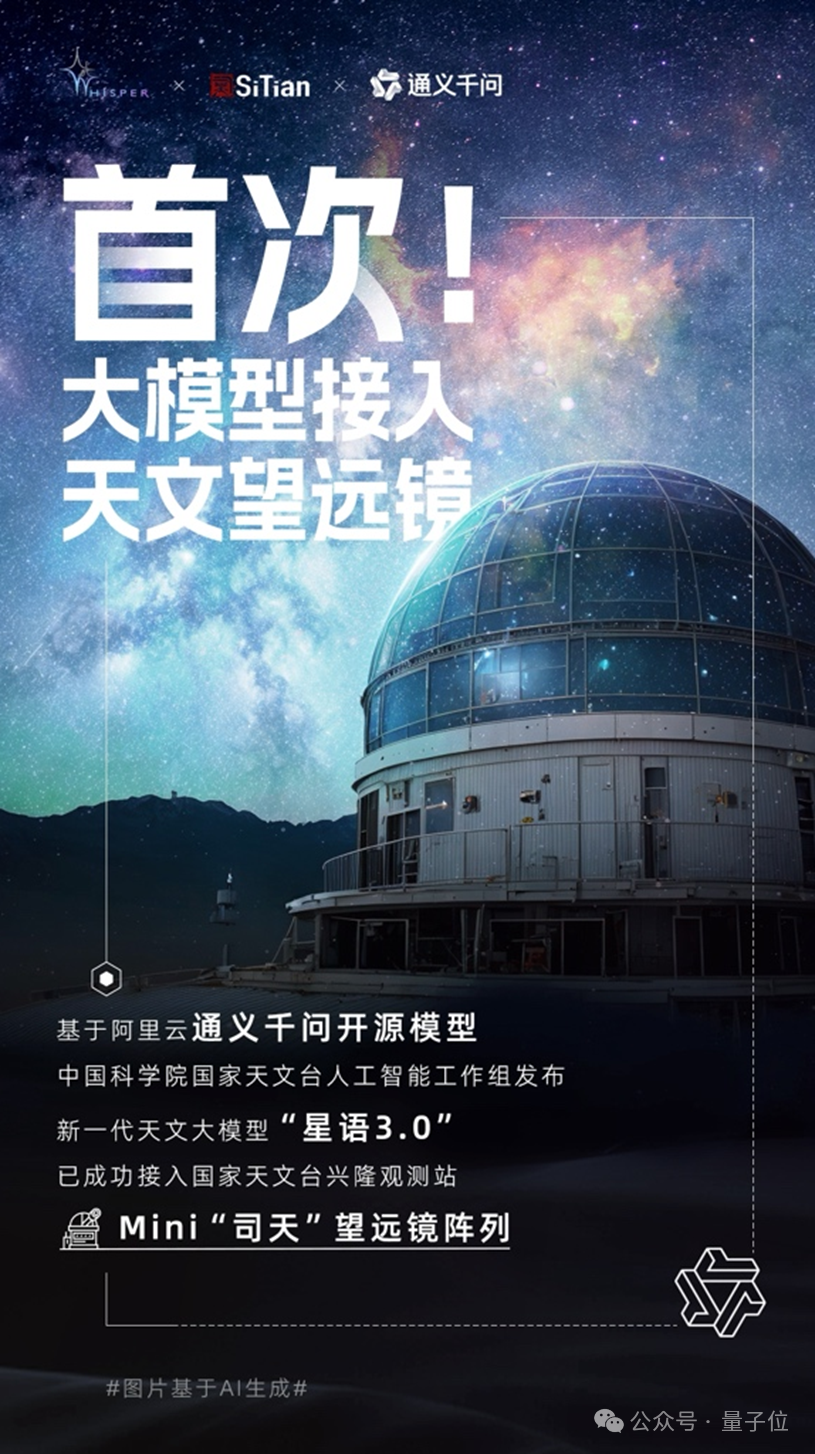
比如,中国科学院国家天文台人工智能组,就基于通义千问开源模型,开发了新一代天文大模型“星语3.0”,将大模型首次应用于天文观测领域。
而对于推动开源的企业而言,打响的也不仅仅是名气和在开发者社区中的影响力。
通义千问的B端业务,也正因开源而加速。
最新消息是,通义大模型不仅“上天”,现在还“下矿”了。
继西部机场集团推出基于阿里云通义大模型打造的首个航空大模型后,西安塔力科技通过接入阿里云通义大模型,打造了新型矿山重大风险识别处置系统,并已在陕煤建新煤矿等十余座矿山上线,这是大模型在矿山场景的首次规模化落地。
目前,新东方、同程旅行、长安汽车、亲宝宝等多家企业均已宣布介入通义大模型。

轰轰烈烈的百模大战硝烟渐散,当人们开始讨论闭源模型格局初定时,2024年,不得不说开源大模型给整个技术圈带来了不少新的惊喜。
而随着大模型应用开始成为新阶段探索的主旋律,站在开发者、初创企业、更多非互联网企业的角度而言,以Llama、通义千问等为代表的开源大模型越强,垂直行业结合做行业大模型的自由度就会越高,落地速度也会越快。
过去互联网的繁荣建立在开源的基础之上,而现在,在大模型风暴中,开源大模型再次显现出鲶鱼效应。
自研大模型的必要性和竞争力,正在不断被开源卷王们卷没了。
本文由人人都是产品经理作者【量子位】,微信公众号:【量子位】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自Unsplash,基于 CC0 协议。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。